
OpenAI承诺:其芯片Jalapeño将比竞争对手的方案更快、更经济
该公司声称,与博通联合开发的推理处理器在多项AI模型测试中,其能效和响应速度均优于英伟达的加速器。计划于今年年底前小规模部署该芯片,但无意完全替换英伟达的产品线。
OpenAI押注Jalapeño芯片:更快、更省电,而且即将上市
当谈到部署大型语言模型时,工程师们常常需要在性能之间做出权衡:要么系统响应极快,但难以承受高并发请求;要么能够处理海量负载,但代价是明显的延迟。OpenAI相信他们找到了能消除这一矛盾的解决方案。据开发方称,该公司自研的芯片Jalapeño同时实现了低延迟和高吞吐量。OpenAI硬件副总裁理查德·霍表示,这款新品提供了“两全其美”的方案。
Jalapeño并非通用处理器,而是一款与博通合作打造的定制专用集成电路(ASIC)。该芯片专为特定任务而生——推理,即直接运行已训练模型以执行任务和驱动智能体工作。这款芯片早在六月就已公布,如今首次公布了官方测试结果,公司毫不避讳地称其为革命性的。
性能测试显示了什么
为了评估芯片性能,OpenAI使用了自家的基准测试平台InferenceX。对比的基准是英伟达GB200和GB300超级芯片上记录到的最佳成绩。测试在三款热门模型上进行:GPT-OSS 120B、DeepSeek R1和Kimi K2.5 1T。
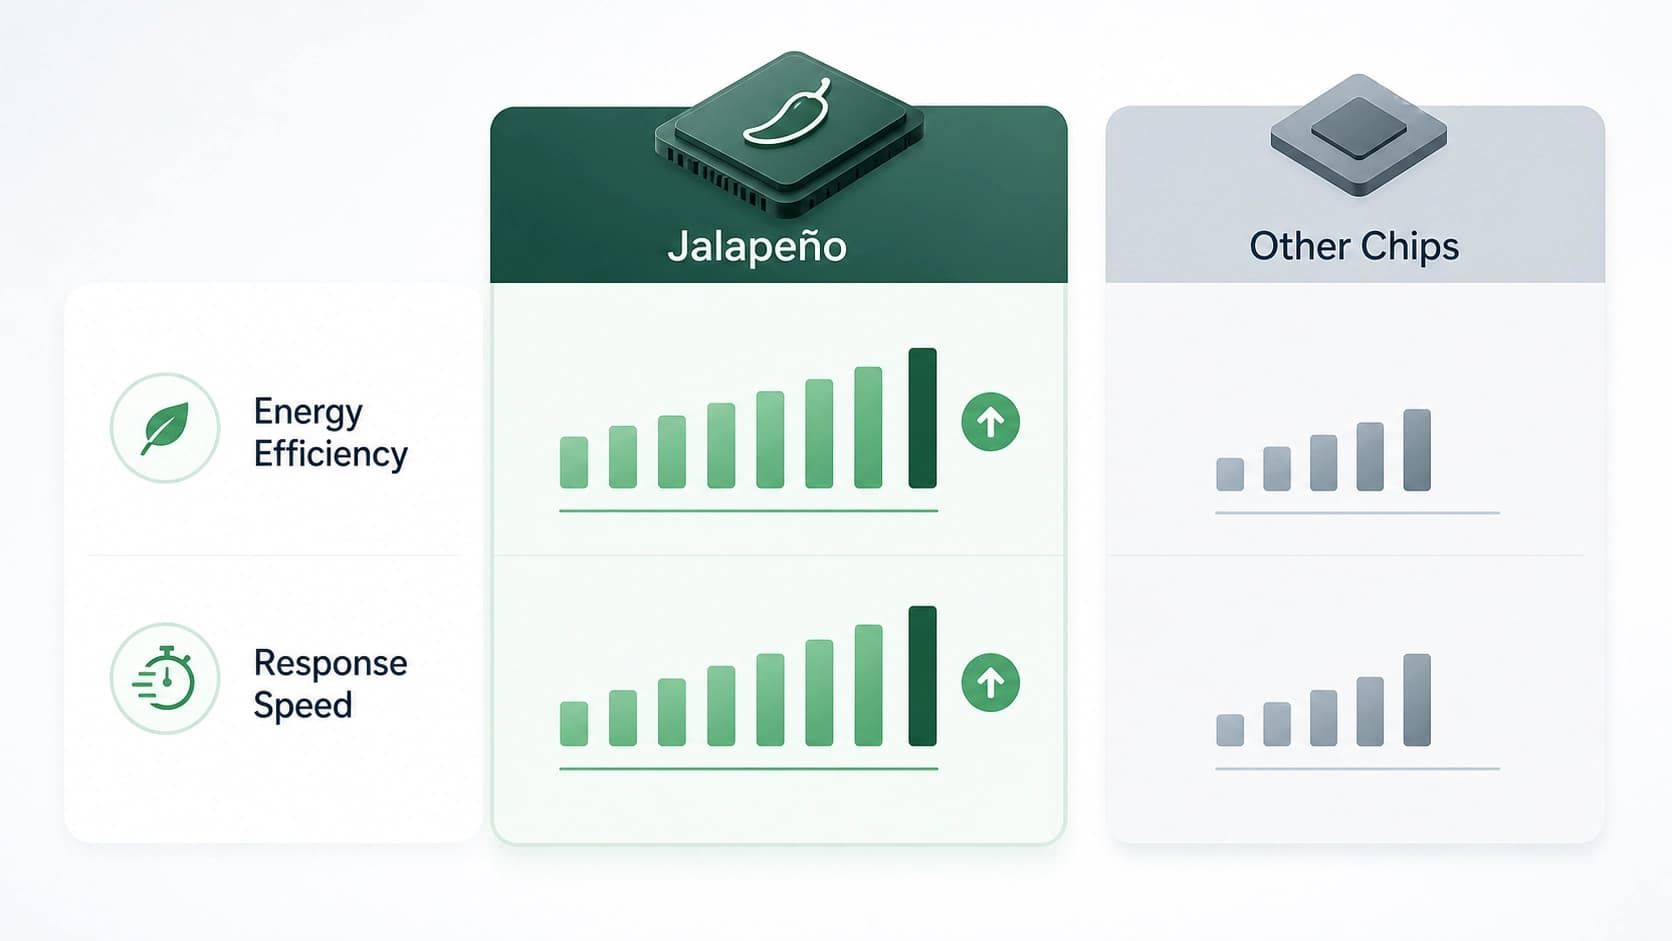
公司声称结果令人印象深刻。根据模型不同,Jalapeño每瓦特计算量比竞争对手的系统高出1.5至1.9倍。简而言之,这意味着每消耗一千瓦时电能,新芯片能完成更多有效工作。在数据中心电费成为主要开支之一的时代,这一点至关重要。
响应速度的差异更为显著。在三款测试模型上,端到端延迟比基于英伟达芯片的基准系统低1.7至3.6倍。在实际应用中,这意味着助手响应更快,AI智能体的动作更灵敏,即使在峰值负载下也能稳定访问服务。模型处理请求的速度越快,用户盯着“正在生成”指示器的时间就越短。
战略:不是替代,而是补充
尽管成绩如此亮眼,OpenAI并不打算终止与英伟达的合作。理查德·霍强调,公司的整体计算战略是采用广泛的合作伙伴,而英伟达仍是其中的关键一环。Jalapeño不会取代现有的芯片集群,而将成为扩展基础设施的重要一环。
第一代芯片计划在今年年底前以“小规模”部署。全面产能提升将于2027年开始。公司刻意不透露明年计划投入使用的芯片具体数量。与此同时,Jalapeño的第二代和第三代研发工作已经展开,这表明这是一个长期方向——不同于许多最终未能进入实际应用阶段的实验。
该项目的成功有望显著降低大型AI模型运营商对少数芯片供应商的依赖。自研ASIC能更精确地将架构与OpenAI的具体算法和工作负载相匹配,从而节省资源并加快新产品上市速度。
常问问题
相关材料
所有材料
RL 模拟器故障诊断中的规范多项式不变量:它们究竟在何处发挥作用
这项研究检验了将物理定律纳入可训练动力学模型是否合理:从轨迹中提取并通过 Gröbner 基化为规范形式的不变量,虽能小幅提升预测效果,却在诊断方面表现出色——它们能够定位被违反的约束,并找出具体的错误参数。
10 十一月 2026
AURA-Eval:如何验证 LLM 智能体识别了风险并调整了下一步行动
该框架评估 LLM 智能体在关键节点面对风险时的反应,而非最终判断:工具调用轨迹会被中断,随后模型必须继续推理并采取行动,LLM 评审团则分析其风险识别、行动性质与安全性。在从 157 条 R-Judge 轨迹中整理出的 1249 项任务上,对 20 个模型的评估显示,缺少安全路径时,不安全行为会增多;在执行前撤除监督,会使 52.3% 原本安全的案例转为不安全。
10 十一月 2026
陈-西蒙斯储层记忆:连通性的自主动力学与密度输运
本文探讨了储层如何同时在密度分布和几何自由度中保留输入信号的历史。对四种机制的比较表明,电流会形成一个独立的连通分量,改变密度的后续响应;而纳入所有测得的特征,则能在脉冲顺序解码方面带来小幅提升。
10 十一月 2026