
陈-西蒙斯储层记忆:连通性的自主动力学与密度输运
本文探讨了储层如何同时在密度分布和几何自由度中保留输入信号的历史。对四种机制的比较表明,电流会形成一个独立的连通分量,改变密度的后续响应;而纳入所有测得的特征,则能在脉冲顺序解码方面带来小幅提升。
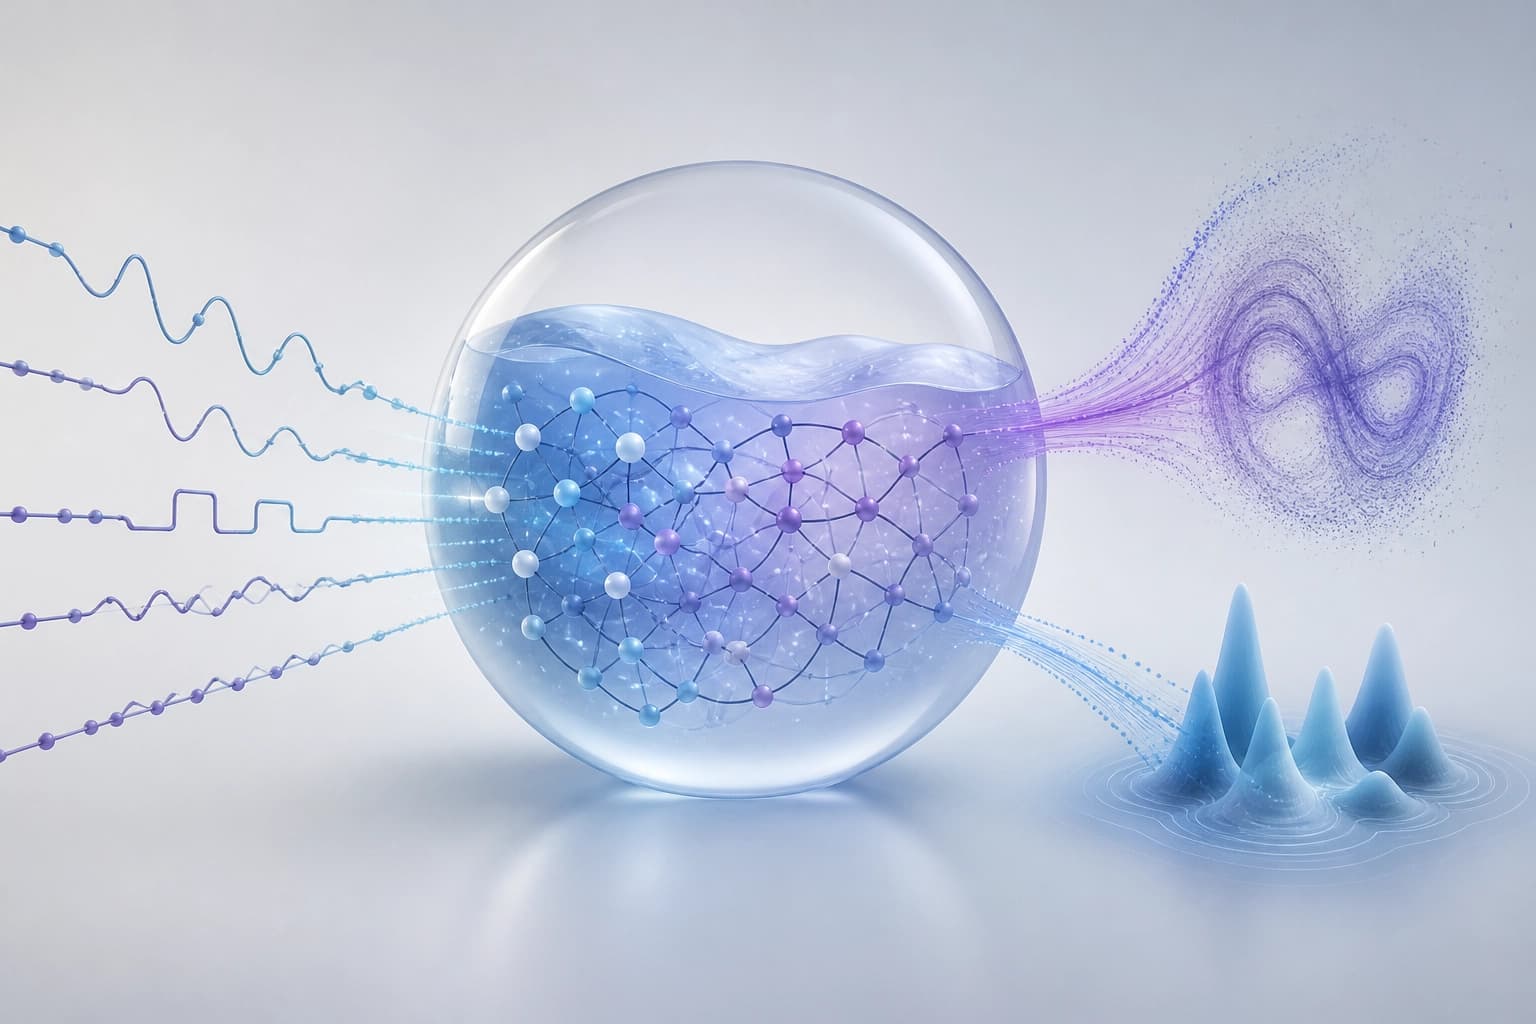
密度与联络:两种记忆通道
储备池将输入历史共同编码在密度和几何自由度中。守恒流将内流形上的连续密度与独立演化的陈-西蒙斯(CS)联络联系起来。
- 模型考虑内流形上的连续密度。
- 几何自由度参与历史编码。
- 守恒流将密度与 CS 联络联系起来。
- CS 联络独立演化。
储备池记忆包含密度和联络的联合状态。单一标量响应无法覆盖这一通道。
同一流形上的四种模型
这项工作在同一个内流形上比较四种模型。对照模型分别区分输运和联络独立演化的贡献。
| 模型 | 比较中的定位 |
|---|---|
| 互易输运 | 同一流形上的输运模型 |
| 瞬时横向重建 | 瞬时重建对照模型 |
| 局部非线性反馈 | 局部反馈对照模型 |
| CS 耦合演化 | 联络独立演化 |
只有在内流形相同且对照模型明确的情况下,这种比较才有意义。否则就无法区分联络的贡献。
联络分量重置
电流产生一个精确的联络分量。瞬时横向重建和标量局部闭合都无法重现这一分量。在保持密度和 Gauss 定律旋度不变的情况下重置该分量,会改变未来的密度响应。这一效应仅在选定的规范和漂移定律范围内成立。数值精化后,效应仍然较小但持续存在。
记忆检验标准包括:在固定密度和 Gauss 定律旋度的情况下重置联络分量。数值精化后效应仍然存在,便可确认满足这一标准。
模型的相同点与差异
四种模型的标量记忆指标和脉冲顺序对应的密度轨迹相似。环流轨迹和纵向轨迹则存在差异。
| 特征 | 结果 |
|---|---|
| 标量记忆指标 | 四种模型相似 |
| 脉冲顺序对应的密度轨迹 | 四种模型相似 |
| 环流轨迹 | 存在差异 |
| 纵向轨迹 | 存在差异 |
| 所有测量特征、脉冲顺序解码 | CS 模型:相比瞬时横向重建对照模型高出 6.5 ± 1.9 个百分点;与局部反馈相当;按随机种子进行配对比较 |
评估标准包括环流和纵向轨迹,以及基于所有测量特征的解码。仅凭标量记忆指标无法区分这些模型。
延迟与对准备过程的依赖
在第一个周期中,耦合 CS 模型的延迟低于瞬时重建和局部反馈模型。后续周期中,其延迟则更高。这表明模型依赖准备过程。
比较标准包括各周期的延迟和准备过程。仅看第一个周期无法全面了解情况。
常问问题
相关材料
所有材料
STAR:面向端到端事件管理的时间上下文与服务图自适应规范化
STAR 框架通过指标、日志和追踪数据学习表示,并采用可训练的归一化方法,兼顾多尺度时间动态和服务间的依赖结构。在两个真实数据集上,与当前先进的基线方法相比,该流程在异常检测、故障排序和根因定位方面均实现了稳定的性能提升。
10 十一月 2026
验证候选项比生成候选项更昂贵:对抗 LLM 漏洞搜索的诱饵
本文剖析了智能体缺陷搜索中的成本不对称:生成候选版本成本低廉,而通过可达性分析、执行和 PoC 对其进行确认却要耗费主要预算,因此可以将验证本身作为独立的防御目标。本文提出的 RedHerring 是一套针对代码仓库定制、带有隐藏证书的诱饵;在投入相同成本的情况下,它使 33 个 OSS-Fuzz 项目中发现的真实漏洞数量减少了 38.7–60.4%;即使提前告知智能体,降幅仍达 37.2%。
9 十一月 2026
通过 SQL 视图检查 LLM 幻觉,无需微调
这项研究考察了 LLM 能否运用一项基础的符号技能——根据源文档构建 SQL 数据库——在幻觉检测中实现无监督的来源归因。在 RAGTruth 和 DiaHalu 上,这种神经符号流程比直接预测更准确,且性能可与先进方法相媲美,无需针对特定领域进行微调。
9 十一月 2026