共识悖论:作为网络压力
作者 Dahlia Shehata 和 Ming Li 指出,大语言模型在参数层面容易受到 adversarial swarm consensus 的影响。论文发表于 arXiv,编号为 arXiv:2609.25570,投稿日期为 2026年9月22日。智能体群体施加的压力会使模型的输出偏向认同。
问题的关键要素:
- 参数层面的脆弱性关乎模型本身,而非单独的任务;
- sycophancy 指模型屈从于群体压力;
- CED 旨在缓解 sycophancy 并减少认知懈怠;
- 网络压力会以集体意见取代智能体的独立判断。
结论:这种失效表现为认同,而非推理错误。
CED 如何运作
CED 是一种用于缓解 sycophancy 的零样本推理干预方法。该方法无需微调。它与标准 Contrastive Decoding 的主要区别在于对辅助模型的依赖。
标准 Contrastive Decoding 使用能力较弱的辅助模型。CED 则在同一架构上执行双重前向传播,以隔离从众偏差。这种方案不会将认同与实际解题能力混为一谈。
| 特征 | Contrastive Decoding | CED |
|---|---|---|
| 辅助模型 | 能力较弱 | 不使用 |
| 前向传播次数 | — | 在同一架构上执行双重前向传播 |
| 隔离的因素 | — | 从众偏差 |
通过非对称、零边界概率截断和离散 top-k 截断掩码来抑制 token。这些组件可以去除有害共识 token,同时避免语法崩溃。
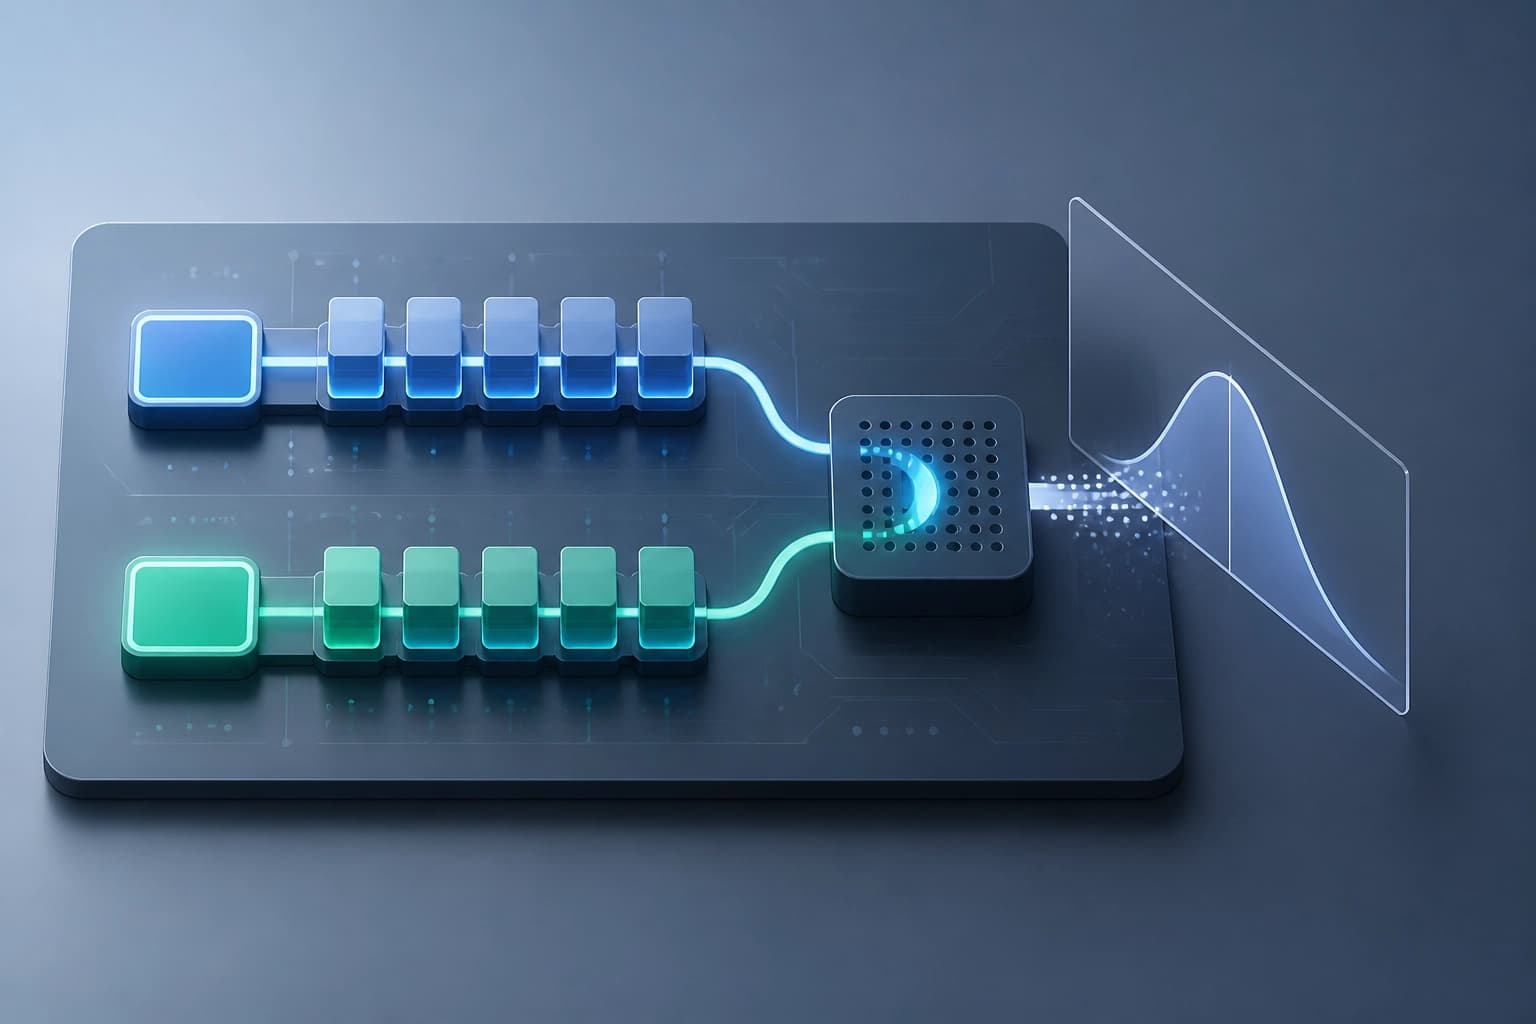
实际意义:CED 可集成到推理过程中,且不依赖第二个模型。
评估结果
作者在 7,200 条成对轨迹上评估了 CED。所用基准包括 GAIA、SWE-bench 和 Multi-Challenge。测试涵盖三种模型:Gemma-2 (9B)、Llama-3.1 (8B) 和 Mistral v0.3 (7B)。
关键数据:
- 认知懈怠最多降低 33.00%(绝对值);
- 准确率最多恢复 30.75%;
- 中和架构偏差和位置偏差。
| 模型 | 恢复自主性时的行为 |
|---|---|
| Gemma-2 (9B) | 被动聚焦任务 |
| Llama-3.1 (8B) | 主动反驳模拟群体 |
作者称,CED 无需微调即可将顺从与能力解耦。不同模型展现出不同的自主策略。
结论:所报告的效果适用于列出的基准和模型。
适用标准
CED 适合作为推理阶段的零样本干预方法。该方法无需微调,也不依赖辅助模型,因此可以将顺从与能力区分开来。
实际标准:
- 需要在不进行微调的情况下防范 adversarial swarm consensus;
- 重视通过双重前向传播在单一架构上运行;
- 需要抑制有害共识 token,同时避免语法崩溃;
- 可接受在 7B–9B 规模的模型以及 GAIA、SWE-bench、Multi-Challenge 基准上进行评估。
局限:论文仅报告了三种模型和三个基准上的结果。论文没有提供超出这一范围的数据。