
Neptuna:可压缩多相间断流中的机器学习架构比较
Neptuna 是一项大型基准测试,包含 3 TB 的计算数据,用于研究冲击波作用下的气泡塌缩和液滴破碎,并对卷积模型、谱模型、Transformer 模型及预训练 PDE 模型进行评测。结论是:没有普遍领先的模型,而复合损失函数和 SoftAdapt 有助于更好地保持界面,并更准确地复现频谱。
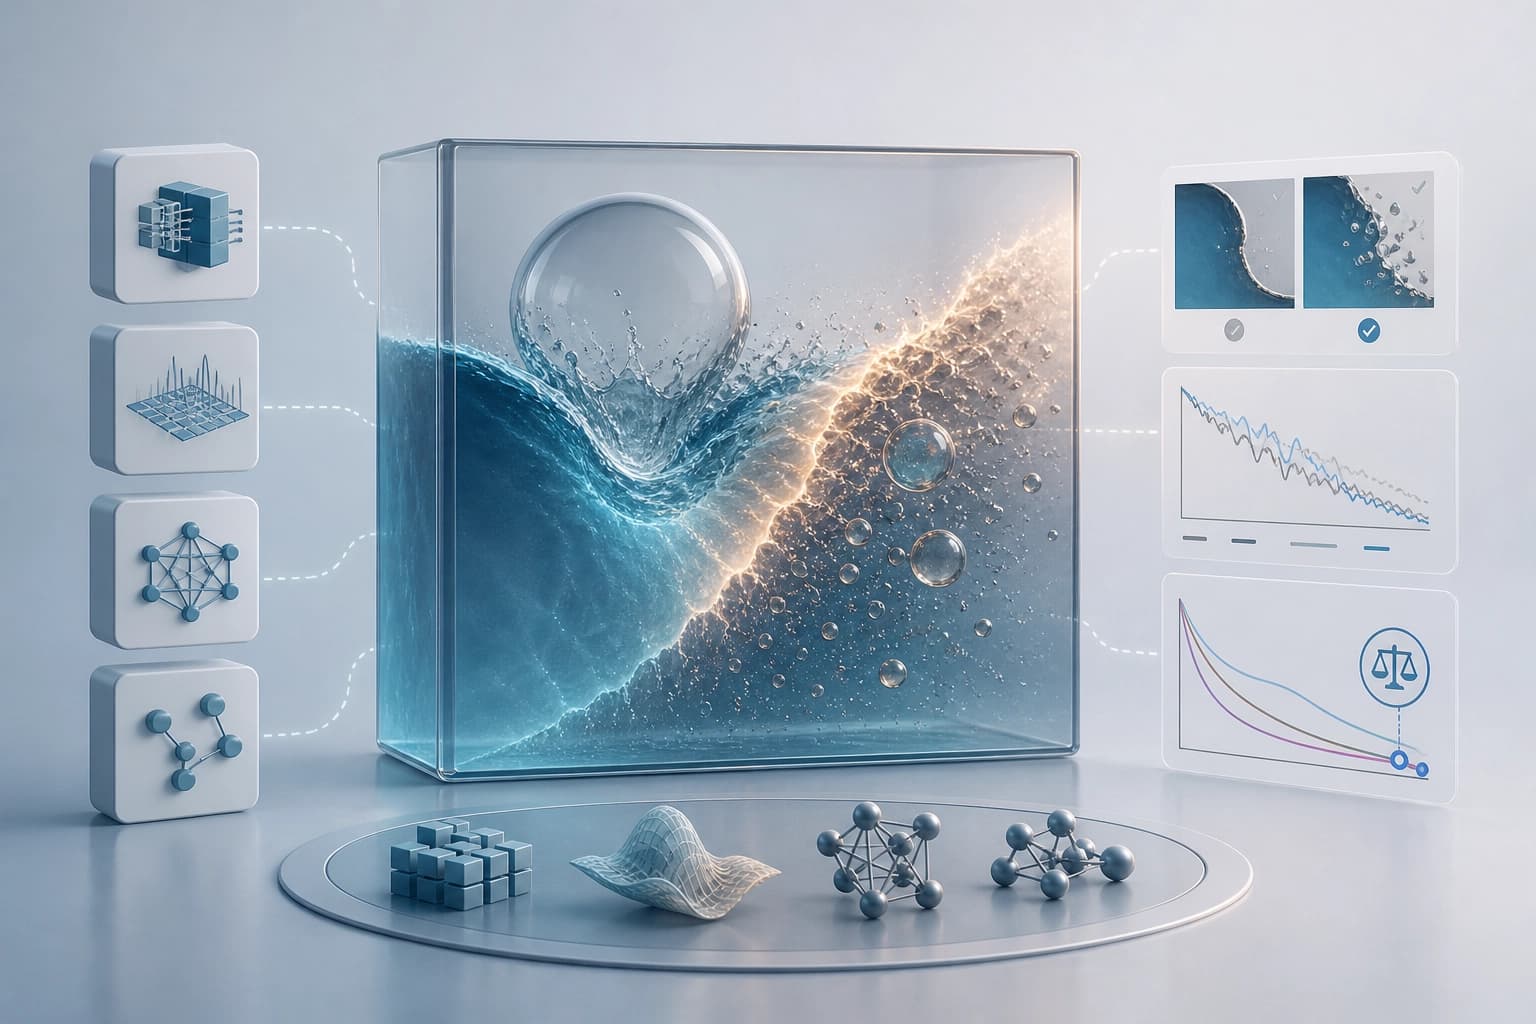
基准测试任务
Neptuna 是首个面向冲击激发可压缩多相流的大规模基准测试。它旨在利用含有冲击波和材料界面的数据比较 ML 模型。该基准测试评估的不是单一架构,而是架构、损失函数和指标的组合。
| 评估组件 | 选项 |
|---|---|
| 架构 | 卷积模型、谱模型、Transformer、PDE 基础模型 |
| 损失函数 | MSE、复合损失函数、SoftAdapt、GradNorm |
| 指标 | 逐点指标、谱指标、特征导向指标、结构指标、物理感知指标 |
结论:该基准测试为可复现的比较提供了统一平台。实践标准:使用它在相同数据和指标上比较模型。
数据与物理
该基准测试包含 3 TB 的高精度 2D 和 3D 数据。这些数据描述了冲击波引发的气泡塌缩和液滴破碎。这类流动中存在冲击波和材料界面。
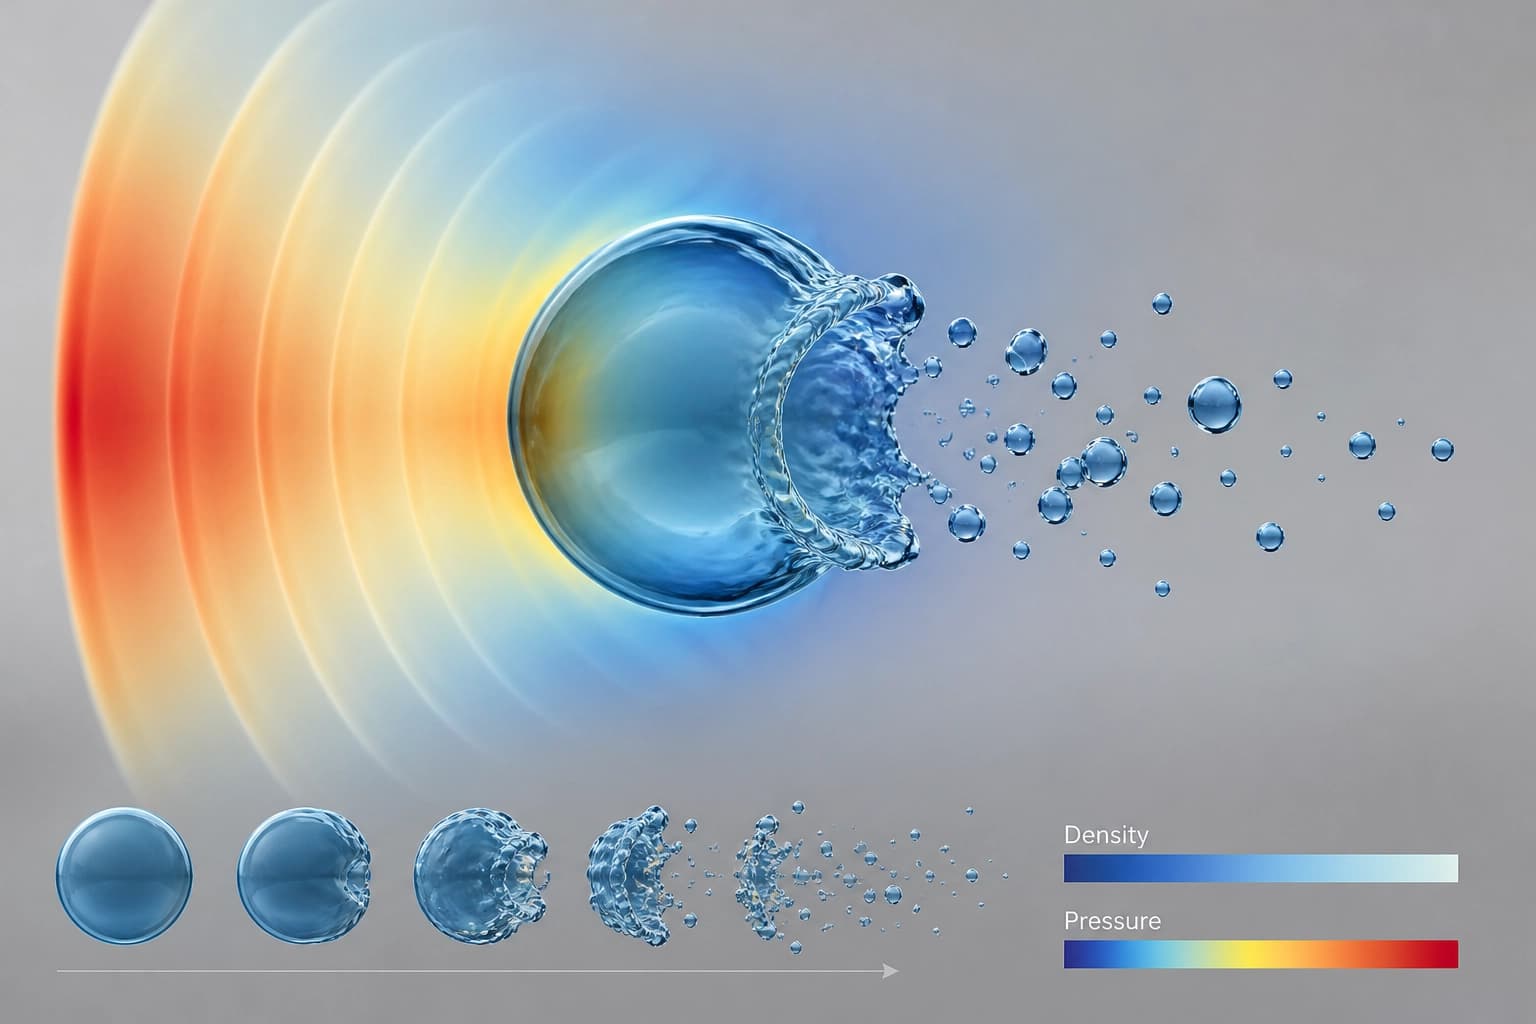
强非线性交互会导致复杂的界面变形、混合和多尺度动力学。构建可靠的代理模型面临三项挑战:
- 可压缩性;
- 不连续性;
- 多相效应。
这些因素会同时出现。
结论:这些数据会检验模型处理不连续性和界面的能力。实践标准:在验证中纳入包含不连续性和界面的场景。
比较的架构
该基准测试评估了卷积模型、谱模型和基于 Transformer 的模型。评估还包括预训练的 PDE 基础模型。该基准测试在具有不连续性的可压缩多相流上检验这些模型类别。
比较涵盖了构建代理模型的不同方法,并不局限于单一类别。所有架构都在相同的数据和指标上进行评估。
结论:应根据任务选择架构,而不是根据所属类别的名称来选择。实践标准:在架构将要应用的数据集上进行测试。
损失函数
基准测试中的标准训练使用 MSE。此外还测试了复合损失函数,将 MSE 与 Sobolev、界面感知和结构感知组件结合起来。
损失的自适应平衡采用了 SoftAdapt 和 GradNorm。该基准测试包含这两种方法。
| 选项 | 组成 |
|---|---|
| MSE | 基础损失函数 |
| 复合损失函数 | MSE + Sobolev + 界面感知 + 结构感知 |
| SoftAdapt | 自适应损失平衡 |
| GradNorm | 自适应损失平衡 |
结论:损失函数的选择取决于目标指标。实践标准:如需测试自适应平衡,应纳入 SoftAdapt 和 GradNorm。
评估指标
评估包含五组指标:
- 逐点指标;
- 谱指标;
- 特征导向指标;
- 结构指标;
- 物理感知指标。
指标集具有多维性。结论:不能只依据单一指标判断模型。实践标准:预先确定对任务至关重要的指标组。
比较结果
没有任何模型在所有数据集和所有指标上都表现最佳。这一结果适用于不同架构和配置。复合损失函数显著提升了界面保留能力和谱精度。
与仅使用 MSE 训练相比,SoftAdapt 带来了最稳定的改进,且几乎没有增加计算开销。GradNorm 也纳入了评估。没有一个方法在所有指标上都胜出。
| 比较内容 | 结论 |
|---|---|
| 架构 | 没有任何一种在所有数据集和指标上都表现最佳 |
| 复合损失函数 | 提升界面保留能力和谱精度 |
| SoftAdapt | 带来最稳定的改进,且几乎没有增加额外开销 |
结论:选择取决于数据集和指标。实践标准:先确定关键指标,再在目标数据集上测试损失函数和架构。
状态与访问
Neptuna 论文已被 NeurIPS-2026(Evaluations and Datasets Track)接收。论文于 2026 年 7 月 24 日提交(v1);最新版本于 2026 年 10 月 18 日发布(v3)。arXiv:2607.22280。
基准测试代码库和数据集可通过 this https URL 获取。这使得复现评估并将模型与基准测试结果进行比较成为可能。
结论:该基准测试可供实际验证。实践标准:使用代码库作为可复现比较的基础。
常问问题
相关材料
所有材料
RL 模拟器故障诊断中的规范多项式不变量:它们究竟在何处发挥作用
这项研究检验了将物理定律纳入可训练动力学模型是否合理:从轨迹中提取并通过 Gröbner 基化为规范形式的不变量,虽能小幅提升预测效果,却在诊断方面表现出色——它们能够定位被违反的约束,并找出具体的错误参数。
10 十一月 2026
AURA-Eval:如何验证 LLM 智能体识别了风险并调整了下一步行动
该框架评估 LLM 智能体在关键节点面对风险时的反应,而非最终判断:工具调用轨迹会被中断,随后模型必须继续推理并采取行动,LLM 评审团则分析其风险识别、行动性质与安全性。在从 157 条 R-Judge 轨迹中整理出的 1249 项任务上,对 20 个模型的评估显示,缺少安全路径时,不安全行为会增多;在执行前撤除监督,会使 52.3% 原本安全的案例转为不安全。
10 十一月 2026
陈-西蒙斯储层记忆:连通性的自主动力学与密度输运
本文探讨了储层如何同时在密度分布和几何自由度中保留输入信号的历史。对四种机制的比较表明,电流会形成一个独立的连通分量,改变密度的后续响应;而纳入所有测得的特征,则能在脉冲顺序解码方面带来小幅提升。
10 十一月 2026