
解读作为维度:MTI数学框架通过熵与可混淆性描述误解
Blake Reynolds 在 arXiv 上提出了《数学解释理论》的压缩内核:在这里,理解不是文本的属性,而是依赖于观察者、其访问权限和所选方法的谱测量结果。该论文引入了作为残余模糊度度量的理性熵,以及从干扰转化为设计资源的可混淆性,还提出了带有类型化故障的读取质量四条件证书。
解读在对话中通常只是一个二元标签:“懂了”或“没懂”。Blake Reynolds 的著作《A Mathematical Theory of Interpretation: Rational Entropy, Spectral Readout, and Confusability as a Resource》(arXiv:2608.23892,2026年8月;2026年博士论文的精简核心)提出了一种不同的视角。在这里,理解不是一种意识状态,而是依赖于观察者的测量结果。而且这种测量并非发生在真空中,而是在访问结构的框架内:有人拥有数据的钥匙,有人没有,脱离访问权限来谈“懂了”就失去了意义。
该论文发表在 cs.IT,并交叉列入 cs.AI——这本身就颇具意味。作者将关于解读的讨论从诠释学领域转移到信息论领域,那里有熵、信道容量和明确列举的失效模式。
四个参数取代直觉
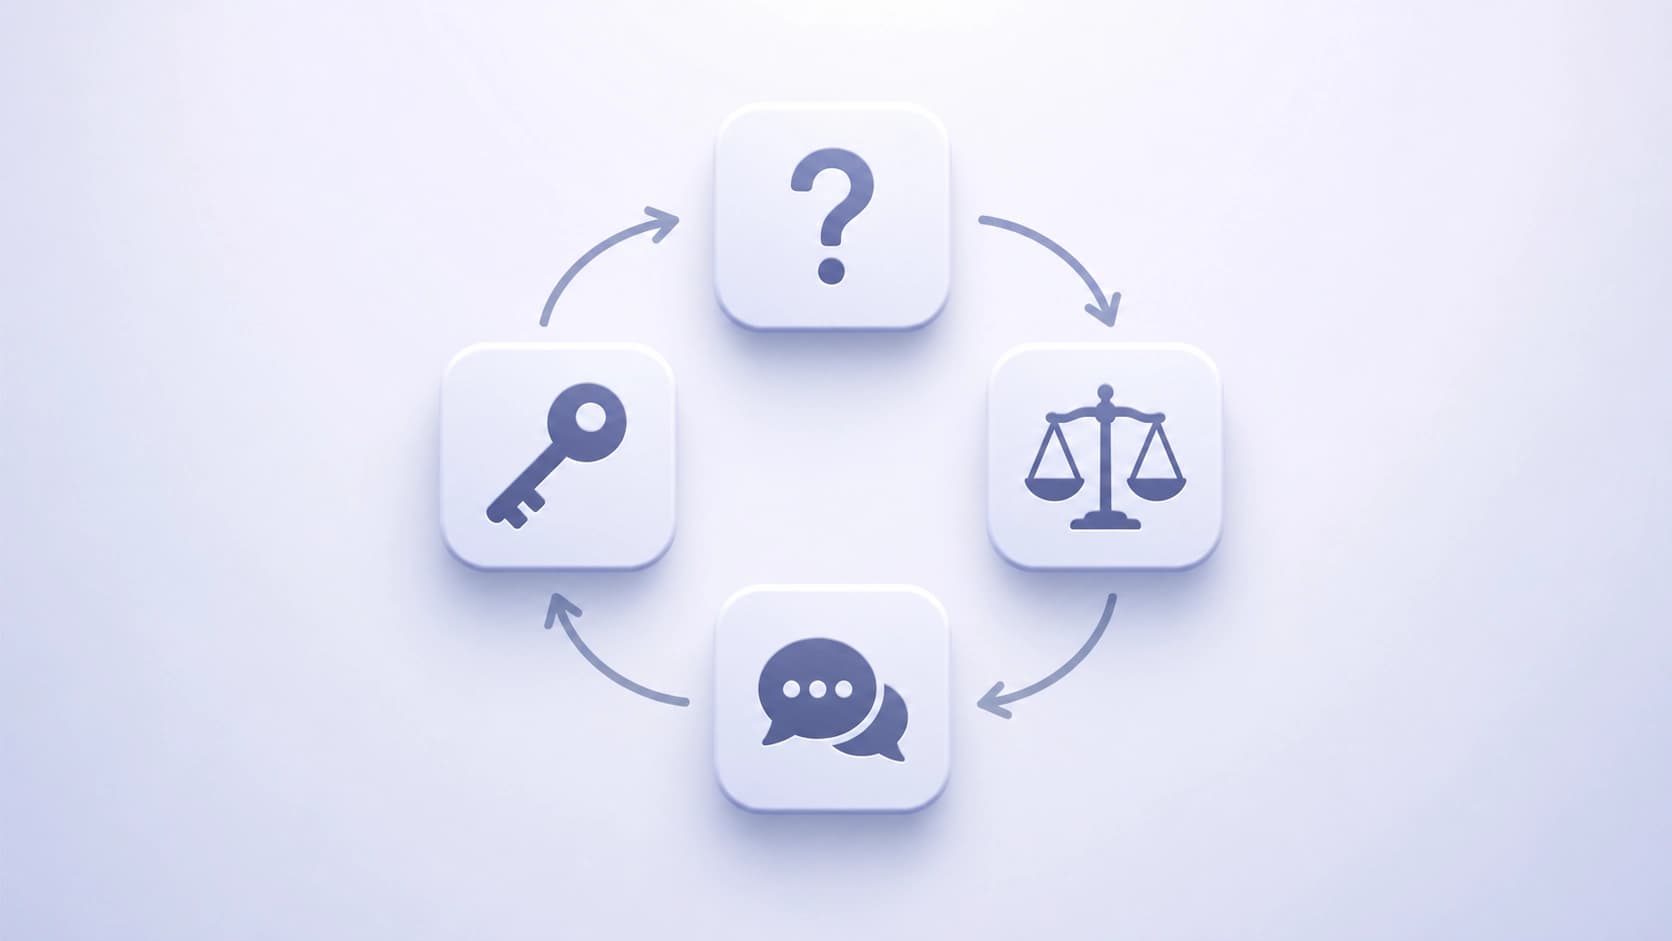
MTI 的核心举措是将解读转化为方法设计问题。理论不再追问“这个信号意味着什么”,而是追问观察者拥有哪些可能性。这样的可能性有四种,由 access、query、utility 和 medium 四个参数来定义:
- 访问 — 观察者究竟被允许接触哪些数据;
- 查询 — 他有权向系统提出哪些问题;
- 效用 — 对他来说什么算作好的回答;
- 载体 — 信号在何种环境中传播和存储。
观察者能选择什么、识别什么、传递什么,或者反过来拒绝接受什么,都取决于这四元组。这里的实践结论相当犀利:关于“正确解读”的争论,往往其实是关于这四组参数不同配置的争论。两个人可能看着同一个对象,逻辑上并不矛盾——只是他们的访问配额不同,查询也不同。
Rational Entropy:还剩多少不理解
接下来理论转向一个可度量的量。在 learning-invariant 希尔伯特实现中引入了 Rational Entropy——它同时沿三条轴描述残余不确定性:知识、效用和载体。简单说,这是对“还有多少未解决”的回答,而且不是泛泛而谈,而是考虑到观察者已经知道什么、想要什么。
一个重要细节:在有限有效模式下,作者对理性熵的零集进行了分类。也就是说,理论不仅引入了一个度量,还描述了它何时归零——哪些访问、查询和环境的配置能带来完全确定性。对工程而言,这是最有趣的地方:零集就是一份清单,列出了不理解在构造上不可能发生的条件。
为什么这不是普通的熵
经典熵对观察者的目标一无所知。而在这里,效用被纳入度量本身,这意味着两个信号统计特性相同的系统可能具有不同的理性熵——如果观察者的任务不同的话。对于那些寻找单一通用“可理解性”指标的人来说,这很不方便,但它更诚实地描述了现实。
混淆性作为资源,而非缺陷
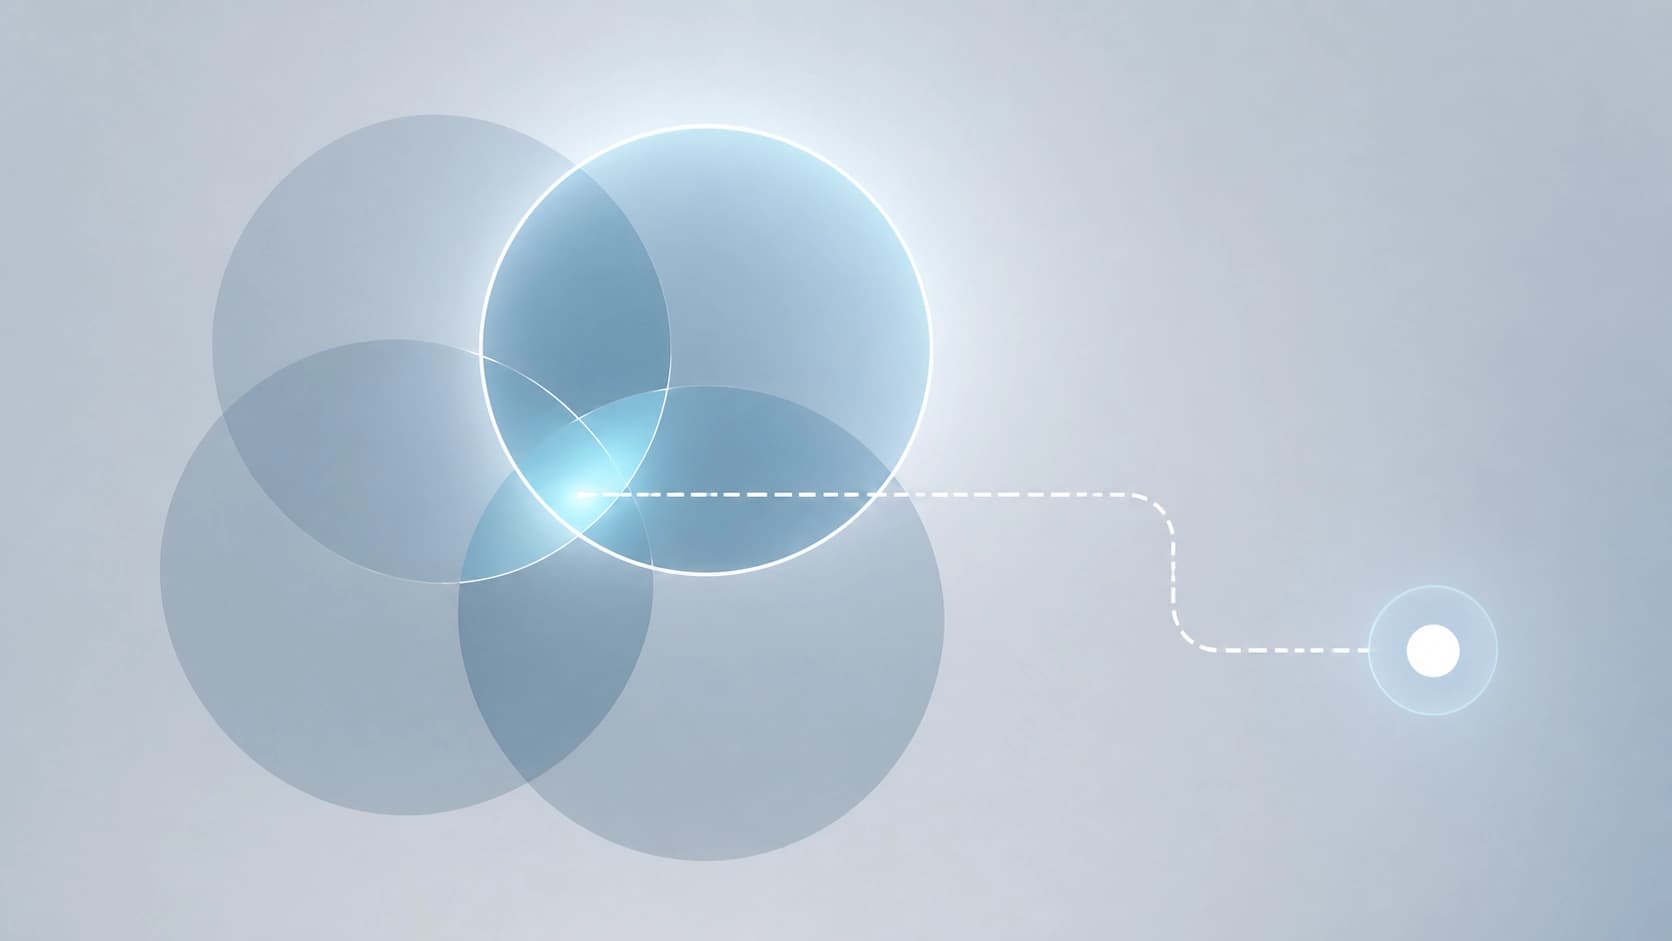
最反直觉的结果是:成对混淆性(两个状态不可区分时)等价于 uniform atomic collapse。听起来像是判决,但接下来出现了反转。唯一的效用极大值能够选择一个原子,即使所有其他状态在零成本下仍保持非原子性。
换句话说,混淆性在编码理论中的通常角色被颠倒了。在那里,不可区分性是错误的来源,需要被消除。而在这里,它可以为观察者所用:至少在某个方向上的共识排除了未解决的多原子读法,而联合标签保持了对象的识别。如果两个状态在一个维度上“粘在一起”,但在另一个维度上可以区分,观察者仍然能将对象作为一个整体来把握。
自由设计能承受多少
从这一逻辑中生长出一个定量估计。自由设计的容量等于所有方向预算的乘积,但不包括最小的那个。公式很短,但重点不寻常:最弱的方向不进入乘积。这应当被解读为一个暗示——解读中的瓶颈与通信信道中的瓶颈构造不同:在信道中,正是最差的那一段决定结果,而这里的算术不一样。
四条件证书
为了让结果不停留在理论层面,引入了一个四条件证书。它将读法刻画为:
- sharp — 锐利的,没有模糊边界;
- decodable — 可解码的;
- medium-faithful — 忠实于载体的,即不扭曲传输环境;
- order-independent — 不依赖于操作顺序的。
这一切都建立在代码的有限交换扇区上。如果至少有一个条件被违反,理论给出的不是笼统的耸肩,而是类型化的障碍:具体指出发生了哪种类型的失效。对实践而言,这或许是该工作最重要的价值。取代“模型在幻觉”的,是一套词汇:这里丢失了锐利性,这里载体扭曲了信号,而这里处理顺序破坏了识别。
为什么这在数学之外也有用
MTI 宣称自己是构建解读方法的理论基础,带有明确的访问假设、保证和失效模式。应用于 AI 系统时,这正是评估模型时常常缺少的东西:不是又一个“回答质量”指标,而是一个框架,迫使人们事先说清楚谁有什么访问权限、允许哪些查询、什么算作有用。这样,关于不理解的讨论就变得可复现了。
值得记住的几点
这是一篇预印本:v1 版本,博士论文的精简核心,尚未经过完整的同行评审。文章中的数学工具很密集,转述不可避免地会粗化表述——要获得希尔伯特实现和交换扇区的精确定义,最好去查阅原始文献。
但核心思想无需细节也能应用于实践。不理解不再是人或模型的属性,而成为一个可度量的量,取决于由访问、查询、目标和环境构成的配置。混淆性不再仅仅是缺陷,有时还能充当支撑。而四条件证书提供了一套语言,让解读的失败可以被叫出名字——而不是把一切都归咎于“解释得不清楚”。
常问问题
相关材料
所有材料
OpenCollab:可编程智能体协调、受控执行环境与规程遵循度指标
该框架将智能体交互结构的设定、统一的实验环境和详细的事件追踪整合在一起;新增的 Adherence 指标则反映实际执行与声明方案的符合程度。在基准测试中,Duo 配置达到新的 SOTA 水平,而单智能体版本的 token 消耗量最低。
11 十一月 2026
Toollery:从数万种选项中为 LLM 智能体挑选工具,无需微调
Toollery 根据技能和工具的描述构建搜索索引,并在收到请求时只向模型传递有限的一组候选项。在规模达数万个函数的库上进行的实验表明,该方法在固定 top-K 的情况下能够保持选择质量,但最终效果取决于负载特征和服务提供商的缓存情况。
11 十一月 2026
WILSON:整合患者的放大图像和切片,用于病理形态学分析和报告生成
这篇预印本介绍了 WILSON——一种视觉语言模型,可对整张玻片图像以及同一患者在不同放大倍率下的一系列切片进行编码,而不只是单张“最佳”切片。无需针对特定任务进行微调,它在多项指标上超越了专用且规模更大的切片模型,同时计算负载显著更低;其诊断描述也获得了病理学家更高的评价。
11 十一月 2026