
WILSON:整合患者的放大图像和切片,用于病理形态学分析和报告生成
这篇预印本介绍了 WILSON——一种视觉语言模型,可对整张玻片图像以及同一患者在不同放大倍率下的一系列切片进行编码,而不只是单张“最佳”切片。无需针对特定任务进行微调,它在多项指标上超越了专用且规模更大的切片模型,同时计算负载显著更低;其诊断描述也获得了病理学家更高的评价。
为什么一张代表性玻片还不够
病理学家会在不同放大倍率下检查组织切片,并查看多张载玻片。他们综合形态学信息来作出诊断。大多数病理学基础模型会对一张代表性(“最佳”)载玻片中的数千个图像块进行编码,然后聚合这些特征。
这种方法的局限:
- 模型接收的是一张“最佳”载玻片,而不是整个病例;
- 不同放大倍率下的特征无法关联为统一表示;
- 聚合图像块时,患者层面的上下文会丢失。
实用标准:对于病例级任务,需要选择能够接收多张载玻片和不同放大倍率的模型。一张代表性切片无法涵盖这种任务设定。
模型如何整合不同放大倍率和载玻片
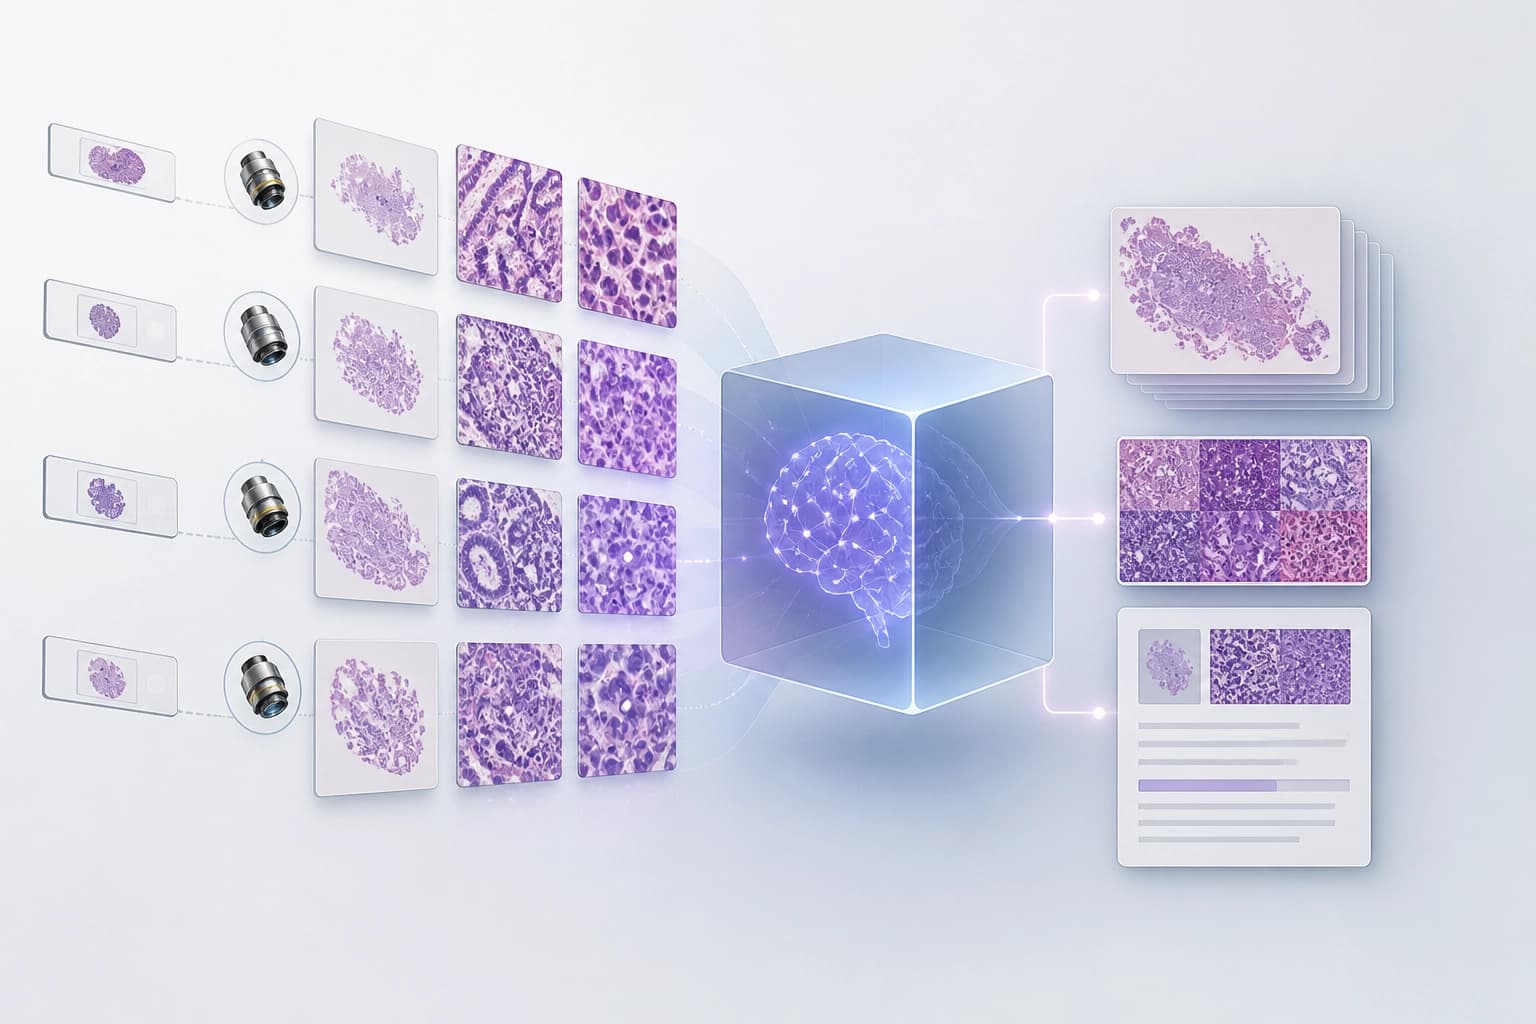
WILSON 是一个视觉语言基础模型。它通过多倍率复合表示来呈现全切片图像和包含多张载玻片的病例,并支持患者级分析。
表示内容包括:
- 全切片图像;
- 包含多张载玻片的病例;
- 多倍率复合表示中的多个放大倍率。
结论:模型在一个表示中保留了来自不同尺度和载玻片的形态学信息。这使它有别于仅使用一张“最佳”载玻片的方案。
训练数据与覆盖范围
WILSON 的训练集约包含 189 000 张切片。数据覆盖 42 个器官和 838 个诊断实体。
覆盖范围:
- 189 000 张切片;
- 42 个器官;
- 838 个诊断实体。
器官和诊断实体列表为任务验证划定了范围。专业人员会根据该列表核对器官和诊断实体。
无需针对特定任务训练的结果
在无需针对特定任务训练的情况下,WILSON 在病例级任务上的表现超过了专用病例级模型,macro-F1 为 0.52,而后者为 0.38。
| 对比项 | WILSON | 其他方案 |
|---|---|---|
| 病例级任务上的 Macro-F1 | 0.52 | 0.38 |
| 计算操作量 | 少 400–1 350 倍 | 显著更大的切片级模型 |
该模型的表现也达到显著更大的切片级模型的水平,同时所需计算操作量少 400–1 350 倍。
结论:病例级分析的质量不一定要随着计算成本上升。紧凑的多尺度表示提供了一个实用参考。
针对特定任务进行微调
端到端微调提升了 WILSON 在以下任务中的表现:
- 乳腺癌亚型分类;
- 间质淋巴细胞分级。
实用标准:对于范围较窄的任务,应考虑端到端微调。基础模型无需微调即可进行病例级分析,而微调则能提升特定任务的表现。
检索与诊断文本生成
在图文检索任务中,WILSON 的 recall@1 高于 PRISM,分别为 75.6% 和 58.1%。
| 指标 | WILSON | PRISM |
|---|---|---|
| recall@1 | 75.6% | 58.1% |
五位具有 board 认证资格的病理学家对 WILSON 生成的诊断描述给出了更高评分。竞争模型的评分则较低。
实用标准:检索和起草诊断报告需要两种能力——检索和文本生成。应在接近实际工作流程的任务中对这两种能力进行评估。
这对模型选择意味着什么
作者得出结论:紧凑的多尺度表示能够支持计算效率高、面向临床的基础模型。在实际选择时,需要进行以下几项检查。
标准:
- 模型能够接收多张载玻片;
- 模型能够关联不同放大倍率;
- 分析以患者为单位进行;
- 在病例级任务上评估质量;
- 将计算操作量纳入考量;
- 分别验证检索和文本生成能力。
结论:一张“最佳”切片和对数千个图像块进行聚合,无法涵盖患者的上下文。选择模型时,应考察它如何整合这些上下文,以及需要多少计算资源。
常问问题
相关材料
所有材料
仪表板分析中 GUI 智能体的分阶段诊断:DashAct 基准测试
介绍 DashAct:一个包含 348 条经人工验证轨迹的基准测试,将 GUI 代理与交互式面板的工作拆分为三个阶段和四种视觉条件。结果显示,代理在动作预测和视觉目标定位方面存在持续性问题,其响应也依赖于上下文和空间支持。
11 十一月 2026
RL 模拟器故障诊断中的规范多项式不变量:它们究竟在何处发挥作用
这项研究检验了将物理定律纳入可训练动力学模型是否合理:从轨迹中提取并通过 Gröbner 基化为规范形式的不变量,虽能小幅提升预测效果,却在诊断方面表现出色——它们能够定位被违反的约束,并找出具体的错误参数。
10 十一月 2026
AURA-Eval:如何验证 LLM 智能体识别了风险并调整了下一步行动
该框架评估 LLM 智能体在关键节点面对风险时的反应,而非最终判断:工具调用轨迹会被中断,随后模型必须继续推理并采取行动,LLM 评审团则分析其风险识别、行动性质与安全性。在从 157 条 R-Judge 轨迹中整理出的 1249 项任务上,对 20 个模型的评估显示,缺少安全路径时,不安全行为会增多;在执行前撤除监督,会使 52.3% 原本安全的案例转为不安全。
10 十一月 2026