
多模态多智能体 LLM 在数学中的应用:如何验证解题过程及其对扰动的稳健性
MAMath-Bench 已发布,这是一个包含 1003 道题目、涵盖 11 个数学领域的基准测试集,题目配有文本、图表和音频材料;除最终答案外,它还记录关键推理步骤,以及系统对推理过程对抗性修改的反应。结果表明,多种 LLM 协作并不一定能提高准确率,还可能导致论证冗长,而细微的结构性扰动仍是一个重要的脆弱性来源。
基准测试评估什么
MAMath-Bench 是一个用于评估多智能体系统多模态数学推理能力的基准测试。它包含来自 11 个数学类别的 1 003 道题目。题目涵盖多个难度级别和三种模态:文本、图像和音频。
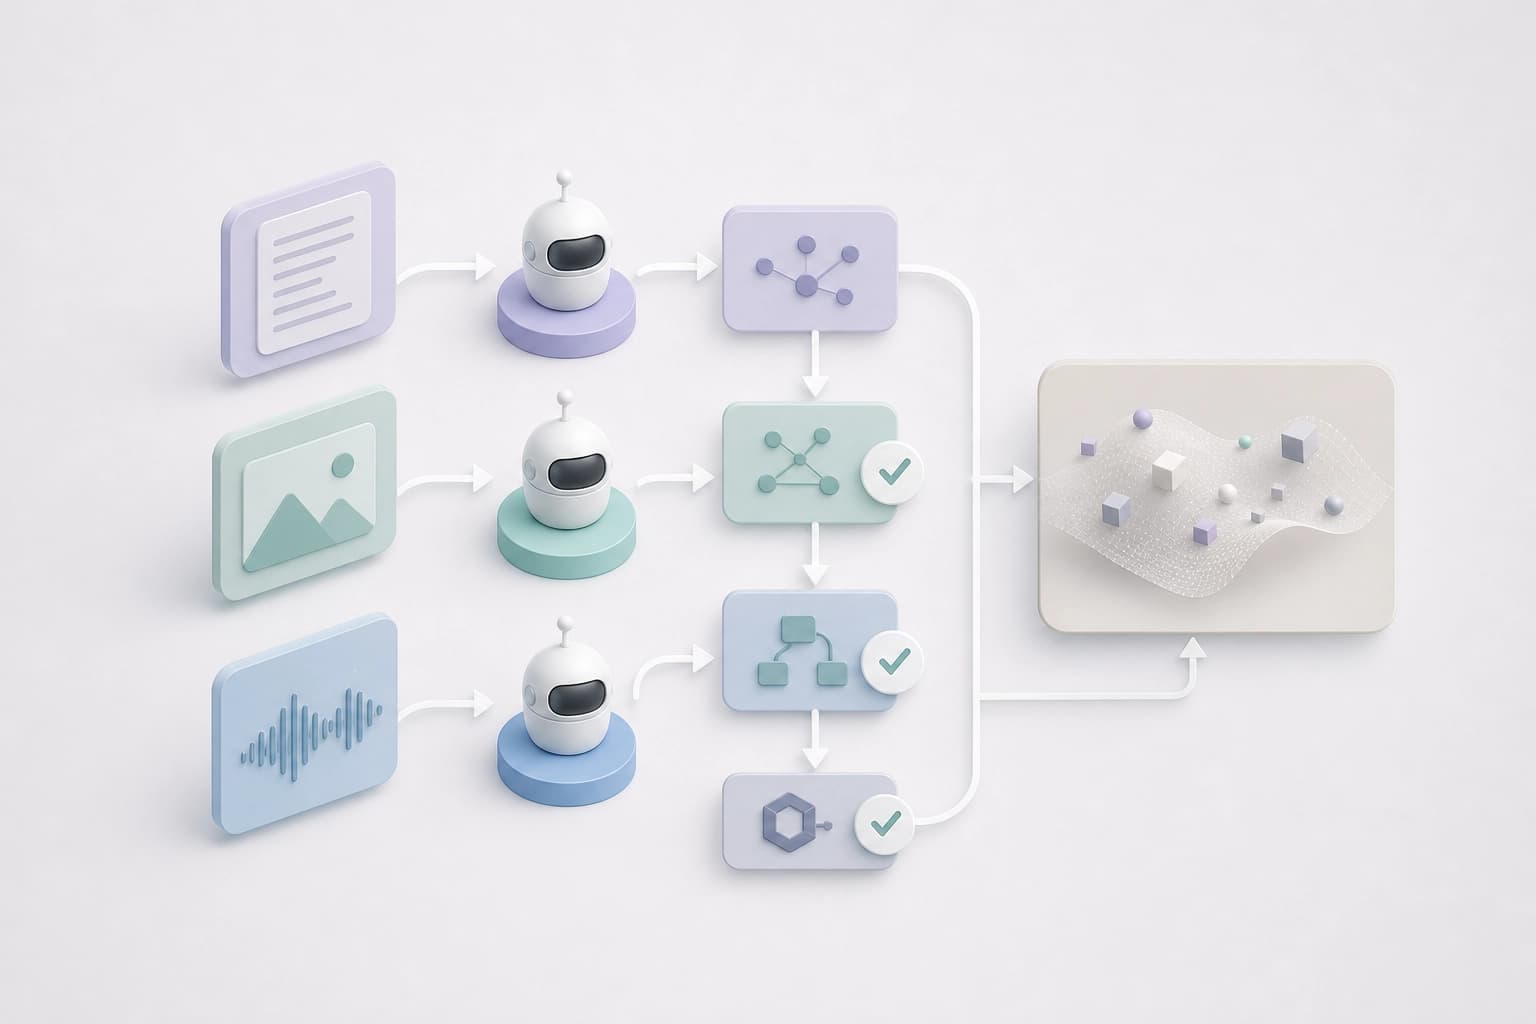
该基准测试包含详细的检查点标注。评估分为三个维度:
- 题目解答的正确性;
- 推理过程的可靠性;
- 对推理链对抗性扰动的鲁棒性。
实用标准:选择能够分别衡量答案正确性、过程可靠性和抗扰动能力的评估方式。仅检查最终答案并不足够。
检查解题过程
检查点标注为核验中间步骤提供了依据。推理过程可靠性的评估与最终答案的正确性分开进行。因此,可以比较系统的表现,而不仅仅看结果。
解题过程中需要检查的内容:
- 是否包含标注中标出的检查点;
- 中间步骤是否符合这些检查点;
- 将推理过程的可靠性作为单独的评估维度。
核验标准:记录解题过程具体在哪些地方偏离了检查点。仅凭最终答案无法判断解题过程的质量。
多智能体:准确性、覆盖度与冗余
评估展示了多个智能体协作带来的三种不同影响。与强大的单智能体 LLM 相比,最终答案的准确性并不总会提高。中间推理的覆盖度可能显著改善,而覆盖度的提升也可能伴随着推理冗余的增加。
| 比较内容 | 评估结果说明 | 实用结论 |
|---|---|---|
| 最终答案的准确性 | 多智能体协作并不总能比强大的单智能体 LLM 提高准确性 | 不要将多智能体方案视为答案正确性的保证 |
| 中间推理的覆盖度 | 协作可能显著提高覆盖度 | 将覆盖度的提升与其他维度一并比较 |
| 推理冗余 | 覆盖度的提升可能伴随着冗余的增加 | 评估覆盖度时考虑冗余的增长 |
选择标准:不要将多智能体方案视为准确性的保证。应在最终答案、覆盖度和冗余方面,将其与强大的单智能体 LLM 进行比较。
对抗性扰动鲁棒性
评估包含对推理链对抗性扰动的鲁棒性。当前系统仍容易受到对抗性推理错误的影响,尤其是由细微结构性扰动引发的错误。
需要检查的内容:
- 系统对推理链对抗性扰动的反应;
- 细微结构性扰动导致的推理错误;
- 推理过程可靠性的保持情况,而不仅是最终答案。
鲁棒性标准:使用推理链对抗性扰动对系统进行测试。对这类扰动的鲁棒性与答案正确性一样,也是评估的一部分。
常问问题
相关材料
所有材料
可验证任务与长轨迹微调:Navalia 如何增强协作型 LLM 智能体
这项研究介绍了一个框架:它基于企业财务报告构建带有可追溯证据的计算链,对其进行独立验证,然后将其用于 SFT 和 RL。基于 Qwen3.6-35B-A3B,该流程在五项基准测试中取得了提升;据作者称,它还改善了证据关联、工具使用和长程任务执行能力,包括办公场景。
18 十一月 2026
物理人工智能:概念边界、工具体系与难点
这部388页的专著将物理 AI 的定义、它与相关领域的区别以及主要方法整合在一个统一框架中,涵盖从感知和仿真到控制与协调式多智能体系统的内容。读者可以从中了解研究任务的全貌,以及阻碍专用解决方案迈向广泛泛化系统的限制。
17 十一月 2026
生产环境中的 LLM 智能体:分类体系、架构与部署限制
本文梳理了大型语言模型在生产环境中的智能体应用研究,归纳了相关障碍、能力层级和四层架构。读者可以了解目前已在探讨哪些生命周期场景,以及可靠自主规划仍存在哪些差距。
17 十一月 2026