
可验证任务与长轨迹微调:Navalia 如何增强协作型 LLM 智能体
这项研究介绍了一个框架:它基于企业财务报告构建带有可追溯证据的计算链,对其进行独立验证,然后将其用于 SFT 和 RL。基于 Qwen3.6-35B-A3B,该流程在五项基准测试中取得了提升;据作者称,它还改善了证据关联、工具使用和长程任务执行能力,包括办公场景。
Navalia 解决的问题
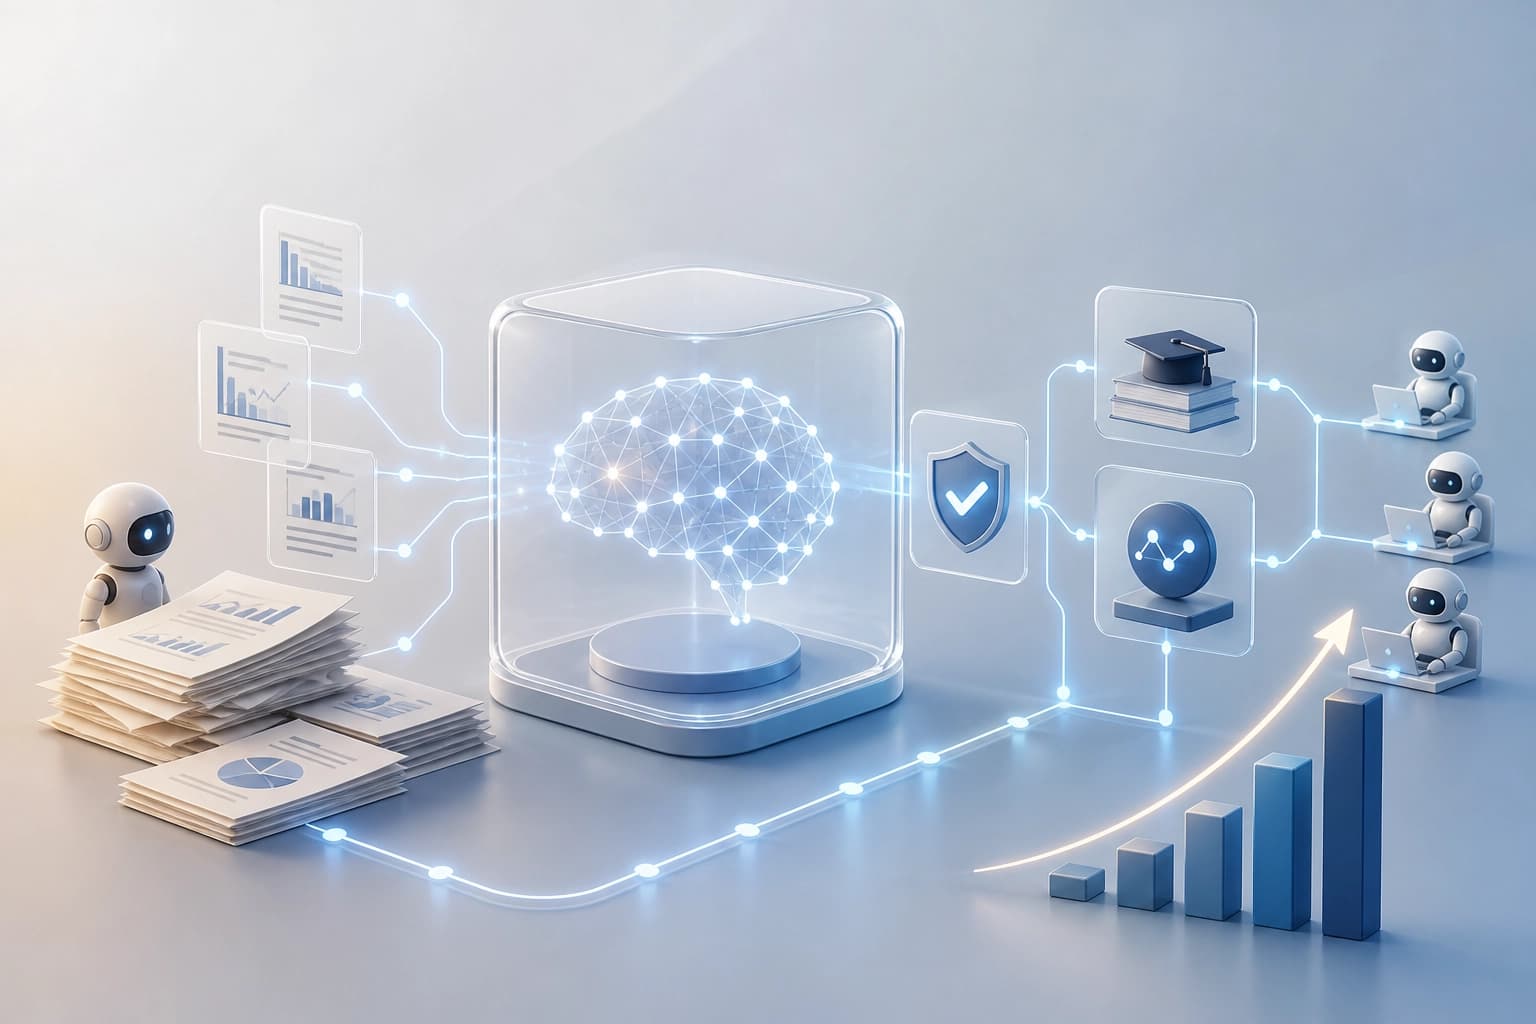
Navalia 是一个面向 Cowork Agents 的框架。它将可验证任务合成与长程后训练相结合。在金融分析中,该框架使用企业财务报告。
Navalia 从完整的事实集合中进行语义筛选,提取支持性证据。随后构建可执行的计算链。这样,框架便能创建分析任务,并确保证据可追溯,且各步骤之间存在事实数据依赖关系。
实用标准:如果一项任务具有可追溯的证据和步骤间依赖关系,就适合进行可验证合成。
证据与答案验证
证据的一致性和答案的正确性通过独立的 LLM 验证与程序检查来检验。这是两个不同的控制环节。前者评估语义层面,后者检查形式正确性。
实用标准:可验证任务需要 LLM 验证和程序检查两者兼备。
长轨迹后训练
经过验证的任务可用于收集轨迹。Navalia 采用冷启动监督微调和强化学习。这两个阶段都能提升长程任务执行能力。
基于 Qwen3.6-35B-A3B 初始化的框架,相较于基线模型取得了稳定提升。在全部五个基准测试中都能看到这一提升。作者报告称,Navalia 改善了证据整合、工具使用和长程任务执行能力。
实用标准:当任务需要一连串长步骤并使用工具时,后训练才有意义。
基准测试与结果迁移
Navalia 在五个基准测试上进行评估:OfficeQA Pro、FinSearchComp、Finance Agent Benchmark、APEX-Agents-AA 和 Workspace-Bench-Lite。该框架在全部五项测试中都较基线模型取得了稳定提升。
作者报告称,结果可迁移到更广泛的 Cowork 场景,其中包括通用办公任务。实用标准:关注技能能否迁移到金融分析之外。通用办公任务是适用范围更广的标志。
常问问题
相关材料
所有材料
物理人工智能:概念边界、工具体系与难点
这部388页的专著将物理 AI 的定义、它与相关领域的区别以及主要方法整合在一个统一框架中,涵盖从感知和仿真到控制与协调式多智能体系统的内容。读者可以从中了解研究任务的全貌,以及阻碍专用解决方案迈向广泛泛化系统的限制。
17 十一月 2026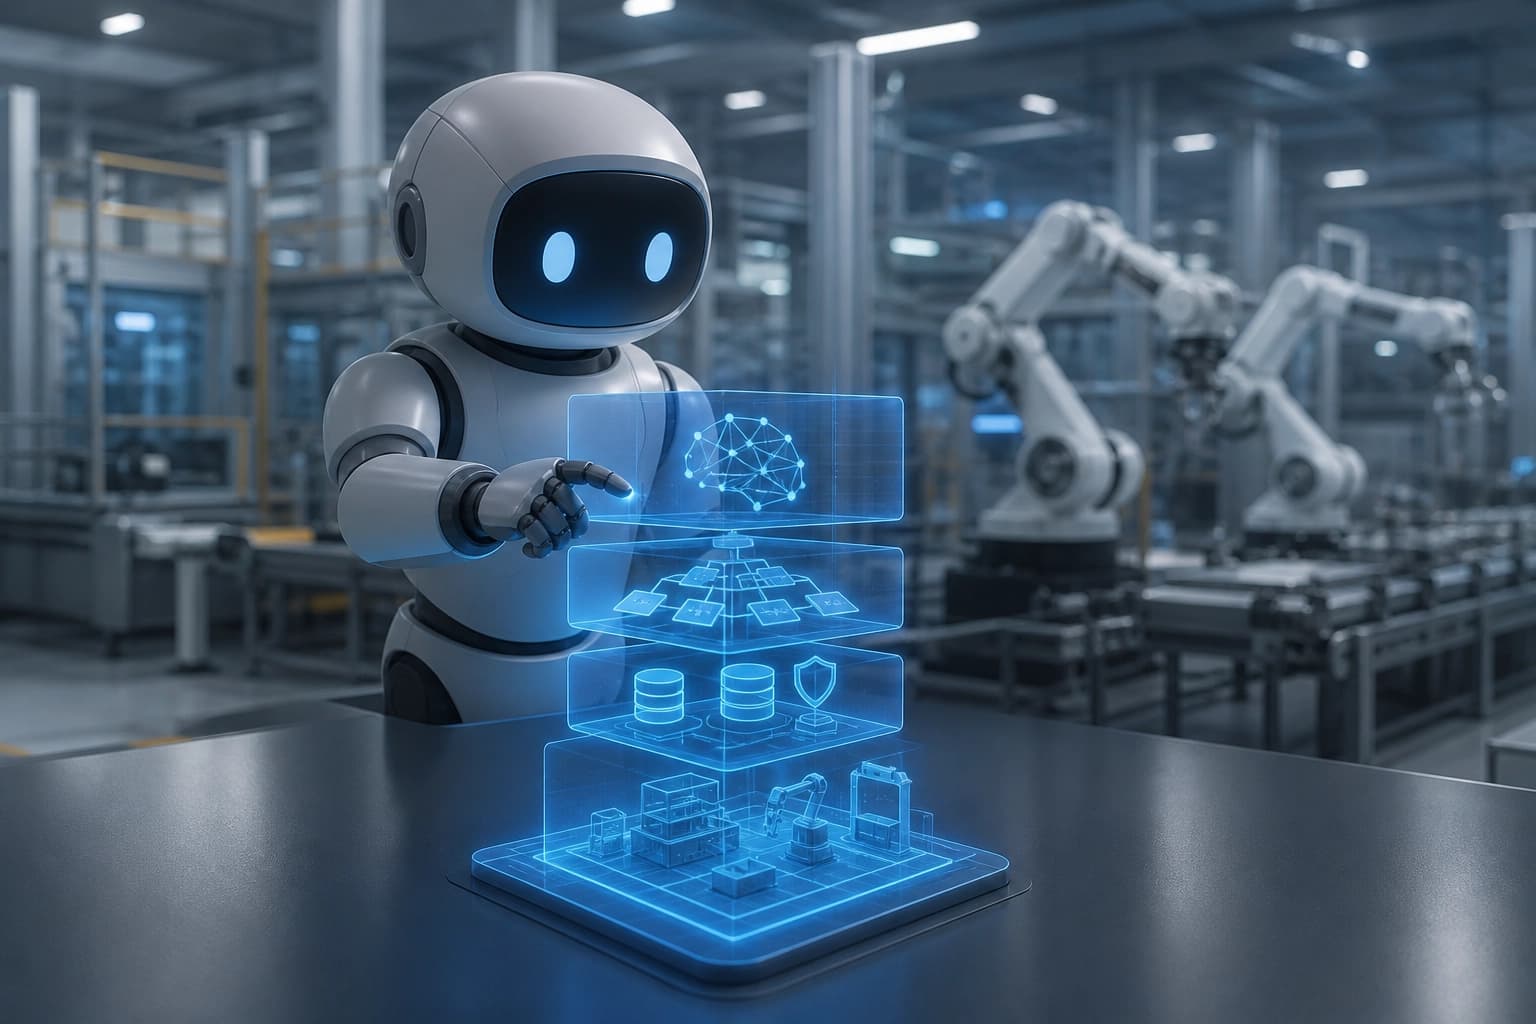
生产环境中的 LLM 智能体:分类体系、架构与部署限制
本文梳理了大型语言模型在生产环境中的智能体应用研究,归纳了相关障碍、能力层级和四层架构。读者可以了解目前已在探讨哪些生命周期场景,以及可靠自主规划仍存在哪些差距。
17 十一月 2026
OWP方法:在 Omni-LLM 中重新分配证据与先验信号
Omni-Woodpecker 是一种无需训练的框架,可检测模态间的冲突,并在解码前调整隐藏状态中上下文信息与记忆先验之间的平衡。在 Qwen2.5-Omni-7B 和 VideoLLaMA2-AV 上,该方法提升了模型在 CMM 和 AVHBench 上应对视听错误的稳健性,并在通用推理基准测试中带来适度提升。
17 十一月 2026