LocalProp 改变了什么
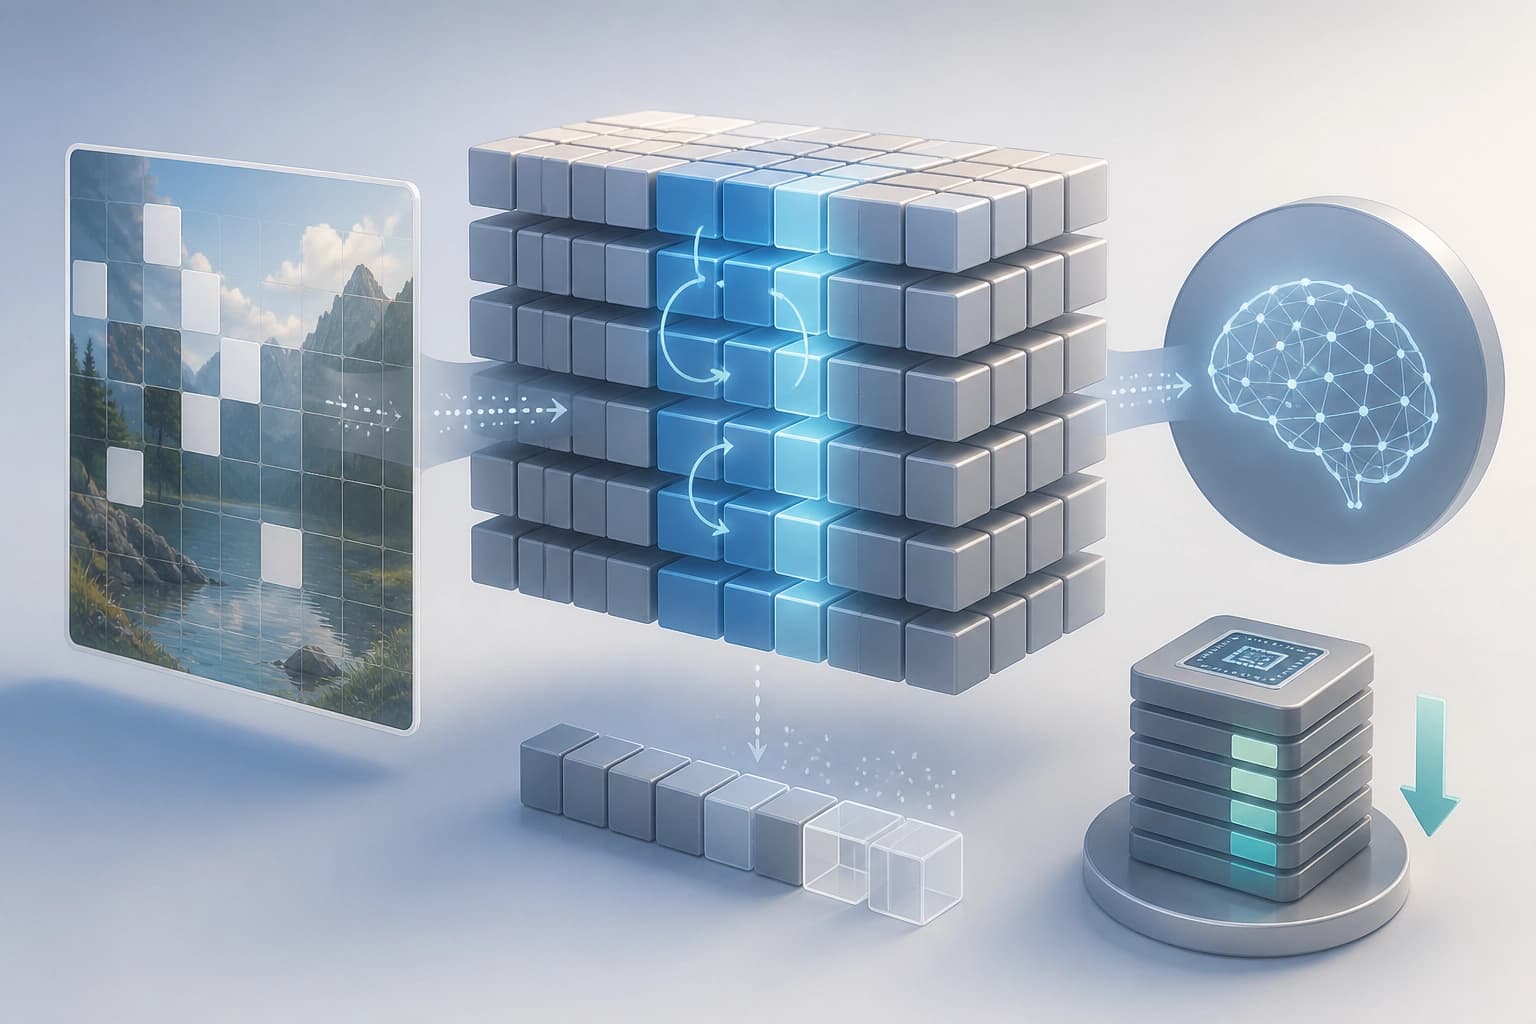
LocalProp 是一种训练过程,可在本地更新模型权重。作者将其与通过整个模型进行端到端梯度传播相对比。端到端传播不符合生物学上合理的训练方式,而且内存效率低下。大脑中的学习具有很强的局部性。
| 标准 | 端到端梯度传播 | LocalProp |
|---|---|---|
| 权重更新 | 贯穿整个模型 | 局部更新 |
| 生物学合理性 | 不符合 | 基于大脑中局部化的学习 |
| 内存 | 效率低 | 仅使用 GPU 峰值内存的一部分 |
| 控制方式 | 没有单独的参数 | 联合优化的块数 |
结论:LocalProp 用局部更新取代端到端传播,从而降低内存负担。
训练阶段
LocalProp 遵循“预训练后微调”的流程。各阶段依次进行。
- 使用 I-JEPA 进行预训练。
- 局部更新权重。
- 剪枝。
- 短暂的最终微调。
结论:该流程结合了预训练、局部更新、剪枝和最终微调。
剪枝的作用
剪枝将训练信号从上层块传递到下层块。这个阶段并非只是压缩模型,而是在训练过程中连接上层块和下层块。结论:在 LocalProp 中,剪枝充当块间信号传递通道。
准确率与内存之间的权衡
联合优化的块数决定了梯度传播的长度。作者将这一长度定义为一个实用参数,用于控制准确率与内存使用之间的权衡。
- 变化的内容:梯度传播的长度。
- 控制的内容:准确率与内存之间的平衡。
- 使用方式:通过联合优化的块数进行控制。
结论:调整块数可以作为平衡两者的手段。
结果与选择标准
作者在多个数据集上进行了实验,其中包括 ImageNet 等大规模基准测试。LocalProp 在仅使用 GPU 峰值内存一部分的情况下取得了良好结果。文中未说明具体占比。实用的选择标准:当端到端反向传播受限于 GPU 内存时,适合使用 LocalProp。联合优化的块数可以用来调整这种平衡。