
LightCRS:无需为每个类别单独配置 VLM 的紧凑型多领域对话推荐框架
作者介绍了一种系统:商品多模态特征由冻结的编码器离线计算,在对话中则由一个跨所有领域共享的、拥有 530 万参数的模块进行处理,并采用依赖于查询的交叉注意力。在涵盖 25 个领域的基准测试中,该方法提升了平均排序指标,显著降低了延迟,并表明联合训练优于单独训练的单领域模型。
任务:无需为每个领域单独配置 VLM 的对话式推荐
LightCRS 是一个轻量级多模态对话式推荐系统,支持多个领域。该研究由 He Ma、Lan You、Qiyang Wu 和 Chen Liu 完成。预印本 arXiv:2610.26948 于 2026 年 10 月 18 日提交。
主要特点:
- 对话式工作模式。
- 商品多模态数据。
- 一个系统覆盖多个领域。
- 轻量级架构,无需为每个类别单独配置 VLM。
该系统用于在对话中选择商品。用户希望在多个领域中获得推荐。实践中,可关注支持多个领域且无需为每个类别单独配置 VLM 的方案。
架构:离线编码器与 5.3M 参数的共享模块
在 LightCRS 中,商品的多模态表示会提前离线计算,使用的是冻结编码器。
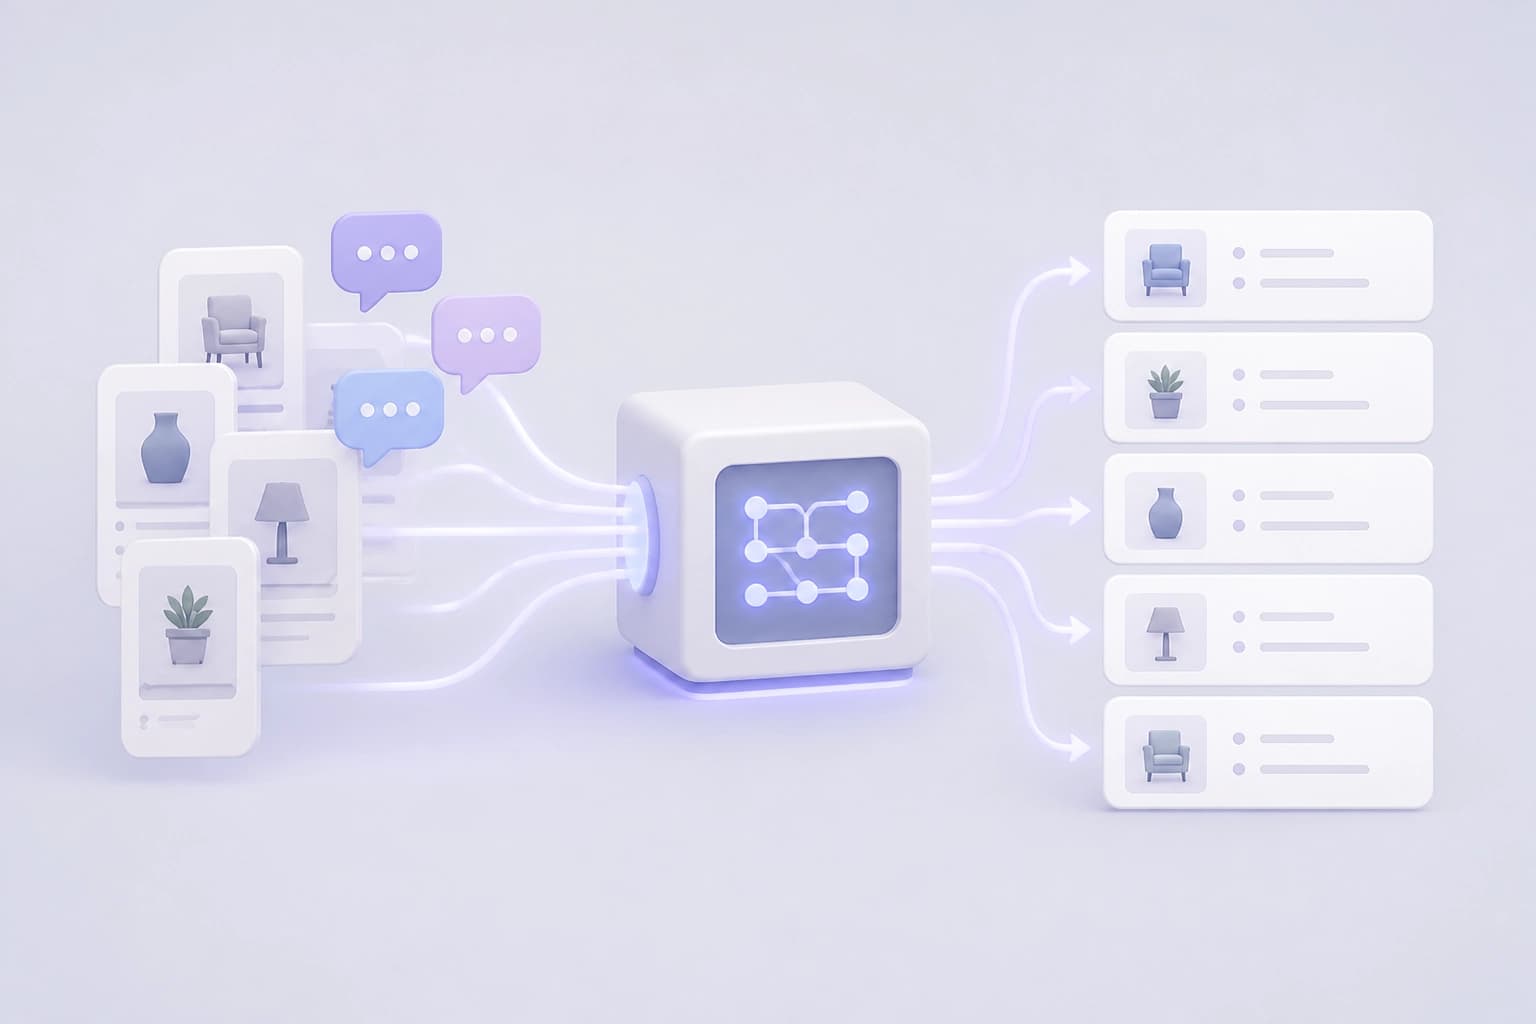
运行时阶段:
- 一个包含 5.3M 参数的紧凑模块会整合对话信息。
- 查询与表示之间通过 query-conditioned cross-attention 建立联系。
- 候选商品由 inter-candidate Transformer 联合比较。
该模块的参数在所有领域间共享。实践中,可检查哪些组件被移至离线处理,以及运行时保留了多少参数。对于多领域方案,关键在于使用共享模块,而不是一组单独的模型。
多领域能力:共享参数与联合训练
LightCRS 为所有领域使用一组共享参数。这是它与每个类别单独使用一个模型的方案之间的关键区别。
| 训练方案 | HR@1 |
|---|---|
| 在多个领域上联合训练 | 比单领域模型高 +15.2% |
| 分别训练的单领域模型 | 对比基准 |
联合训练是一个独立因素。实践中,可通过 HR@1 比较共享的多领域模块与一组单领域模型。联合训练的效果应通过测量得出,而不应想当然。
MM-R2A-25 基准:来自 Reddit 和 Amazon 的 25 个领域
作者创建了 MM-R2A-25 用于评估。
基准数据构成:
- 25 个领域。
- 来自 Reddit 的自然对话,用户在其中寻求推荐。
- Amazon 商品列表。
LightCRS 在该数据集上进行评估。该基准会在不同领域和自然对话上测试系统,不局限于一种商品类型。
实践中,可关注系统在哪些领域和对话上进行了评估。与只报告单一类别结果相比,多领域基准更有参考价值。
结果:HR@1、NDCG@5、MRR 和延迟
LightCRS 与基线方法按三项指标和延迟进行比较。
| 指标 | LightCRS 的结果 |
|---|---|
| HR@1、NDCG@5 和 MRR 的平均结果 | 最佳 |
| 相较于最强基线的 HR@1 | +35.4% |
| 单次请求延迟 | 降低 266 倍 |
在所述比较中,质量提升的同时,延迟也大幅降低。实践中,不应只看 HR@1,还应关注 NDCG@5、MRR 和延迟。单一指标无法体现质量与延迟之间的权衡。
选择类似方案时应检查的内容
- 所有领域是否共享参数。
- 是否使用冻结编码器离线编码多模态表示。
- 运行时模块的大小:LightCRS 为 5.3M 参数。
- 是否通过 inter-candidate Transformer 联合比较候选商品。
- 是否使用 HR@1、NDCG@5、MRR 和单次请求延迟等指标,在多领域对话上进行评估。
实践中,应要求提供已发布的指标和基准测试条件。当领域数量较多且运行时系统需要保持轻量时,共享紧凑模块的方案值得关注。
常问问题
相关材料
所有材料
基于编译器诊断的 Lean 4 战术有限修复
该模块采用逐步处理方式,不会丢弃被拒绝的策略,而是根据 Lean 报错最多让纠错模型修正 R 次;在有 K 个候选项时,这能提高问题求解率。LeanDojo 和 Lean Workbook 上的实验表明,提升主要来自对浅层执行失败的修复,代价是搜索时间增加。
16 十一月 2026
Genesis Steering 方法:基于微调数据的激活控制
该方法从微调数据中已有的对比样例提取控制向量;若无法获取这些样例,则通过成员推断筛选可能的训练样本,并构建代理数据集。理论部分阐述了朝决策边界进行最优偏移的方法以及基于代理数据的评估;实证结果表明,Tülu-3-8B 的内部数据比外部数据集效果更显著,而 MIA 代理数据在 Llama-3.1-8B-Instruct 上的效用则受方向偏移之间关系的限制。
16 十一月 2026
基于稀疏专家的表格上下文学习:紧凑型 OrionMoE-Small-v1.0
这是一款面向表格任务的紧凑型基础模型,可根据已标注的参考表格预测新观测,无需微调参数。结合数据集和特征表示进行自适应专家选择,能够取得具有竞争力的效果,尤其是在上下文较少、维度较高时。
15 十一月 2026