
基于稀疏专家的表格上下文学习:紧凑型 OrionMoE-Small-v1.0
这是一款面向表格任务的紧凑型基础模型,可根据已标注的参考表格预测新观测,无需微调参数。结合数据集和特征表示进行自适应专家选择,能够取得具有竞争力的效果,尤其是在上下文较少、维度较高时。
上下文学习表格:模式要点
模型根据带标签的支持表格预测未见样本。模型不会针对特定任务更新参数。本文介绍 OrionMoE-Small-v1.0——一款用于上下文学习的紧凑型表格基础模型。
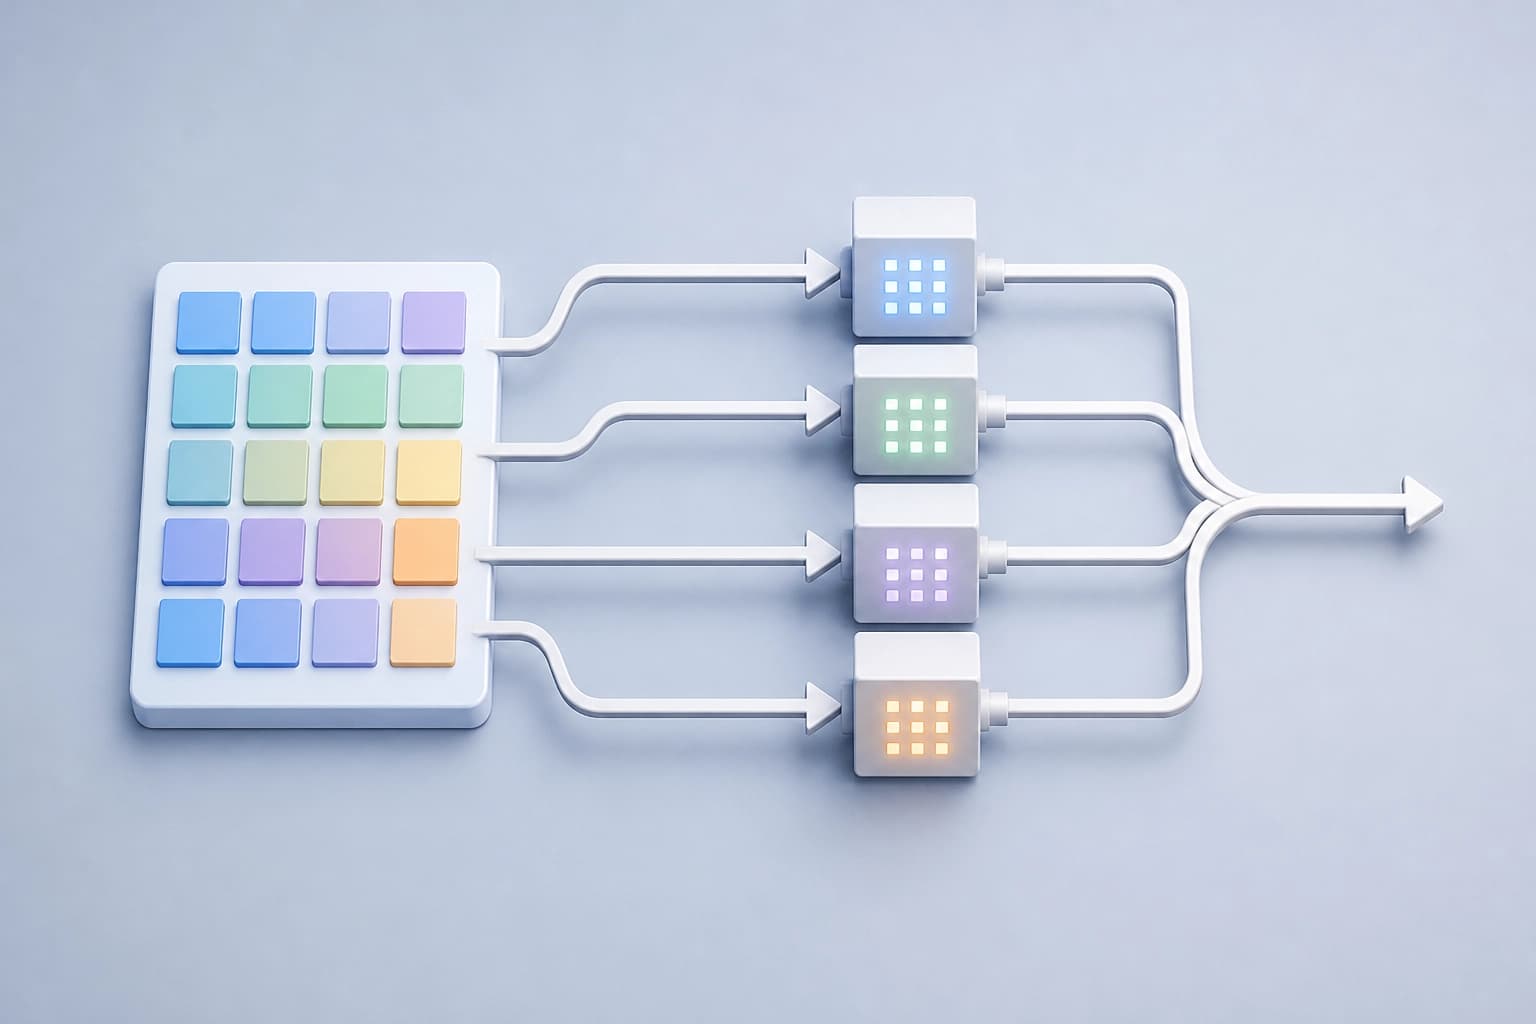
该模式的关键要素:
- 输入 — 带标签的支持表格;
- 目标 — 预测未见样本;
- 适配 — 不针对特定任务更新参数;
- 模式 — 上下文学习。
实用判断标准:任务能够通过带标签的支持表格进行预测。无需针对任务进行梯度适配。
架构:双轴 Transformer 与稀疏专家
OrionMoE-Small-v1.0 采用双轴 Transformer 架构。模型结合了考虑数据分布的表示与稀疏混合专家计算。这些计算由数据集驱动。激活专家的选择会考虑单元格表示以及整个数据集的上下文。
模型构成:
- 架构 — 双轴 Transformer;
- 表示 — 考虑数据分布;
- 计算 — 由数据集驱动的稀疏混合专家;
- 专家选择 — 基于单元格表示和数据集上下文;
- 计算分配 — 在异质表格任务之间自适应调整;
- 计算路径 — 不同任务共用。
实用判断标准:异质表格任务需要自适应分配计算资源。模型为不同任务保留了通用计算路径。
训练:合成分类任务
模型仅在合成分类任务上进行了预训练。这些任务基于结构化因果先验分布。对于下游任务,模型无需梯度适配即可进行预测。注释中给出了 OrionMoE-Small-v1.0 这一名称。
论文作者:Mohamed Bouadi、Nassim Bouarour、Aditya Tanna、Vinay Kumar Sankarapu。作者于 2026 年 10 月 14 日提交论文。最新修订版于 2026 年 10 月 18 日发布。论文版本为 v2。
关于训练已知的信息:
- 数据 — 仅包括合成分类任务;
- 基础 — 结构化因果先验分布;
- 下游任务 — 无需梯度适配。
实用判断标准:来源描述的预训练仅基于合成分类任务。对于其他类型的任务,来源未提供相关事实。
结果与适用标准
OrionMoE-Small-v1.0 在多个表格基准测试中取得了有竞争力的结果。比较对象是规模大得多的基础模型。分析指出,该模型在上下文较少、维度较高的数据集上表现尤为出色。进一步分析显示,模型在类别不平衡情况下的相对表现较好。
| 场景 | 分析结果 |
|---|---|
| 与规模大得多的基础模型比较 | 有竞争力的结果 |
| 上下文较少、维度较高 | 表现尤为出色 |
| 类别不平衡 | 相对表现较好 |
| 特征组合 | 分析指出其重要性 |
实用判断标准:上下文较少、维度较高是模型表现尤为出色的条件。类别不平衡和特征组合是分析中单独列出的要点。
常问问题
相关材料
所有材料
针对预测结果不可靠的用户画像进行协变量偏移的局部搜索
本文介绍了一种诊断流程:首先识别模型置信度较低且具有可解释性的患者群体,然后在这些群体中检测是否存在有害的协变量偏移。在 MIMIC-IV 上针对三项临床任务和三种人工构造的子群体偏移进行的实验表明,该方法能够定位在聚合评估中不易察觉的年龄偏移。
15 十一月 2026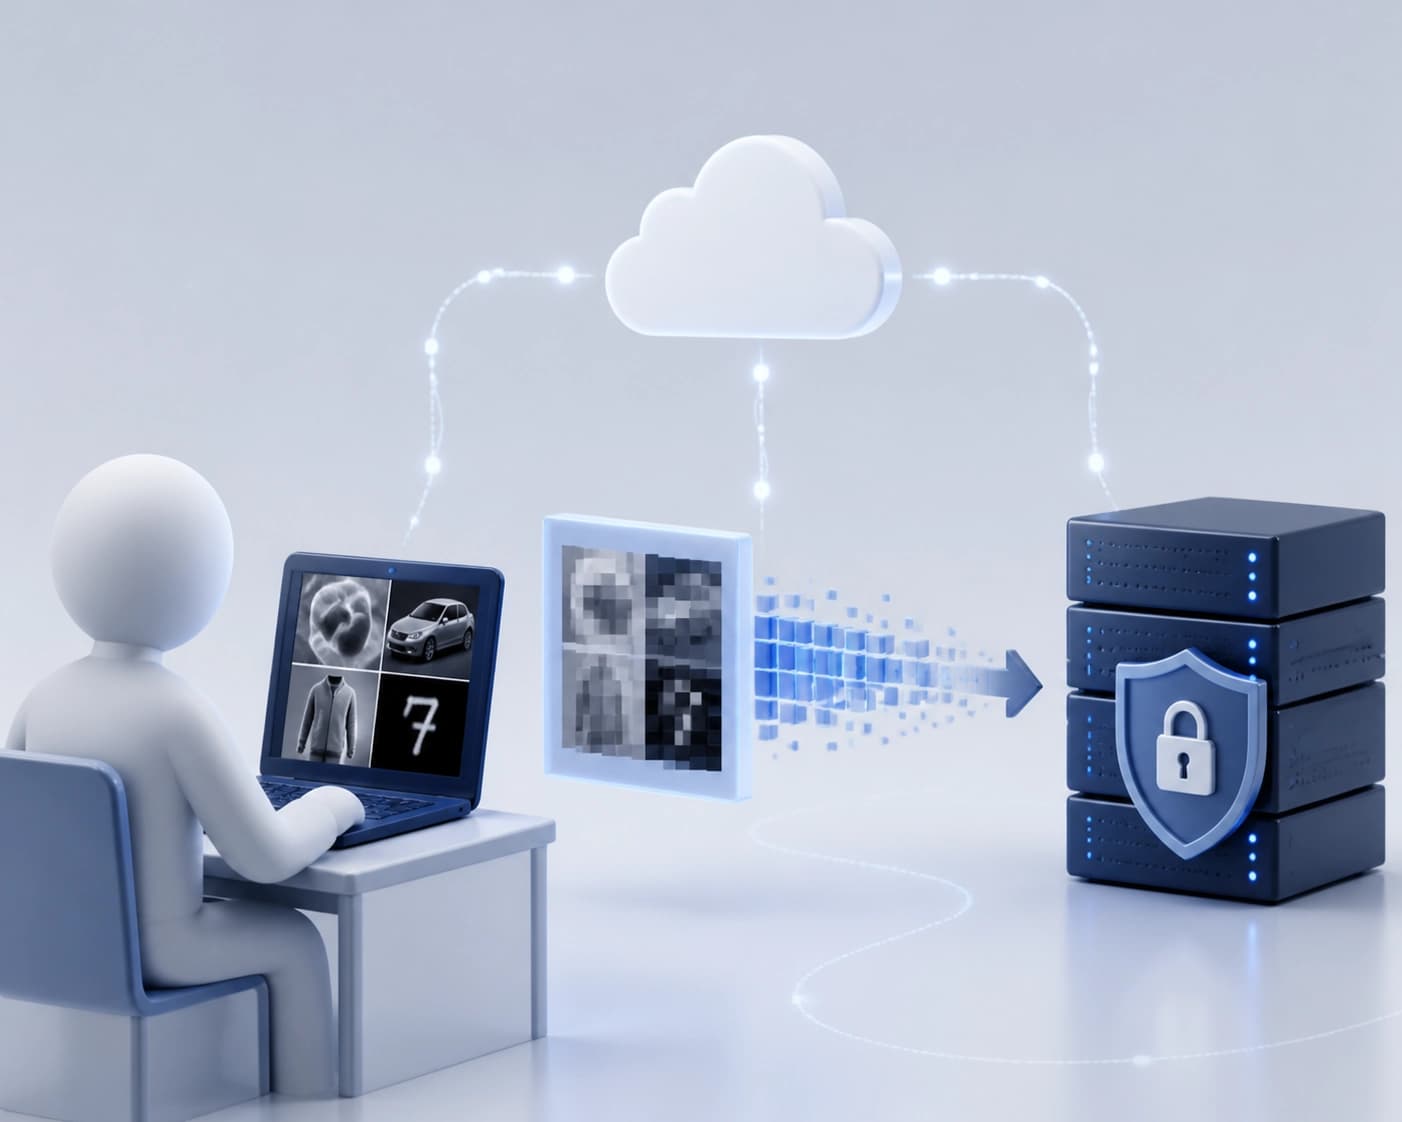
FedPix:从客户端传输压缩图像,以减少联邦学习中的信息泄露
本文探讨了应允许客户端向服务器发送哪些信息,并建议训练系统传输紧凑且可通过视觉检查的图像,而非模型权重或中间表示。在 BloodMNIST、CIFAR-10、FashionMNIST 和 MNIST 上,该方法的重建 PSNR 较低,并将客户端耗时缩短至原来的 96.0%,准确率为 65.63–99.18%。
15 十一月 2026
MaRK:预训练 SSM 中循环参数的上下文调制
提出了一种方法,通过低秩参数更新使冻结状态空间模型的递归算子适应上下文,并在每个生成步骤影响“输入—输出”核。对三种适配器几何结构的比较表明,切比雪夫多项式的验证误差更低,而受限参数化则支持对稳定性进行解析检验。
14 十一月 2026