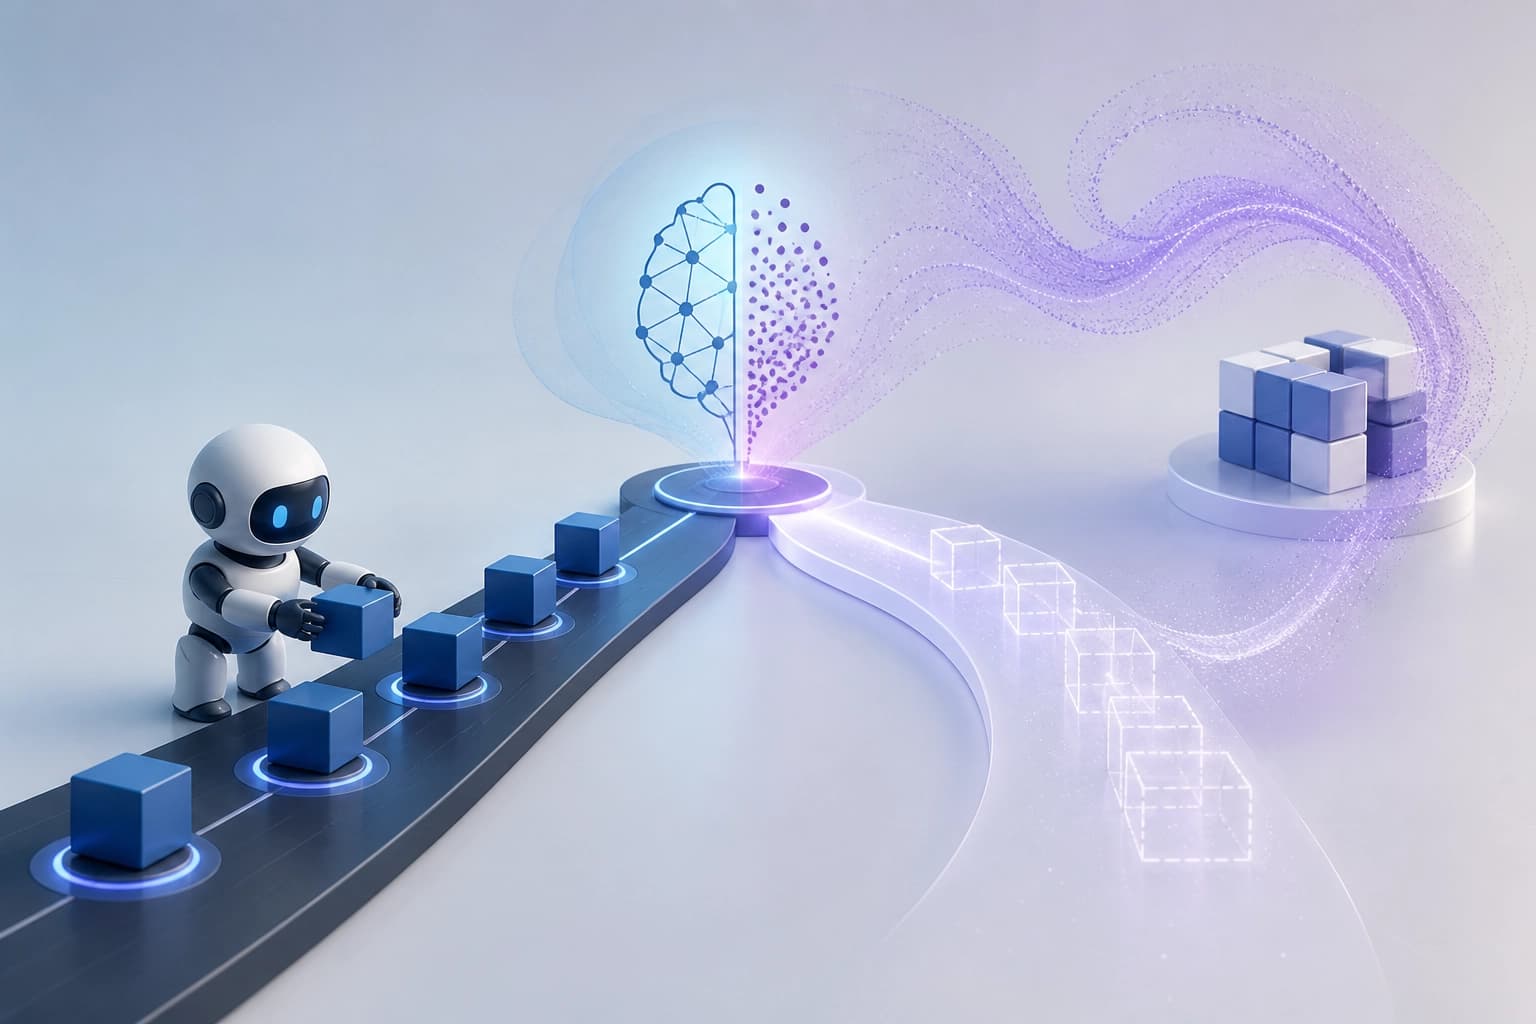
HyCO 的核心
HyCO 是 Hybrid Neural Solver for Combinatorial Optimization(用于组合优化的混合神经求解器)。该方法先用 RL 求解器构建解的前缀,然后自适应地切换到条件扩散模型,由后者补全剩余的解。这种混合方法用于求解神经组合优化问题,其目标是结合两类求解器各自的优势。
该工作以 arXiv:2609.07990 发布。作者:Yuheng Li、Di Yang、Haipeng Chen、Yanhai Xiong。该预印本属于 cs.LG 和 cs.AI。作者于 2026 年 9 月 7 日提交了 v1 版本。这些信息有助于找到原始出处并核实细节。
实际意义:HyCO 并非用某个求解器取代另一个,而是管理两者之间的切换。
单一策略在哪里失效
Sequential RL 求解器与全局 DM 求解器表现出互补的失效模式。这在优化 regret 中可以看到。
| 求解器类别 | 优势 | 弱点 |
|---|---|---|
| Sequential RL | 在构建早期阶段边际 regret 较小 | 误差沿时间跨度累积;regret 呈超线性增长 |
| Global DM | 避免沿时间跨度的累积 | 相对于剩余未求解子空间的维度,regret 呈线性或次线性 |
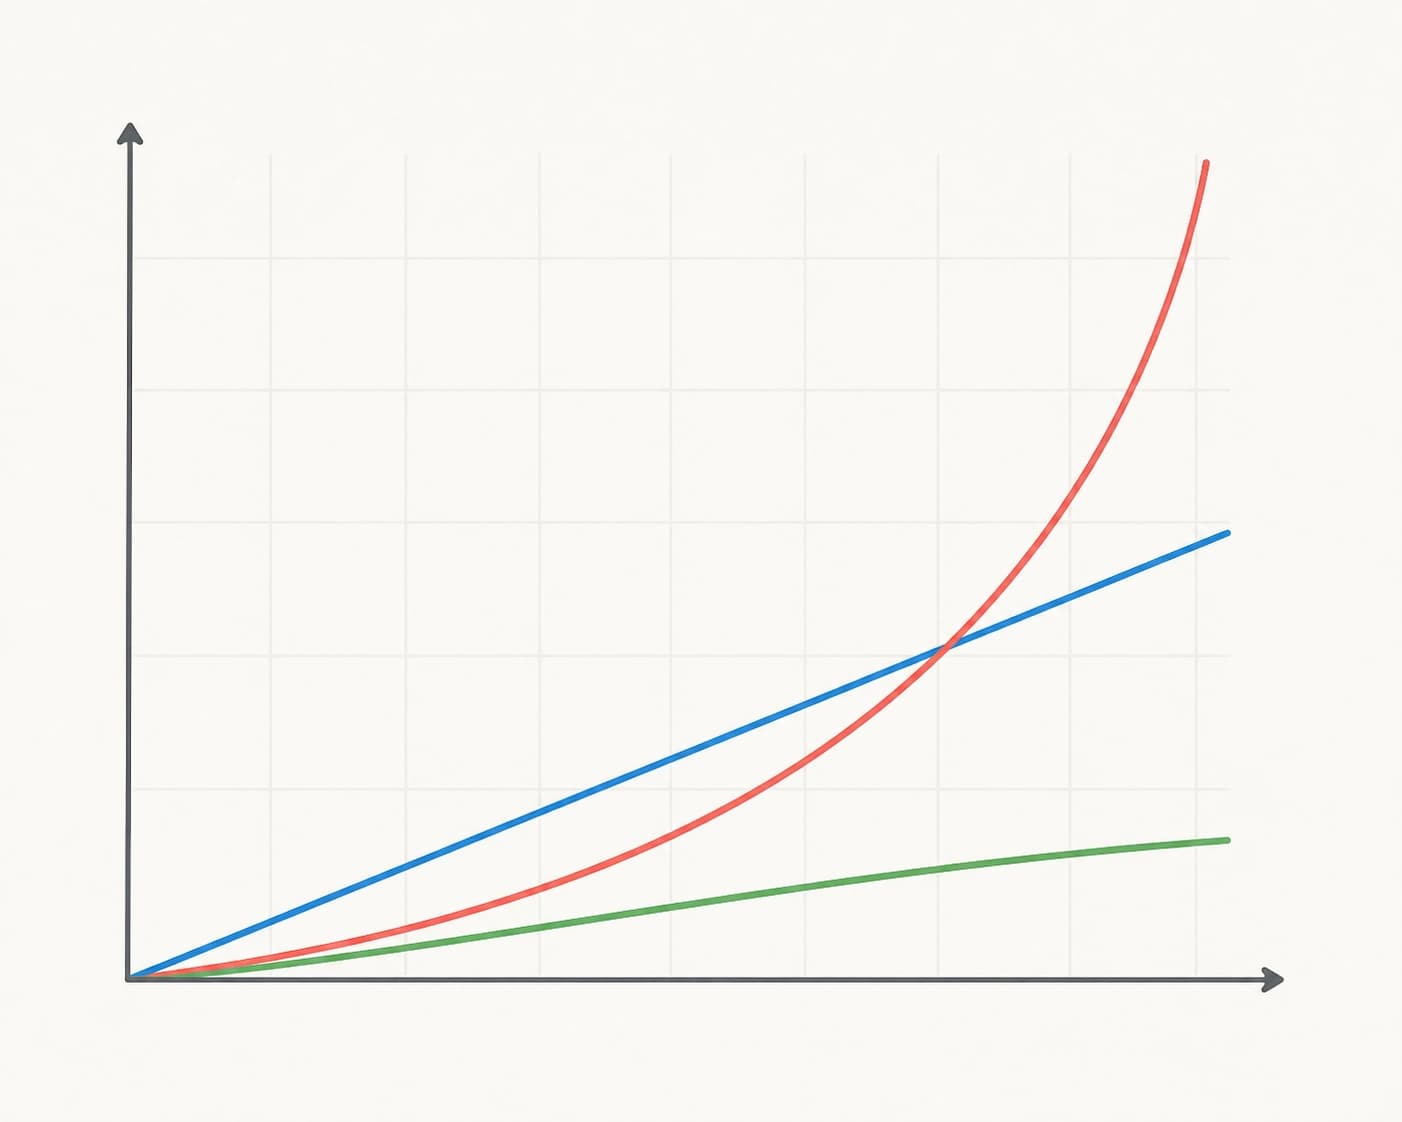
结论:两者的失败并不重合。RL 在早期表现良好,但受制于时间跨度。DM 不会累积时间跨度上的误差,但会为剩余问题的规模付出代价。混合方法正是利用这一差距。
切换的理论框架
作者构建了一个统一的误差缩放理论框架。在对误差缩放作出明确假设的前提下,该框架证明了两个结论。
- 混合结构给出的期望 regret 严格小于两种基础方案各自单独给出的结果。
- 存在唯一的最优切换步,可使混合方法的 regret 最小化。
作者在期望 regret 的层面上定义最优步。在单条轨迹上无法直接计算它。因此需要一个实用的触发条件。
结论:理论回答了混合方法为何有帮助,以及何时启动交接。它并未给出适用于每条轨迹的现成公式。
自适应触发器如何工作
HyCO 使用一个轻量的自适应触发器。该触发器结合策略熵与 RL-DM 散度。这些信号在轨迹层面识别模式切换。它们充当实用的代理指标。之所以需要这样的代理指标,是因为最优切换步无法在单条轨迹上计算。
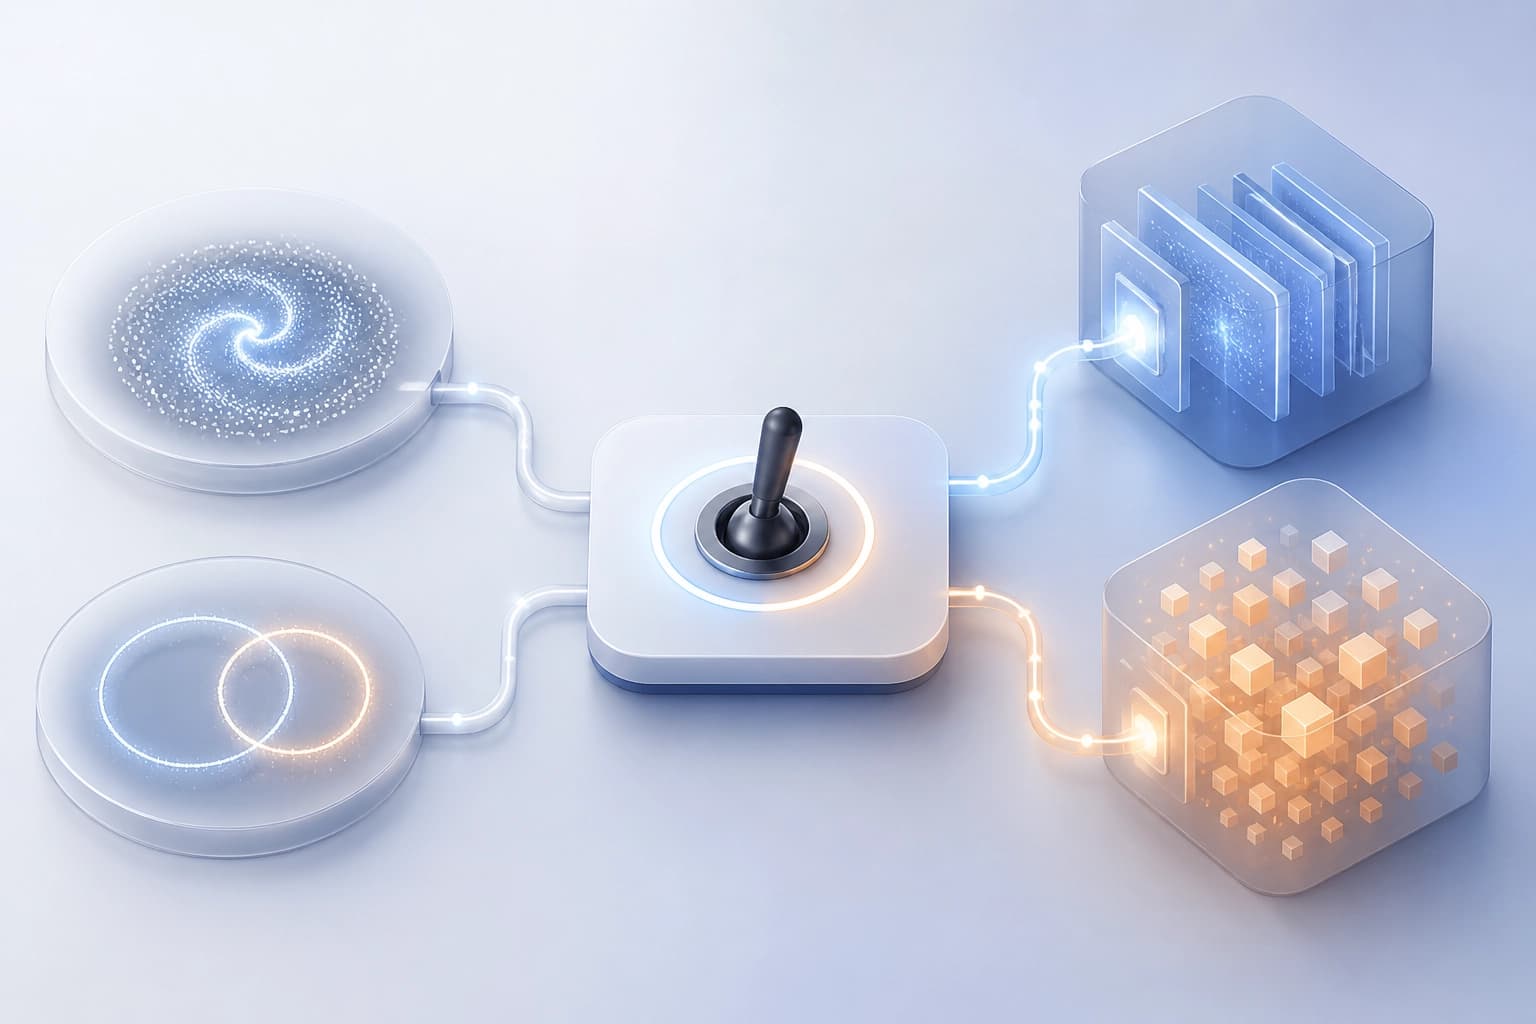
触发器终止 RL 前缀。条件 DM 补全剩余的解。实用准则:关注策略熵与 RL-DM 散度。这些信号指示模式切换与交接时机。触发器保持轻量且自适应。
实验与选择准则
在多种基准上的实验中,HyCO 相对于两种基础求解器都带来稳定的提升。结果也证实了自适应触发器的经验有效性。
实用选择准则:需要一个用于组合优化的推理算法。它使用 RL 处理早期前缀,使用 DM 处理剩余的解。该混合方法相对于每种基础方案都降低了期望 regret。HyCO 适合作为叠加在 RL 搜索与扩散补全之上的切换层。它管理两者之间的过渡。