
混合式图像标注:自动化加速计算机视觉模型训练
本文介绍了算法预标注如何减少人工工作并提高训练数据集的整洁度,以及为什么人工抽样验证仍然不可或缺。文中还探讨了该方法在拍摄条件恶劣和罕见物体类型上的局限性。
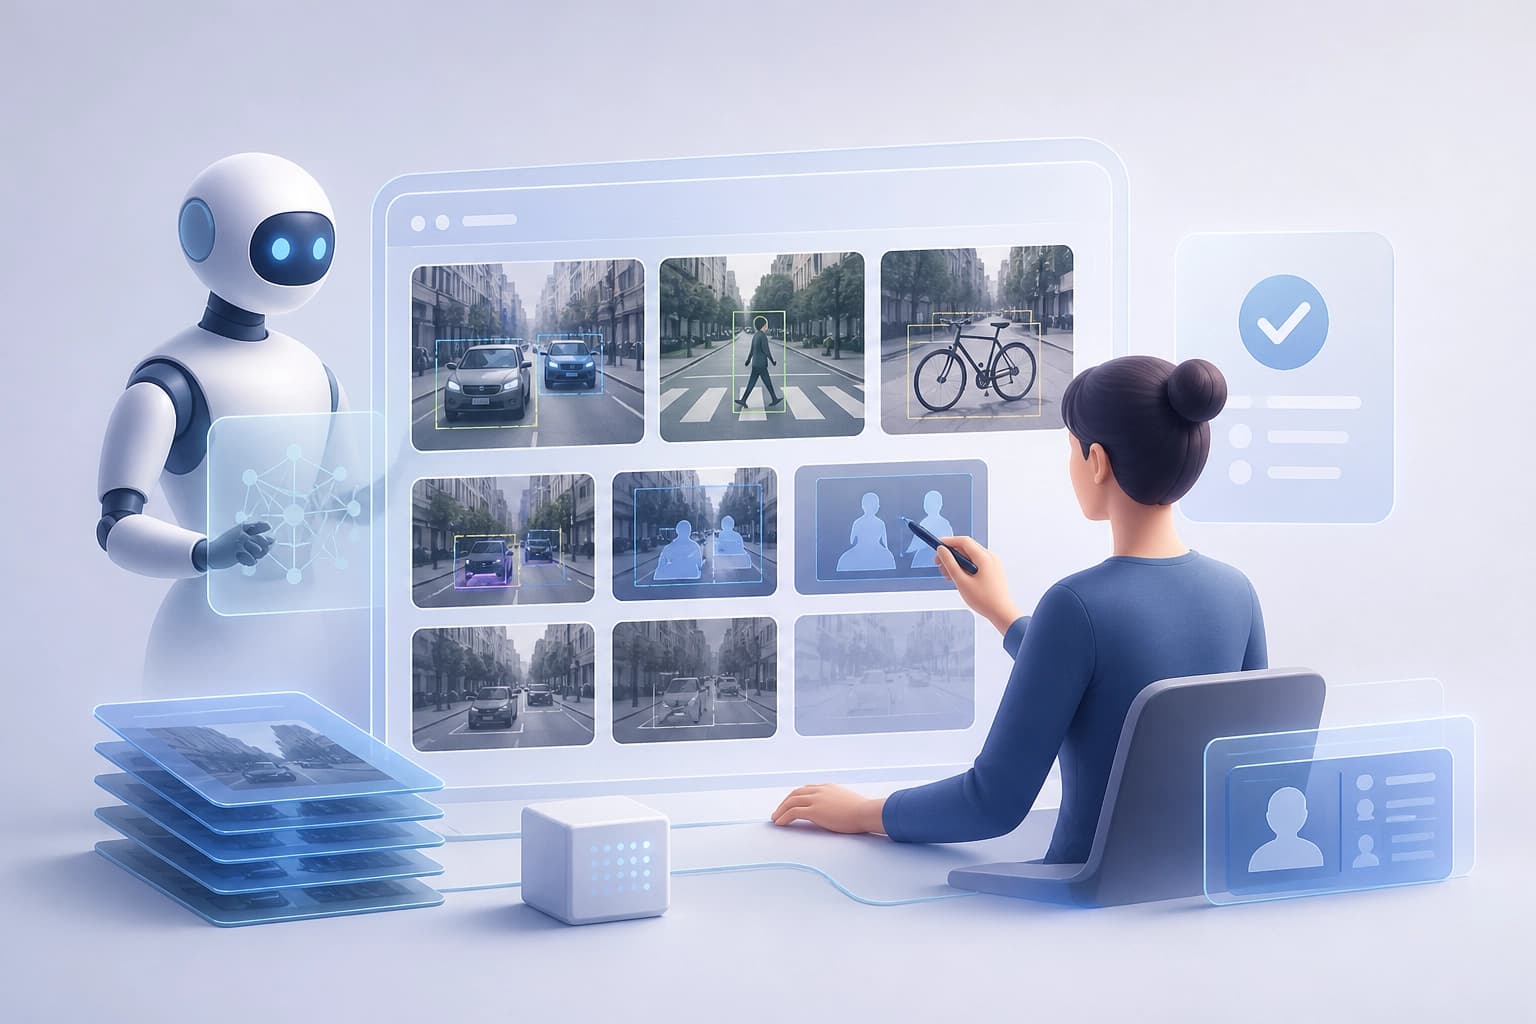
为什么人工标注会限制计算机视觉训练
计算机视觉依赖经过标注的图像进行训练。长期以来,标注一直是这类系统开发中最耗时的环节。现代 AI 模型要想表现良好,需要数百万张经过标注的图像。
人工劳动跟不上这样的工作量。因此,标注成为模型训练的瓶颈。人工标注无法满足现代模型的需求。
混合标注的工作原理
自动化工具使用预训练模型。它们无需人工逐像素处理,就能标注新的图像。人工负责检查和修正结果,而不是从头开始标注。
混合标注的步骤:
- 使用预训练模型进行自动预标注。
- 人工检查并修正结果。
混合方案结合了自动化的速度和质量控制。
标注自动化能处理哪些任务
自动化可以执行多种类型的标注。任务包括:
- 目标检测和边界框标注;
- 语义分割;
- 实例分割;
- 图像分类;
- 关键点和姿态估计;
- 视频帧标注。
自动化覆盖了计算机视觉的主要任务。
与人工标注相比,混合方法有哪些优势
| 标准 | 纯人工 | 混合方法 |
|---|---|---|
| 标注时间 | 比较基准 | 可将标注时间缩短近 40% |
| 错误率 | 可能比混合方法高出 25% | 错误率更低 |
| 数据集扩展 | 需要按比例增加标注人员 | 可扩大数据集,而无需按比例增加人员 |
混合方法更快、更准确,也更易于扩展。
自动标注的应用领域
自动标注应用于:
- 自动驾驶汽车;
- 医学影像;
- 零售和电子商务;
- 农业和制造业。
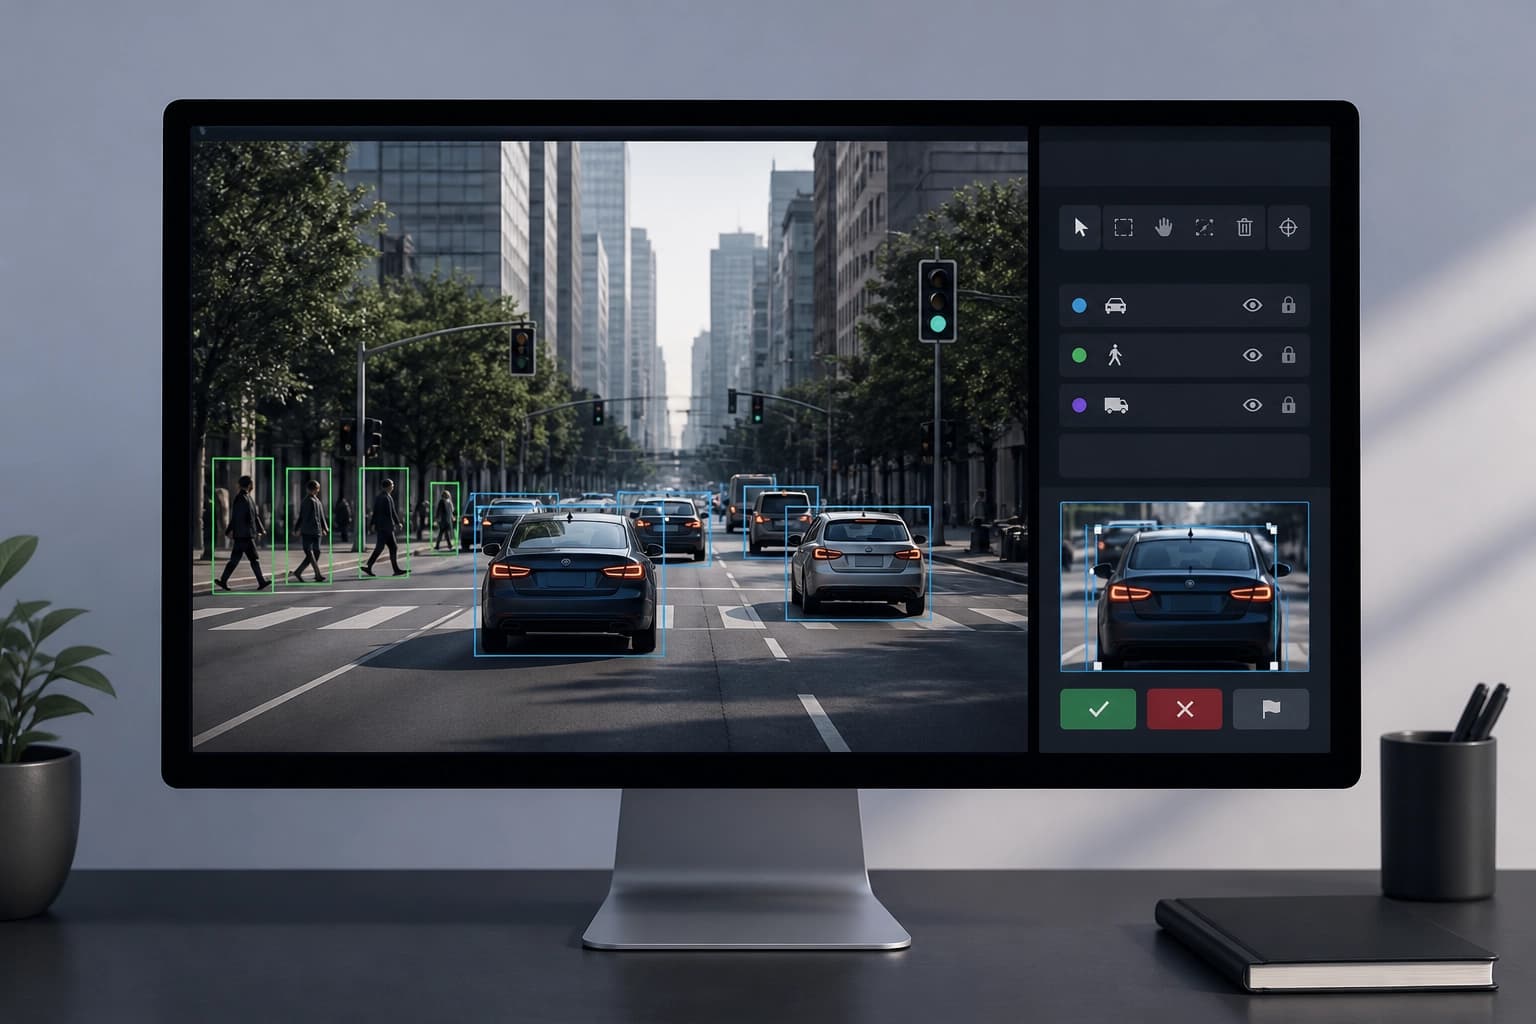
在高风险行业中,标注质量尤为重要。行人数据中的错误会给自动驾驶汽车带来安全风险。肿瘤边界标注不一致,可能导致医疗模型漏诊。
自动标注的局限性
在光照异常、目标遮挡、目标类别罕见以及非典型情形下,自动化系统仍可能出错。训练数据中的偏见也可能延续到自动标注结果中。
因此,自动化被视为初始步骤。人工检查仍不可或缺,尤其是在医疗领域。在错误代价高昂的场景中,混合方案必不可少。
选择标注方案的实用标准
选择标准:
- 错误代价高(安全、医疗)时,需要人工检查。
- 若要在不按比例增加标注人员的情况下扩大数据量,可采用自动预标注。
- 对于小型公司,云端标注服务和开源模型可以降低入门门槛。
标注方案应根据错误代价和扩展需求来选择。
常问问题
相关材料
所有材料
十五家公司支持 MDK Tether,实现挖矿自动化
设备制造商、矿池和运营商已着手基于 Tether 开放工具集开发集成,以统一设备监控和管理;AI 代理 QVAC 已在此基础上运行。目前尚未发布有关降低电力成本或提高效率的独立验证。
2 十一月 2026
代理替代独立优化器:一个可在多项任务中同步发展的统一框架
作者展示了,同一个冻结模型在固定版本的封装上,先完成任务,随后依据完整的运行日志自行编辑代码。对一个包含 49 行的框架进行多任务演化后,模型在分布内任务和留出的基准测试中表现提升,并在其中部分基准上超越了 Codex。
29 十月 2026
LLM配对对话:与现有观点一致比灌输新观念更能加剧激进化
arXiv:2609.38296 预印本的作者模拟了这样一种对话:目标模型扮演人类角色,而网红代理则试图将其立场推向极端。两种情境——强化已有观点,以及推动原本次要的观点——都使情感和行为量表出现偏移,其中前者的效果更稳定。
27 十月 2026