为什么 LLM 在观测不完整时会出错
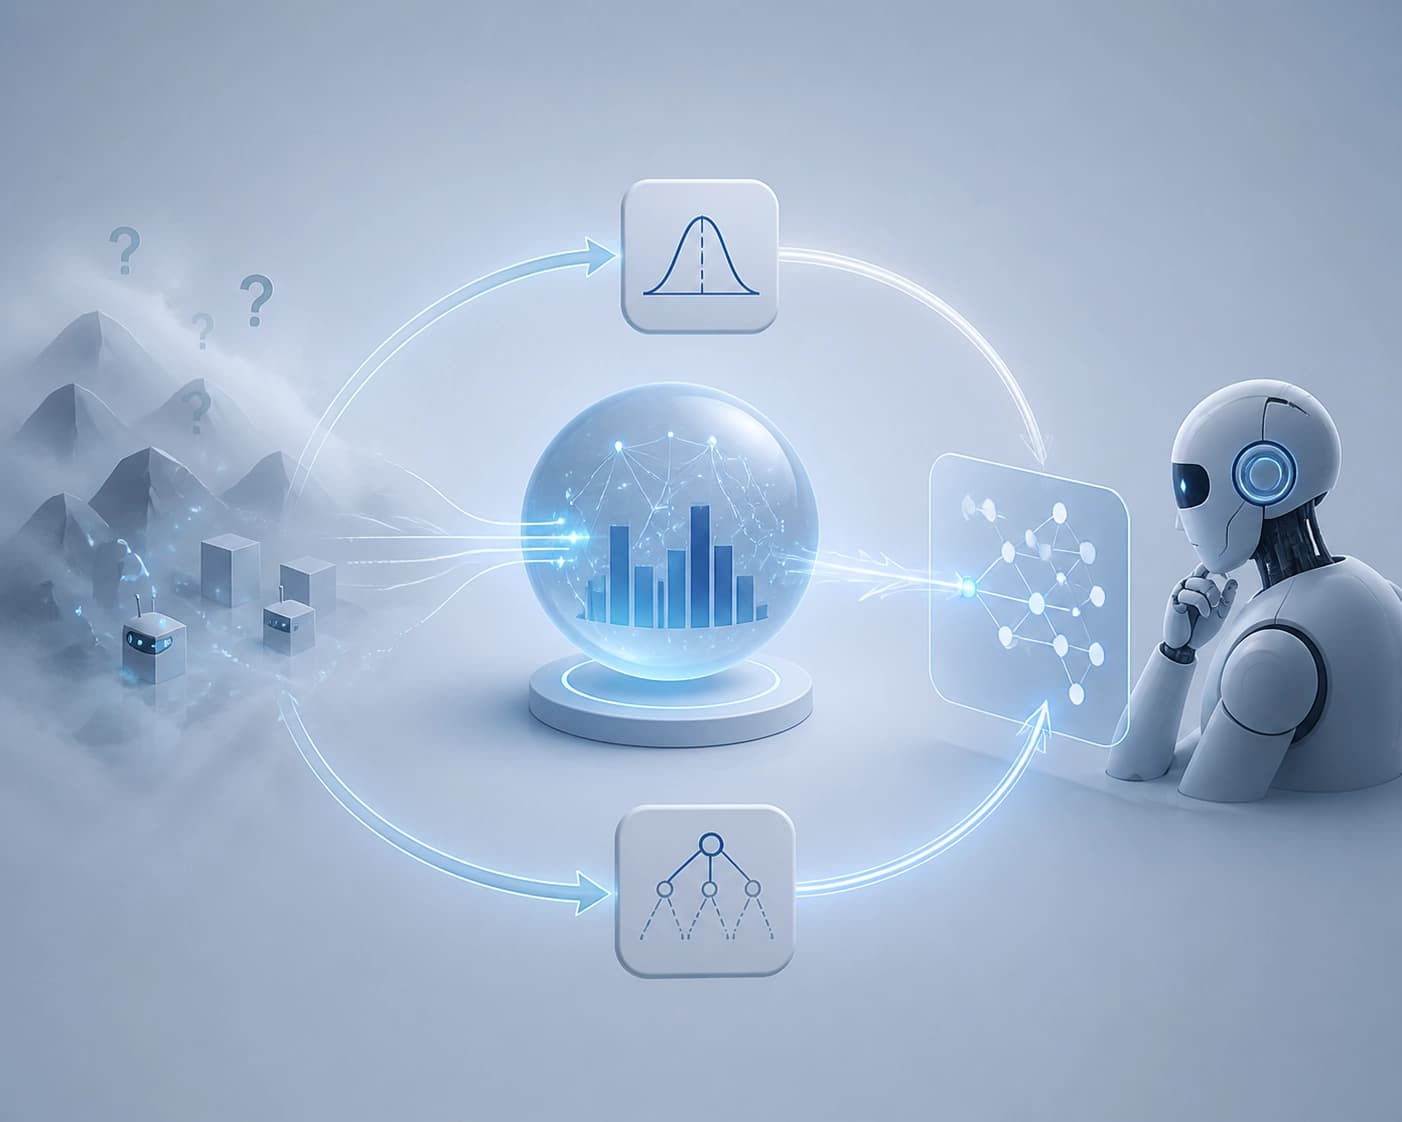
作者将 LLM 智能体在部分可观测环境中的错误归因于缺少对隐藏状态的显式信念分布。通常,智能体会根据行动和观测历史采取策略。
文章描述了三种典型错误:
- 在反馈含糊不清时过早做出决策;
- 在获得信息丰富的观测后转向错误的假设;
- 随着历史记录增长,策略发生漂移。
问题不只是单次查询的回答质量。智能体缺少对哪些隐藏状态可能存在的显式表示。
外部贝叶斯回路如何工作
Belief-State Engine (BSE) 是一个在 LLM 外部进行推理的模块。它会根据给定 POMDP 模型——部分可观测马尔可夫决策过程——维护关于隐藏状态的贝叶斯后验分布。
每一步中,回路的工作方式如下:
- BSE 更新关于隐藏状态的信念分布。
- LLM 只接收该分布。
- 原始行动和观测日志不会提供给 LLM。
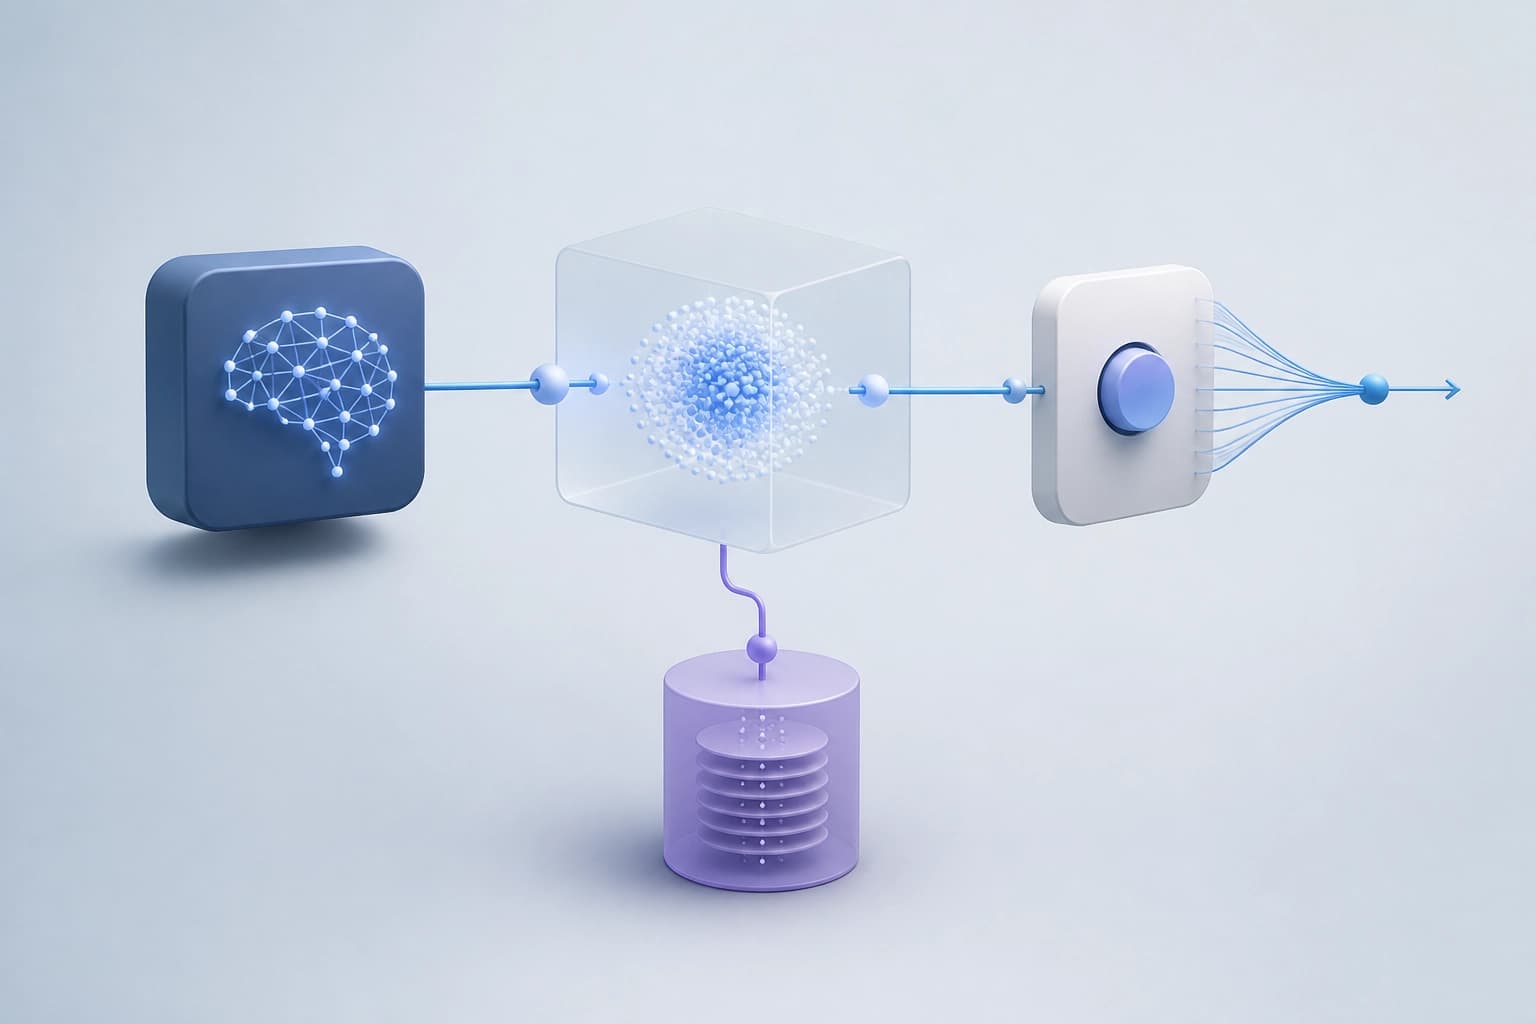
这种方法将不确定性处理与语言模型分离。该架构的关键条件是:LLM 不会接收原始历史记录。
哪些保证取决于架构
作者为与信念一致的内部状态设定了由四条公理构成的最低规格。此处不披露公理的内容。
作者证明,LLM 与 BSE 的组合在由原始 POMDP 导出的 belief MDP 上构成一个正确的马尔可夫策略。如果 LLM 永远无法访问原始历史记录,那么这一组合就继承了经典 POMDP 理论中的贝尔曼最优性保证。
实践标准:这些保证适用于所描述的组合,并取决于对历史记录访问的限制。它们不能脱离架构条件单独看待。
评估结果
研究人员在 Tiger POMDP 和 red-team 攻击图任务上测试了该架构。对比评估涵盖了六种基线方法。
| 基线方法 | BSE 在两个领域中的结果 |
|---|---|
| Reactive LLM | 任务回报更高、信念校准更好、决策一致性更强 |
| Chain-of-Thought | 任务回报更高、信念校准更好、决策一致性更强 |
| ReAct | 任务回报更高、信念校准更好、决策一致性更强 |
| 自然语言信念跟踪器 | 任务回报更高、信念校准更好、决策一致性更强 |
| QMDP | 任务回报更高、信念校准更好、决策一致性更强 |
| POMCP | 任务回报更高、信念校准更好、决策一致性更强 |
摘要还声称,该效果并不局限于某一种模型。十项目标消融实验旨在区分各项架构决策的独立贡献。
何时适合考虑这种方法
BSE 会维护给定 POMDP 的隐藏状态分布。因此,能否在此类模型框架内描述问题,是判断这种方法是否适用的核心标准。
文章中的评估涵盖了上述两个领域。它并不能证明结果可以推广到任何数据不完整的任务。
可供核查的内容
预印本 Belief-State Engine: Augmenting LLMs for Principled Planning Under Partial Observability 附有代码、环境规格、提示模板和 seed 日志。
Arnab Chattopadhayay 和 Debdipta Halder 于 2026 年 9 月 9 日将论文提交至 arXiv。评估其实践意义时,应结合文中描述的环境、对比方法以及 LLM 访问历史记录的条件。