什么是黑盒评估
黑盒方法评估智能体系统的可观察行为。评估只需要系统的基本描述,无需特权访问权限。
这种方法将可观察行为与风险类别关联起来。即使无法访问内部机制,也可以进行评估。
实践标准:如果无法获得特权访问权限,但可以提供系统的基本描述,就选择黑盒测试。
评估由哪些部分组成
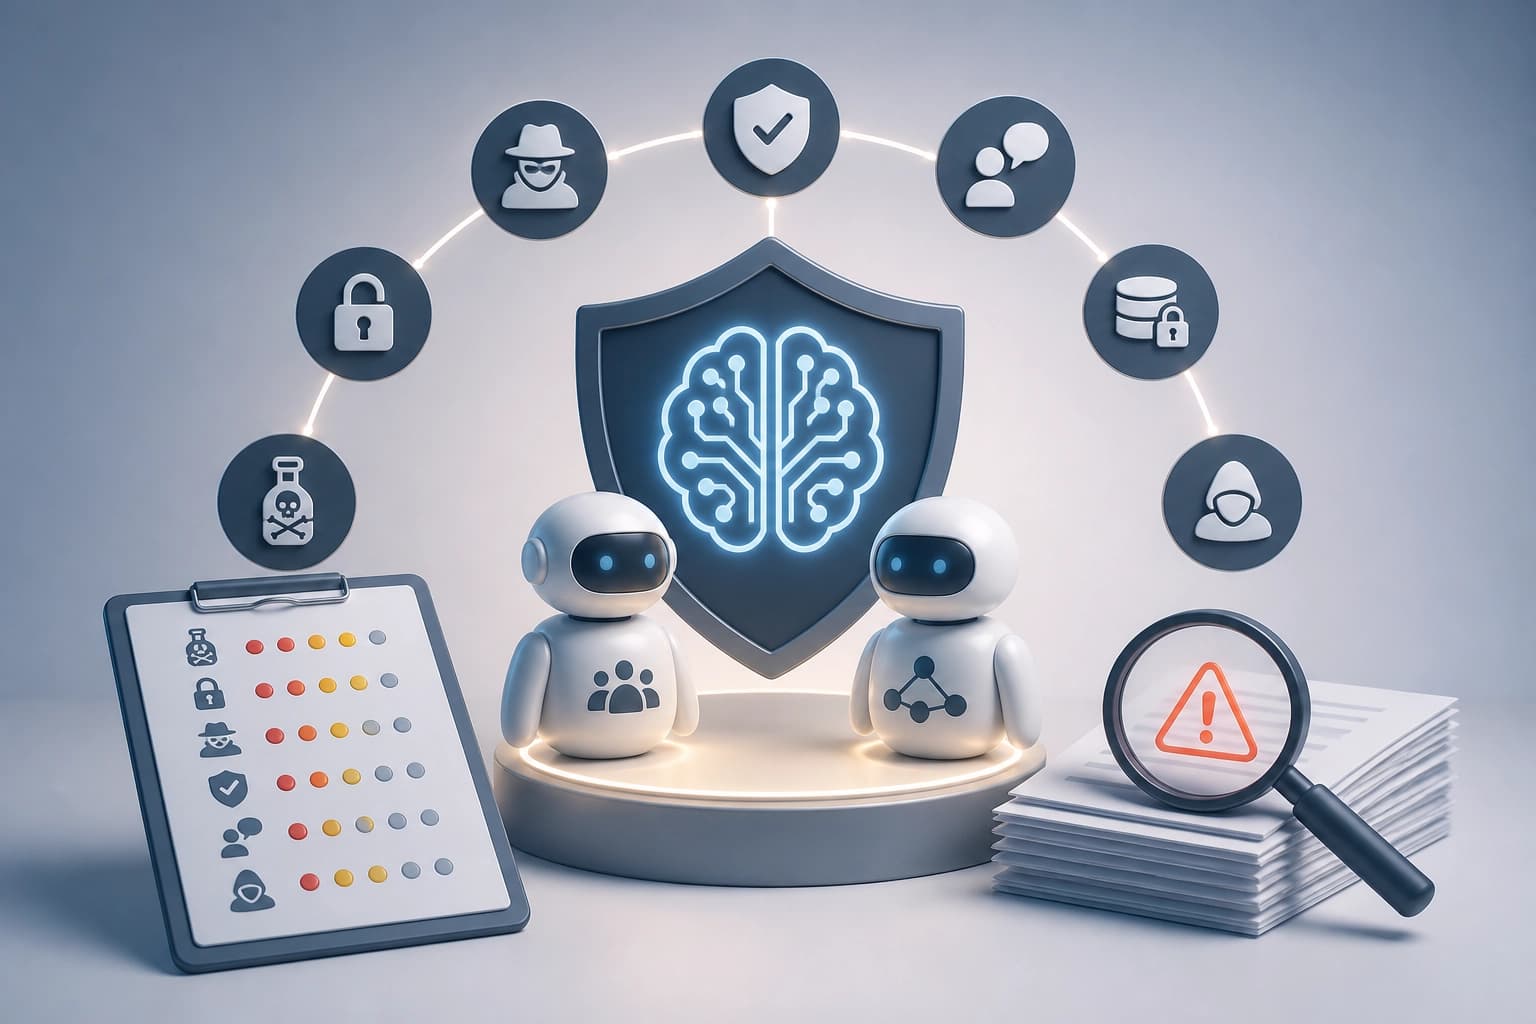
该框架结合了风险分类体系和自动化红队测试。作者提出了七个领域,将智能体行为与风险类别关联起来。
SAGE-RT 为每个领域生成 120 个对抗性场景。评估还包括人工验证和 LLM 评审器。
- **分类体系:**七个风险领域。
- **场景:**针对每个领域进行自动化红队测试。
- **结果验证:**人工验证和 LLM 评审器。
选择标准:如果需要自动生成场景,并由人类和 LLM 评审器进行后续验证,那么该方法就符合任务需求。
评估结果
作者测试了两种智能体架构——CrewAI 和 AutoGen——以及四种基础模型。
| 指标 | 结果 |
|---|---|
| 平均治理风险 | 56,25% |
| 多智能体配置中的隐私风险 | 65% |
| 智能体行为漏洞 | 最高 85% |
这些数值代表不同的指标,不应合并为一个总体风险评估。
实践标准:比较结果时,务必保留指标的原始类别和配置背景。
为什么单步评估还不够
作者指出,标准评估仍然是单步评估,无法发现由一系列操作引发的漏洞。
这些风险与智能体的工作方式有关:
- 读取不可信的输入数据;
- 使用实际权限调用工具;
- 自主行动。
这些因素结合起来会扩大攻击面。评估标准是:不仅要检查单次回答,还要检查智能体在多个步骤中的行为。
何时选择黑盒方法
如果无法访问智能体内部,该方法适用于风险评估。只需提供系统的基本描述。
当评估需要将可观察行为与风险类别关联起来时,这种方法也很有用。要发现多步漏洞,仅靠单步评估并不够。
实践标准:如果任务要求在没有特权访问权限的情况下检查行为,并考虑多个步骤中产生的风险,就选择这种方法。