完全微调不再是合理选项
脑电图基础模型的训练无需标注——通过对比任务或重建被掩码的信号片段。其逻辑是:模型先学习节律、伪影和状态转换的普遍规律,再针对癫痫样放电检测等狭窄任务进行微调。理论上,这能产生可跨诊所和跨设备迁移的表示。实践中则更复杂:临床记录档案彼此差异过大,迁移质量明显下降。
第二个问题是经济性。经典微调会更新所有权重,因此每项新任务都需要大量算力。在没有 GPU 集群的科室里,这种方案根本无法运行。由此引出 arXiv:2608.24727 这篇工作所围绕的问题:能否只调整一小部分参数,同时不损失质量?
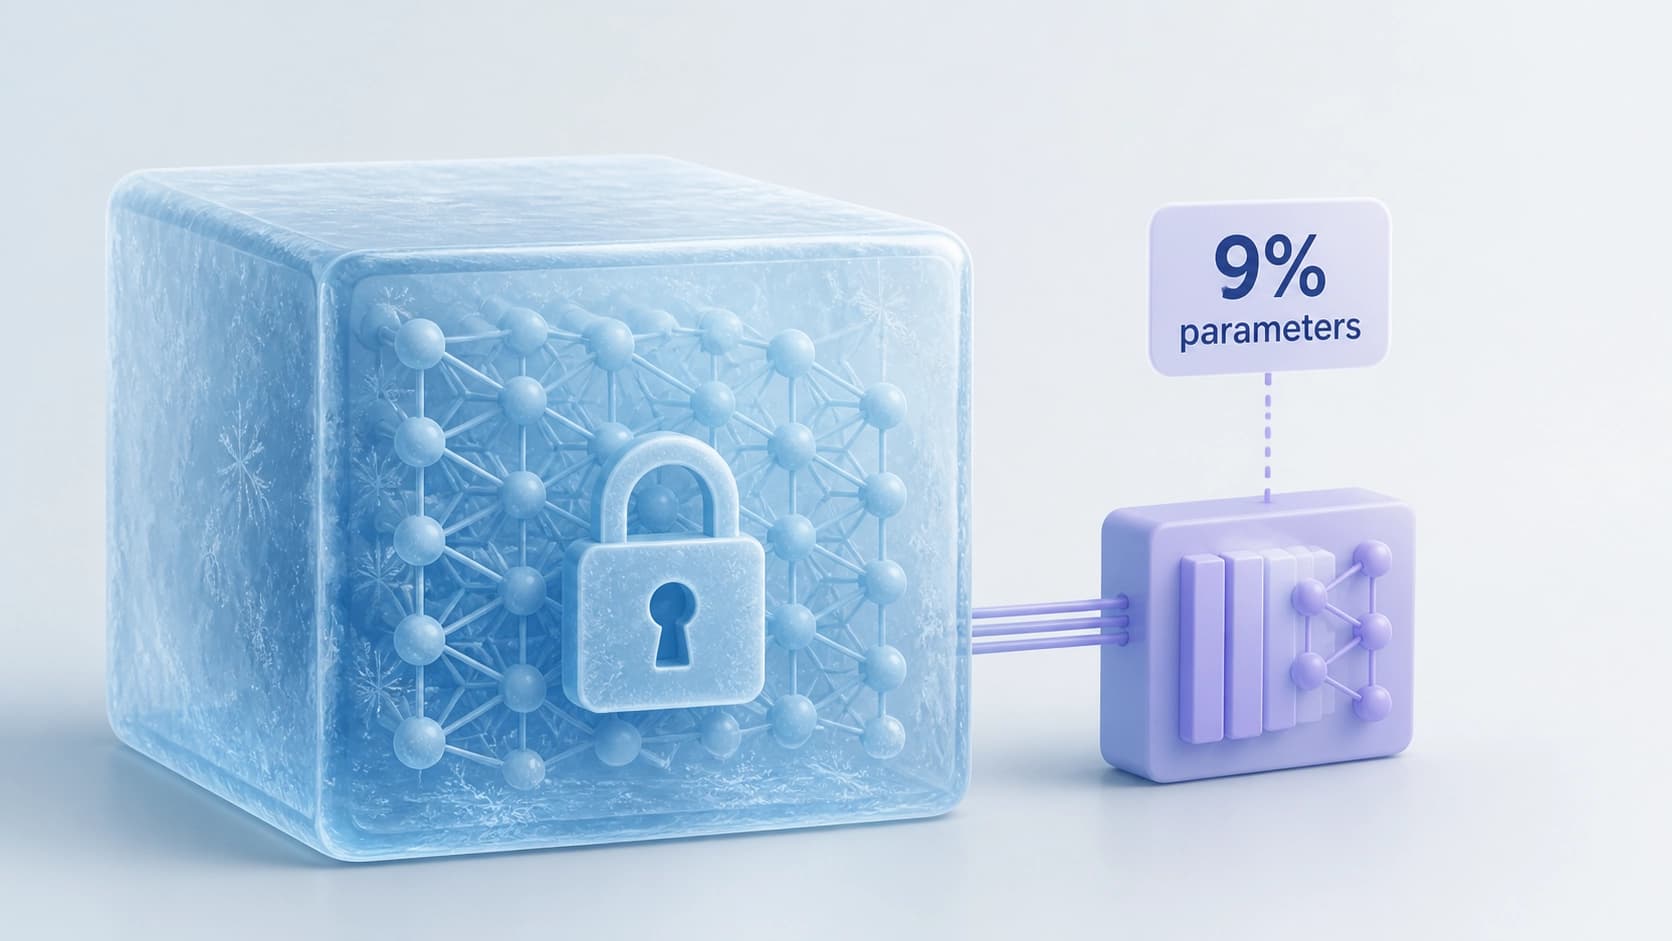
百分之九:究竟调整了什么
这篇预印本的作者是 Meghal Dani 和 Stefanie Liebe。他们验证了一种模式:约 9% 的权重保持可训练,模型其余部分被冻结。适配以自监督方式进行:模型不只是拟合类别标签,而是将内部表示对齐到目标任务。文本于 2026 年 8 月 25 日发布(v1 版本),归入 cs.LG 和 cs.AI 分类,DOI 为 10.48550/arXiv.2608.24727。代码已开放以供复现。
其意义不在于得到了一个“精简版”模型。这是一种不同的运行模式:沉重的预训练编码器保持不变,而针对每项新任务只调整一个紧凑的附加结构。对临床而言,这种分离至关重要——昂贵的预训练只做一次,廉价的适配可以重复任意多次。
两个预训练目标不同的模型
为了让结果不依赖于某一个恰好成功的架构,实验中使用了两个 SOTA 模型:采用对比目标的 BIOT,以及训练重建被掩码片段的 CBraMod。如果这一方法在两种情况下都奏效,那就不是巧合,而是该方法本身的特性。
三个临床数据集与两种验证模式
评估在 TUAB(异常检测)、TUEV(事件分类)和 CHB-MIT(癫痫发作检测)上进行。测量做两次——分布内和分布外,也就是说不仅在“自己的”数据上检验,也在偏移分布上检验。
结果显示了什么
- 相比线性探测,自监督适配带来稳定增益——在 AUCPR 上最高可达 20 倍。这不是“略好一点”,而是数量级上的差异,而且在稀有类比总体 accuracy 更重要时尤为明显。
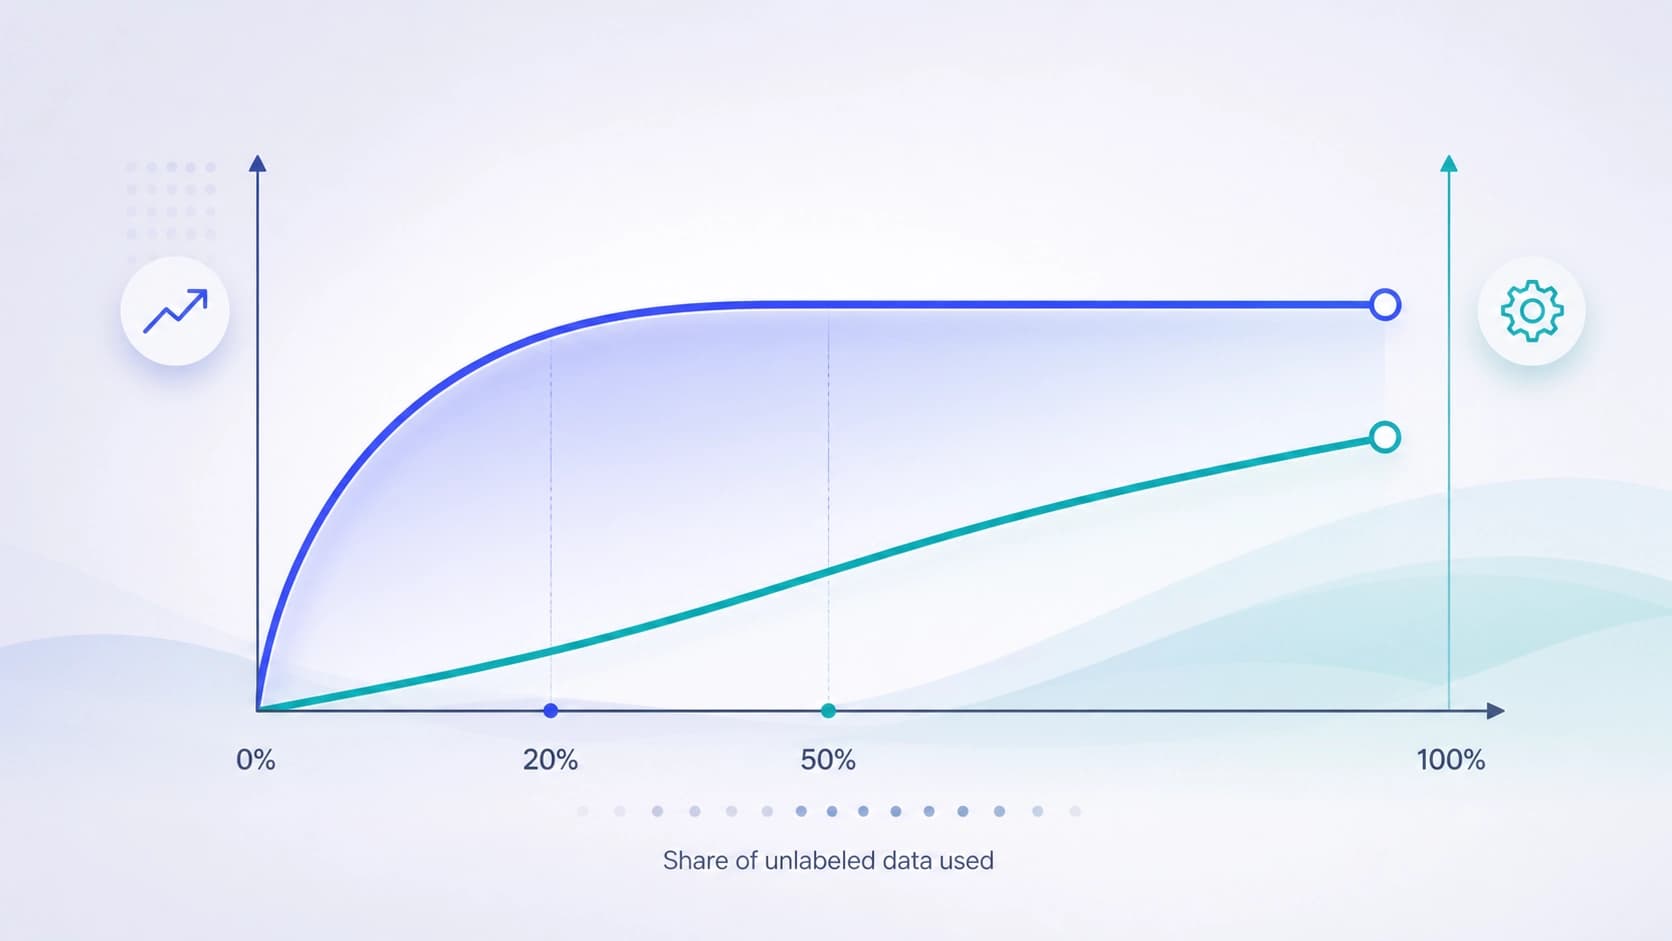
- 在固定算力预算下,峰值仅需 20–50% 的可用无标注记录即可达到。其余语料已不再带来增益。
- 如果信号窗口总数固定,结果不取决于其中包含多少患者。也就是说,起作用的不是“人的独特性”,而是片段的时间多样性:记录内不同的状态、模式和伪影。
最后一点颠覆了惯常的数据采集逻辑。直觉上,不同患者越多越可靠。而这里的结果表明,在窗口数量有硬性限制时,可以从更少的人身上采集数据——只需关注其信号在时间上的多样性。
为什么这改变了临床的格局
迄今为止,EEG 基础模型的落地障碍不在于表示质量,而在于预算:要从模型中获得价值,必须负担得起完全微调和大型标注语料。这项工作表明,这一门槛可以从两方面同时降低——算力和数据。9% 的权重和一半的无标注档案,取代 100% 和全部数据量。
对医院而言,这意味着更现实的方案:模型集中预训练,而在本地针对具体任务在普通设备上进行调整。更少依赖谁收集了更多记录,也更少在存储和处理多余信号时长上的开销。
需要牢记的几点
不应把结果解读为“9% 总是足够”。这是来自特定实验的特定模式,而非适用于任何架构和任何数据集的通用配方。作者本人也指出:EEG 模型的泛化仍然有限,尤其是在异构临床语料上。参数高效适配并未消除迁移问题——它只是降低了进入迁移的门槛。
实践结论比想象中简单:讨论正从“到底要不要涉足 EEG 基础模型”转向“如何在科室里部署它们”。而这已经是工程和流程组织的问题,而不只是机器学习的问题。