
DiSCO:无需访问模型内部即可保护文本到图像免受有害内容侵害
新的DiSCO方法作为外部模块运行:它能够筛选安全提示词,将未受保护模型遭受red-team攻击的成功率降低37.7%,对已受保护系统则降低25.13%。同时,语义准确性得以保持,图像连贯性甚至有所提升。
隐藏在不安全提示词中的威胁
现代根据文本描述生成图像的神经网络能够创造出令人印象深刻的图片,但有时也会“输出”不良内容。通常,这类系统的防护依赖于对其内部结构的干预:重新训练文本编码器、调整权重或在推理阶段进行特殊处理。这种方法在你能访问模型本身时是有效的,但对于以“黑箱”方式运行的封闭专有服务则完全不适用。
作为替代方案,人们尝试使用大型语言模型来自动将请求改写为安全的形式。但这里也有一个弱点:提示词在语言学上完全无害,但由于模型在训练期间分配数据的方式,生成结果仍会进入有害区域。作者将这种模式称为“良性对抗”——即文本形式上安全,而结果却并非如此。
DiSCO 提供了什么
由一组研究人员开发的 DiSCO(分布引导的对比提示优化)方法提出了一条完全不同的路径:在提示词层面保护生成过程,而无需窥探模型内部。这是一个严格的黑箱解决方案,作为外部即插即用模块运行。它不需要微调、重新训练,也不需要关于目标系统参数或架构的任何信息。
其思路是自动修改后缀——即提示词的尾部部分——从而将生成引导到安全的方向。通过束搜索来寻找合适的后缀,并使用对比评分来评估候选质量。为此,该模块事先利用目标模型本身生成两组图像池:安全和不安全的。通过将生成结果与参考池进行比较,DiSCO 能够判断应朝哪个方向“施压”后缀。
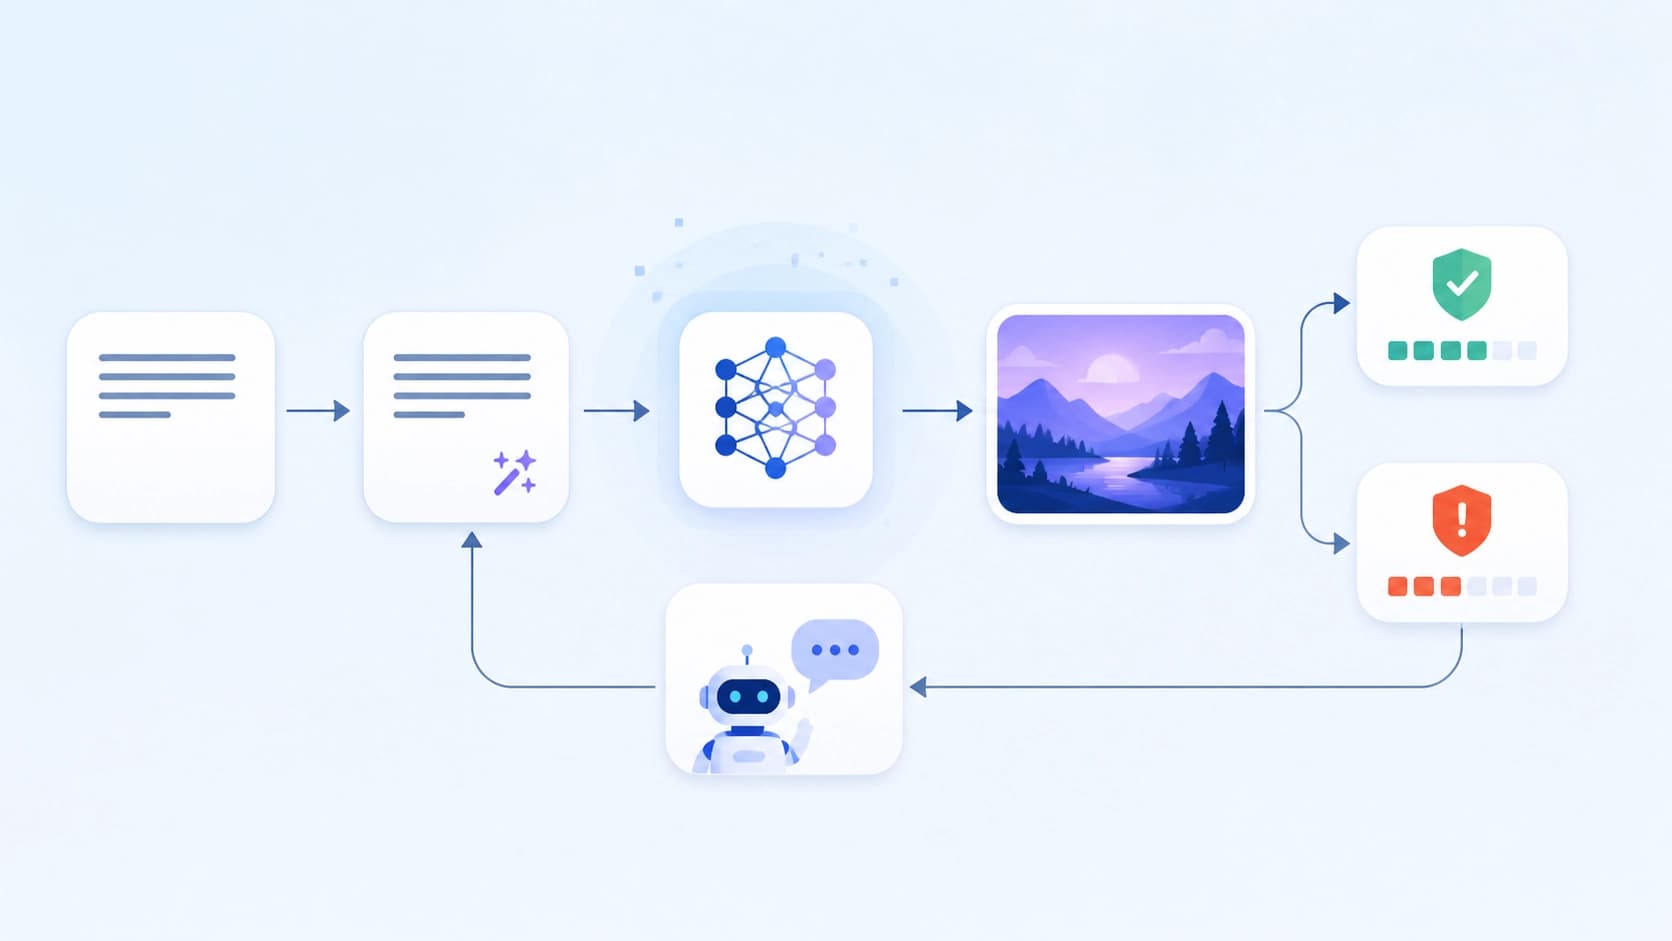
这个过程是迭代的:每一步之后,模块都会评估生成的图像,如果其中仍包含不良元素,则重新调整后缀。这一过程持续进行,直到生成结果符合安全池的标准。在此过程中,没有任何一步需要揭示模型内部信息——所有交互仅通过发送提示词和接收图片来完成。
效果如何
研究人员在 I2P(不当图像提示)基准上测试了 DiSCO,涉及多种红队攻击场景。结果显示,对于没有任何防护的模型,成功攻击率降低了 37.7%;对于已通过其他方法防护的模型,降低了 25.13%。这意味着 DiSCO 不仅填补了无防护情况下的漏洞,还能增强已有的防御屏障。
值得注意的是,语义准确性并未因此受损:生成的图像仍与原始提示词相关,甚至连贯性还有所提升。换言之,该模块不会损害生成质量,而只是将其引离潜在危险的解读方向。
由于 DiSCO 与架构无关,它可以接入任何文本到图像系统,而无需修改模型本身。这对于访问受限的封闭商业 API,以及希望在公共应用中使用前提升第三方服务安全性的用户来说尤为宝贵。
尽管结果令人印象深刻,但应记住,该方法并非“银弹”,而只是防护层之一。完全消除风险恐怕难以实现,但从“内部”安全转向“外部”且自适应的安全,是朝着生成系统抵御恶意请求的稳健性迈出的重要一步。
常问问题
相关材料
所有材料
RL 模拟器故障诊断中的规范多项式不变量:它们究竟在何处发挥作用
这项研究检验了将物理定律纳入可训练动力学模型是否合理:从轨迹中提取并通过 Gröbner 基化为规范形式的不变量,虽能小幅提升预测效果,却在诊断方面表现出色——它们能够定位被违反的约束,并找出具体的错误参数。
10 十一月 2026
AURA-Eval:如何验证 LLM 智能体识别了风险并调整了下一步行动
该框架评估 LLM 智能体在关键节点面对风险时的反应,而非最终判断:工具调用轨迹会被中断,随后模型必须继续推理并采取行动,LLM 评审团则分析其风险识别、行动性质与安全性。在从 157 条 R-Judge 轨迹中整理出的 1249 项任务上,对 20 个模型的评估显示,缺少安全路径时,不安全行为会增多;在执行前撤除监督,会使 52.3% 原本安全的案例转为不安全。
10 十一月 2026
陈-西蒙斯储层记忆:连通性的自主动力学与密度输运
本文探讨了储层如何同时在密度分布和几何自由度中保留输入信号的历史。对四种机制的比较表明,电流会形成一个独立的连通分量,改变密度的后续响应;而纳入所有测得的特征,则能在脉冲顺序解码方面带来小幅提升。
10 十一月 2026