

LlamaIndex
Фреймворк для создания LLM-приложений, подключающий внешние источники данных.
Место в рейтингах
Обзор
Описание нейросети LlamaIndex
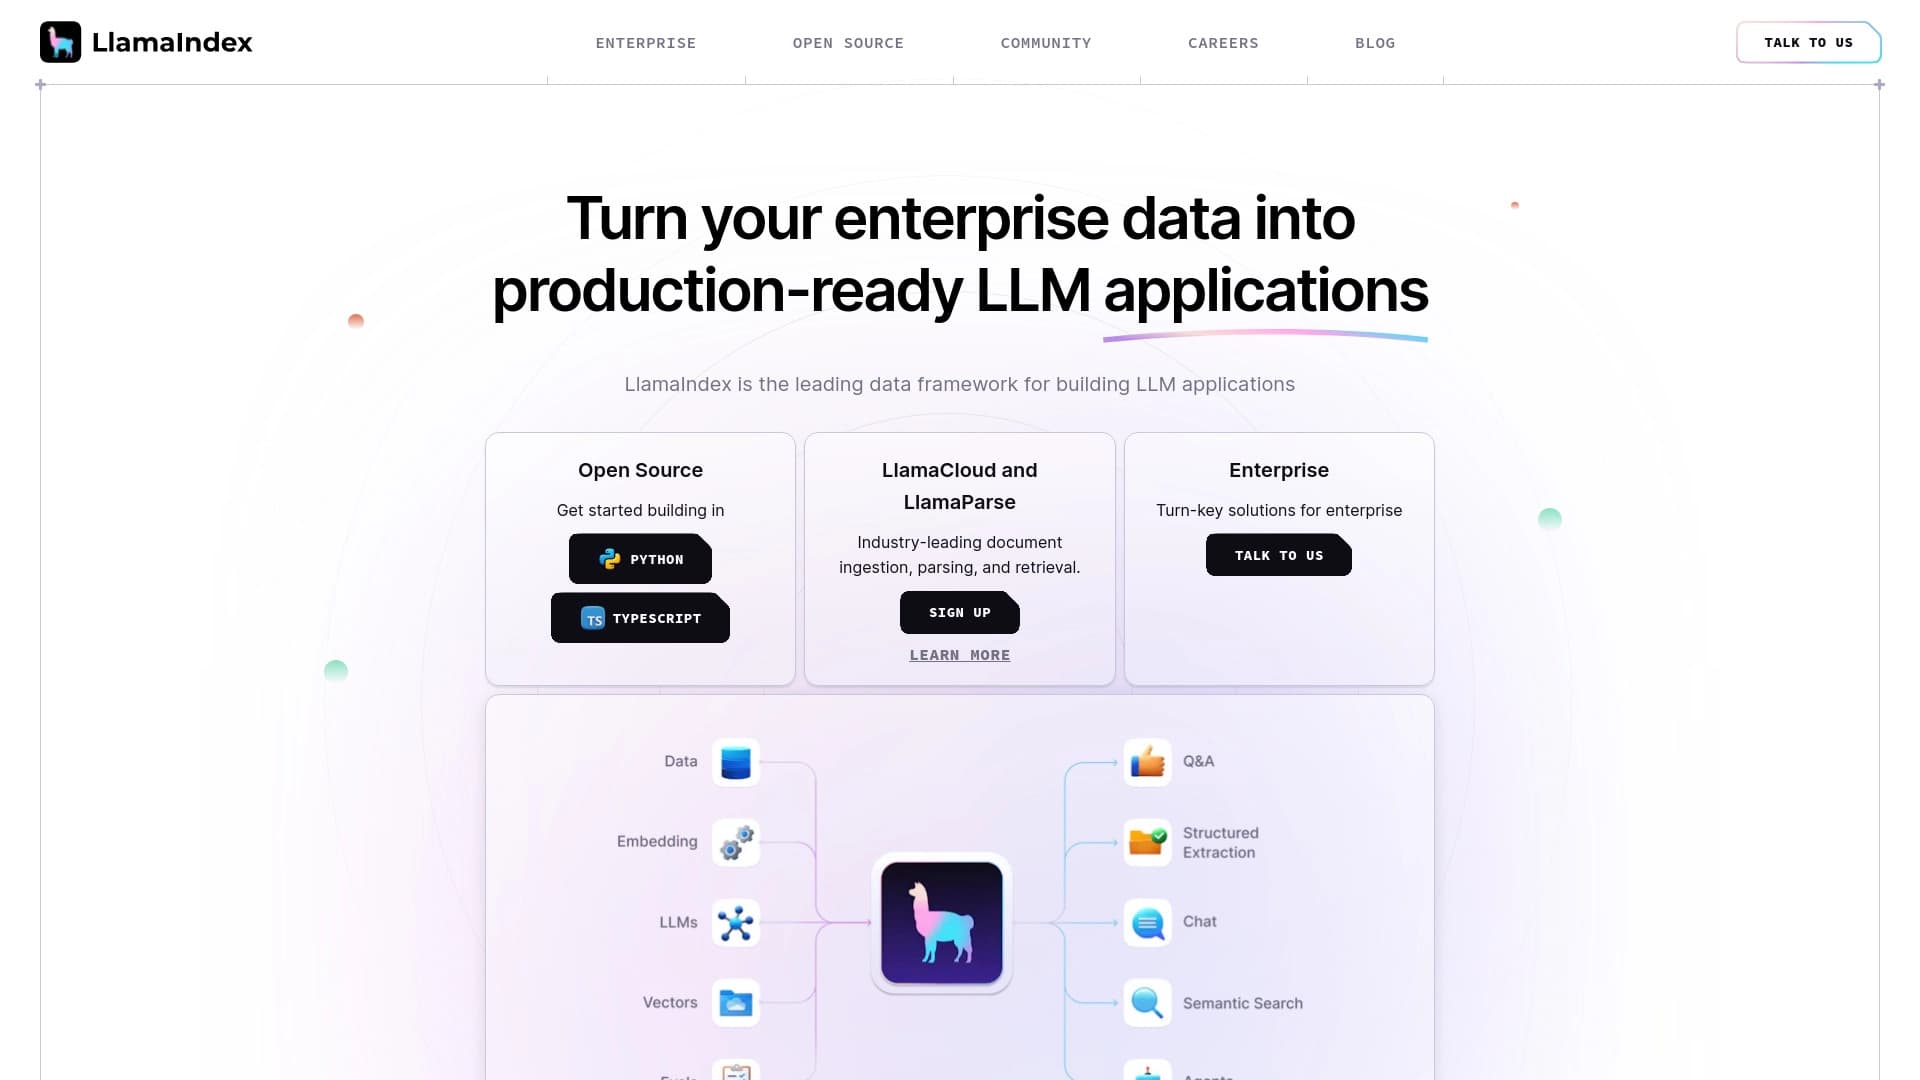
LlamaIndex — это открытый фреймворк, предназначенный для создания приложений на основе больших языковых моделей (LLM) с подключением внешних источников данных. Основная задача инструмента — устранить разрыв между статичными знаниями модели и актуальными данными, которыми располагает разработчик или компания.
Решение позволяет подключать к LLM собственные документы, базы данных и API. Вместо того чтобы переучивать модель или полагаться только на её базовые знания, LlamaIndex выстраивает мост между нейросетью и вашими данными. Это делает возможным построение систем, где модель отвечает на вопросы, опираясь на конкретную информацию из ваших файлов или сервисов.
Суть технологии
Фреймворк автоматизирует процессы индексации и поиска информации. Когда вы загружаете документы, LlamaIndex структурирует их в удобный для поиска формат, создавая индексы. При запросе пользователя система находит наиболее релевантные фрагменты данных и передаёт их в языковую модель вместе с вопросом. Такой подход позволяет получать точные ответы со ссылками на первоисточники.
Характеристики LlamaIndex
| Характеристика | Значение |
|---|---|
| Тип продукта | Open-source фреймворк |
| Назначение | Создание LLM-приложений с внешними данными |
| Поддерживаемые источники | Документы, базы данных, API |
| Основная функциональность | Индексация, поиск, передача данных в LLM |
| Ключевые сценарии | Системы вопрос-ответ, RAG-пайплайны |
| Модель распространения | Free (бесплатная) |
| Применимость | Прототипы и продакшн-системы |
Для кого подходит нейросеть LlamaIndex?
Разработчики и инженеры
Инструмент ориентирован в первую очередь на разработчиков, которые создают приложения с использованием LLM. Если вы хотите добавить в свой продукт возможность работать с базой знаний компании, внутренними документами или внешними API, LlamaIndex предоставляет готовые механизмы для этой задачи. Фреймворк подходит как для быстрых экспериментов и прототипов, так и для построения полноценных продакшн-решений.
Команды, работающие с данными
Data-инженеры и аналитики могут использовать LlamaIndex для создания систем, которые извлекают ответы из корпоративных хранилищ данных. Вместо сложных SQL-запросов и написания парсеров, можно организовать естественно-языковый интерфейс для работы с данными. Это упрощает взаимодействие с информацией для нетехнических сотрудников компании.
Как использовать нейросеть LlamaIndex?
Подключение источников данных
Первый шаг — подключить данные, с которыми будет работать языковая модель. LlamaIndex поддерживает различные форматы: текстовые документы, базы данных, а также внешние API. Фреймворк берёт на себя задачу обработки и подготовки этих данных для дальнейшего использования.
Создание индексов
После подключения данных необходимо создать индексы. Это структурированные представления информации, которые позволяют быстро находить релевантные фрагменты. LlamaIndex упрощает этот процесс, автоматически разбивая документы на логические части и формируя удобную структуру для поиска.
Построение пайплайна
Далее строится пайплайн, который связывает ваши данные с LLM. Когда пользователь задаёт вопрос, система находит нужные фрагменты данных, добавляет их в запрос к модели и получает ответ, основанный на вашей информации. Всё это настраивается в коде приложения с использованием инструментов фреймворка.
Основные функции LlamaIndex
Индексация данных
Фреймворк предоставляет механизмы для загрузки и структурирования информации. Вы можете работать с различными типами источников и форматов, приводя их к единому виду, удобному для последующего поиска и анализа.
Поиск и извлечение информации
Ключевая функция LlamaIndex — поиск релевантных фрагментов данных по запросу пользователя. Система определяет, какая именно часть ваших документов содержит ответ или полезный контекст, и извлекает её для передачи модели.
Интеграция с LLM
Фреймворк выступает посредником между данными и языковой моделью. Он правильно форматирует запросы, добавляя в них найденный контекст, и передаёт результат обратно в приложение. Это позволяет строить сложные системы вопрос-ответ и RAG-пайплайны без необходимости писать всю эту логику вручную.
Преимущества LlamaIndex
Главное преимущество — открытый исходный код и бесплатная модель распространения. Это позволяет использовать фреймворк в коммерческих и личных проектах без лицензионных отчислений. Возможность работать с разными источниками данных делает инструмент гибким решением для различных задач. Фреймворк одинаково хорошо подходит как для быстрой проверки идей на этапе прототипирования, так и для создания стабильных систем, работающих в продакшене. Благодаря автоматизации процессов индексации и поиска, разработчики экономят значительное время и усилия по сравнению с написанием аналогичного функционала с нуля.
Недостатки LlamaIndex
Поскольку инструкция предполагает использование только фактических данных из источников, а они крайне ограничены, следует отметить, что в предоставленном описании не указаны явные недостатки инструмента. Как и любой фреймворк, он имеет определённые ограничения, связанные с необходимостью изучения API и понимания принципов работы систем RAG. Однако детальная информация об ограничениях отсутствует в доступных исходных данных. Потенциальным пользователям стоит учитывать, что для эффективного использования потребуется владение навыками программирования и понимание архитектуры LLM-приложений.
Какие задачи решает LlamaIndex
Системы вопрос-ответ
Основной сценарий использования — создание систем, которые отвечают на вопросы на основе ваших данных. Вместо того чтобы полагаться только на знания модели, приложение обращается к подключённым документам и предоставляет точную информацию из них.
RAG-пайплайны
LlamaIndex упрощает построение RAG-пайплайнов (Retrieval-Augmented Generation). Это архитектура, при которой модель сначала находит релевантные фрагменты в базе знаний, а затем формирует на их основе ответ. Такой подход повышает точность и актуальность ответов, а также позволяет добавлять ссылки на первоисточники.
Интеграция внешних данных в LLM-приложения
Фреймворк решает задачу подключения любых внешних источников — от локальных документов до облачных баз данных и API. Это позволяет расширять возможности языковых моделей и адаптировать их под конкретные бизнес-задачи.
Цены LlamaIndex
Согласно исходным данным, модель распространения LlamaIndex — free. Это означает, что фреймворк доступен бесплатно. Отсутствует информация о платных тарифах или подписочных моделях. Пользователи могут скачать и использовать инструмент без оплаты. Однако стоит учитывать, что при использовании облачных LLM-провайдеров (например, OpenAI API) могут взиматься отдельные платежи за вызовы моделей — это не относится к самому фреймворку.
Условия использования LlamaIndex
LlamaIndex является open-source решением. Это означает, что исходный код доступен для изучения, использования и модификации. Точные условия лицензирования (тип лицензии, ограничения) не указаны в предоставленных источниках. Для получения детальной информации о правах и обязанностях пользователя рекомендуется обратиться к официальной документации и репозиторию проекта. Учитывая открытый статус, вероятно, предусмотрено свободное использование в личных и коммерческих проектах, но конкретные формулировки необходимо уточнять в официальных источниках.
Доступность LlamaIndex
Любой разработчик может получить доступ к фреймворку, поскольку он распространяется бесплатно как open-source проект. Это делает инструмент доступным для широкого круга пользователей: от независимых разработчиков и стартапов до крупных корпораций. Отсутствие платного барьера позволяет начать работу с фреймворком без предварительных финансовых вложений. Точные платформы и способы распространения (например, через пакетные менеджеры или прямой скачивание из репозитория) в исходных данных не уточняются, но для open-source проектов обычно предусмотрено несколько удобных способов установки.
Чем отличается LlamaIndex от аналогов
LlamaIndex выделяется на фоне других инструментов своей специализацией на работе с внешними данными. В отличие от простых обёрток над LLM API, фреймворк предоставляет полноценный набор инструментов именно для интеграции собственных источников информации. Это включает развитый механизм индексации и релевантного поиска.
Ключевое отличие — упор на построение производственных RAG-пайплайнов. Многие аналогичные решения либо слишком просты для серьёзных проектов, либо требуют значительной ручной настройки. LlamaIndex балансирует между простотой использования и гибкостью, позволяя как быстро создать прототип, так и выстроить сложную корпоративную систему. Также важно, что фреймворк не привязан к конкретному провайдеру LLM — вы можете использовать любую языковую модель вместе с ним, что обеспечивает гибкость при выборе технологического стека.
Заключение
LlamaIndex — это функциональный open-source фреймворк, который решает важную задачу интеграции внешних данных в приложения на основе больших языковых моделей. Он предоставляет разработчикам готовые инструменты для индексации, поиска и передачи данных в LLM, что позволяет строить системы вопрос-ответ и RAG-пайплайны. Распространение по модели free делает его доступным для широкого круга пользователей — от инженеров, создающих прототипы, до команд, разрабатывающих полноценные продакшн-решения. Если ваша задача — заставить языковую модель работать с вашими собственными данными, LlamaIndex — достойный инструмент для её решения.
Часто задаваемые вопросы
Смотрите также

TensorStax — это AI-агент для управления жизненным циклом моделей машинного обучения, упрощающий их развертывание и мониторинг.

Платформа для управления проектами с функциями постановки задач, отслеживания времени и контроля загрузки сотрудников.
Сервис для создания приложений, нейросетей и AI-клонов, а также нейросеть для генерации и обработки текстов.

Библиотека для TypeScript, позволяющая использовать GPT-4 в качестве среды выполнения для функций, описанных комментариями.

Платформа для создания мультиагентных AI-систем и чат-ботов для автоматизации клиентской поддержки и поиска лидов.
Платформа без кода для маркировки и отслеживания данных, упрощающая создание наборов для компьютерного зрения.
Cabina AI — это единая платформа для работы с разными генеративными нейросетями, позволяющая создавать тексты, изображения и видео.

Инструмент с открытым исходным кодом для быстрого преобразования одного изображения в 3D-модель.