
As pessoas são compreensíveis, LLMs não: especialistas não conseguiram explicar a lógica dos modelos
Os pesquisadores compararam os fatores ocultos por trás das respostas de pessoas e de seis modelos de linguagem em tarefas de raciocínio quantitativo e química. Os fatores extraídos das respostas humanas foram interpretados com sucesso pelos especialistas, mas a maioria dos construtos dos modelos revelou-se opaca para eles.
Pessoas são compreensíveis, LLMs não: especialistas não conseguiram explicar a lógica dos modelos
Quando olhamos para os resultados dos testes, parece natural supor que a inteligência artificial resolve tarefas "como um humano": usando os mesmos conceitos, regras e raciocínios. No entanto, uma nova pesquisa coloca essa suposição em questão. Os cientistas descobriram que as estruturas ocultas que determinam as respostas das LLMs, na maioria dos casos, não são passíveis de interpretação humana — nem mesmo por especialistas da área.
O que exatamente foi testado
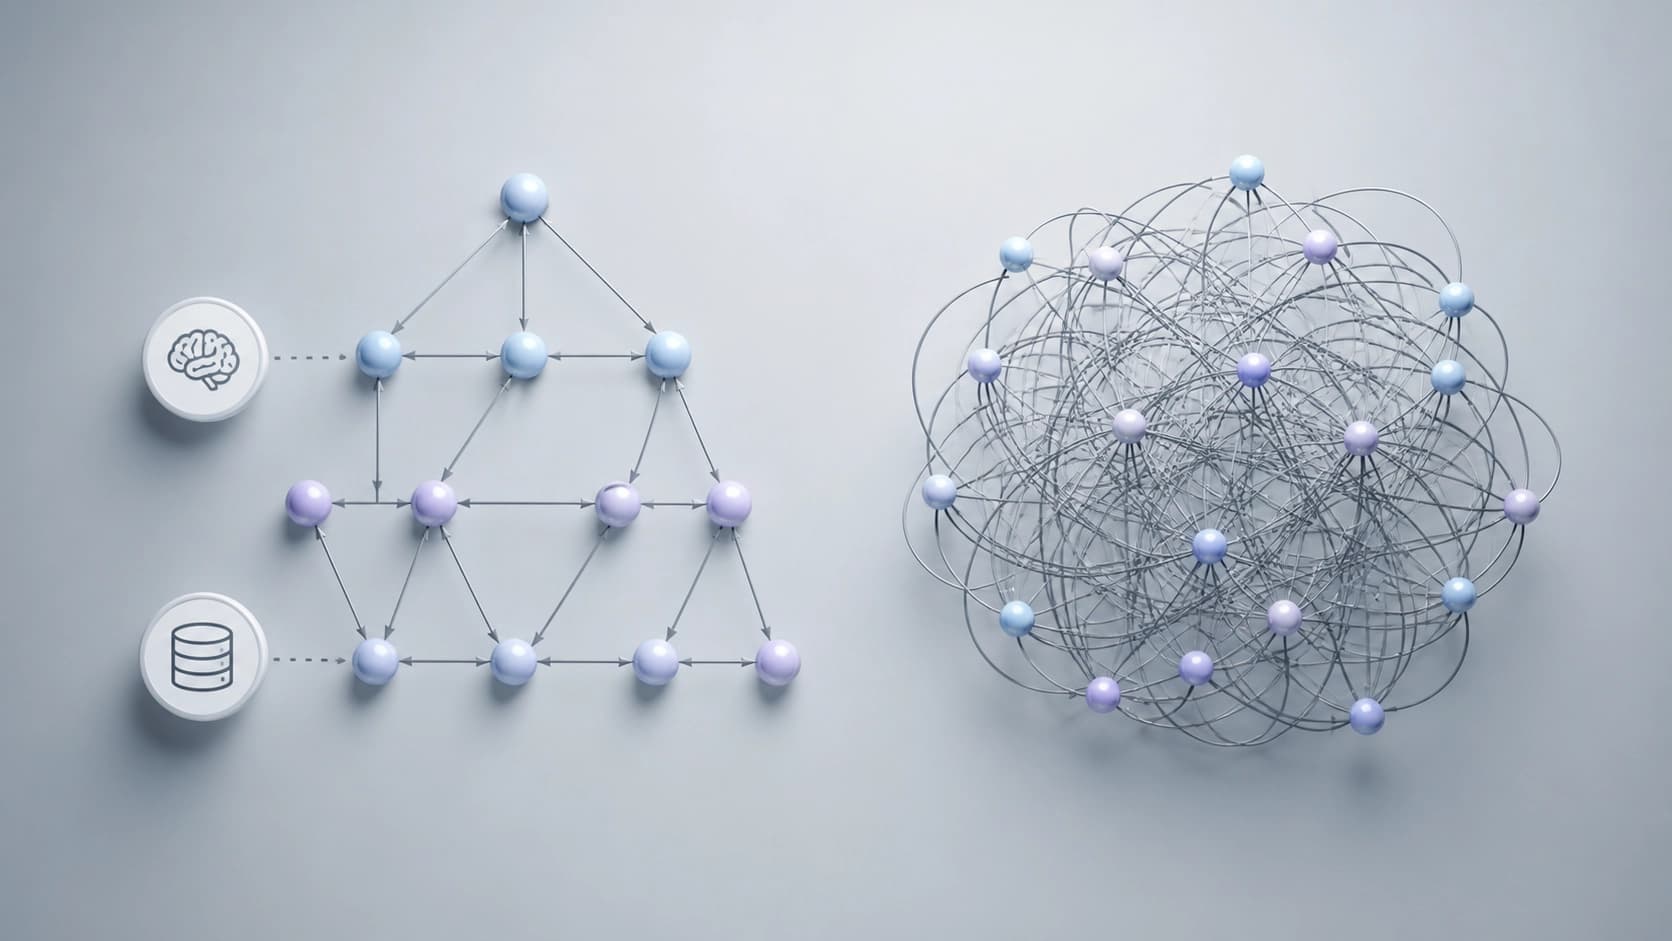
Os autores do trabalho (arXiv:2608.17810) — Alona Strugatski, Likol Zeinfeld, Jason Cooper e seus colegas — pegaram respostas de humanos e de seis LLMs diferentes em tarefas de raciocínio quantitativo e química. Usando análise fatorial exploratória, eles identificaram para cada grupo fatores latentes ocultos que supostamente estão por trás do sucesso na execução dessas tarefas.
Em seguida, especialistas no assunto estudaram as estruturas obtidas às cegas e tentaram atribuir aos fatores um significado pedagógico: por exemplo, "habilidade de trabalhar com fórmulas" ou "compreensão de estequiometria". O formato cego excluía pistas — os especialistas não sabiam se os gráficos se referiam a humanos ou a modelos.
Resultado: a lacuna na interpretabilidade
Os especialistas quase não tiveram problemas para entender os fatores obtidos com base nas respostas humanas. A maioria dos construtos recebeu uma explicação significativa, que foi facilmente traduzida em recomendações para ensino ou diagnóstico.
Com as LLMs, o cenário foi diferente:
- No raciocínio quantitativo, os especialistas não conseguiram interpretar de forma significativa nenhum dos fatores identificados para os modelos.
- Na química, a situação foi um pouco melhor, mas ainda longe do ideal: foi possível explicar apenas cerca de metade das estruturas.
O que isso significa
Os autores chegam a uma conclusão importante: quando as LLMs mostram resultados elevados em testes, isso não significa que elas raciocinam da maneira que estamos acostumados. Os modelos podem encontrar formas estatisticamente eficientes, mas completamente "estranhas" para os humanos, de resolver problemas. Seus mecanismos internos operam no nível de padrões que não carregam um significado pedagógico ou cognitivo compreensível.
Essa observação desafia a prática comum de tentar tirar conclusões sobre o nível de conhecimento ou competências com base nos resultados da IA. Se não conseguimos explicar quais construções exatamente estão por trás das respostas, corremos o risco de atribuir aos modelos habilidades inexistentes — ou, ao contrário, deixar passar limitações reais.
Para onde seguir
A pesquisa não afirma que interpretar LLMs seja impossível em princípio. Ela apenas mostra que a abordagem clássica, criada para estudar a cognição humana, não se transfere diretamente para os modelos. Talvez seja necessário desenvolver métodos de análise fundamentalmente novos — que levem em conta a natureza "não humana" das estruturas latentes.
Por enquanto, permanece em aberto a questão: se os especialistas não conseguem explicar a lógica dos modelos, podemos confiar no seu uso na educação e na avaliação de conhecimento? A resposta, provavelmente, exigirá uma revisão tanto das abordagens de verificação da IA quanto das nossas expectativas em relação à "inteligência" das máquinas.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
A confirmação de candidatos é mais cara do que a sua geração: iscas contra a busca de vulnerabilidades por LLM
O trabalho analisa a assimetria de custos na busca agentiva por defeitos: gerar variantes é barato, mas confirmá-las por meio de análise de alcançabilidade, execução e PoC exige a maior parte do orçamento; por isso, a verificação pode tornar-se um alvo de defesa por si só. O RedHerring proposto — iscas adaptadas ao repositório, com certificado selado — reduziu, com custos iguais, o número de vulnerabilidades reais encontradas em 38,7–60,4% em 33 projetos do OSS-Fuzz; mesmo após alertar o agente, a redução manteve-se em 37,2%.
9 novembro 2026
Verificação de alucinações em LLMs com uma representação SQL das fontes, sem ajuste fino
Este trabalho avalia se uma LLM consegue recorrer a uma competência simbólica básica — construir uma base de dados SQL a partir de documentos de origem — para fundamentar as respostas nas fontes sem supervisão na deteção de alucinações. No RAGTruth e no DiaHalu, este pipeline neuro-simbólico revela-se mais preciso do que a previsão direta e comparável aos métodos mais avançados, sem exigir afinação específica ao domínio.
9 novembro 2026
MathAdv: o que esconde a precisão final das provas geradas por máquina
Um conjunto de tarefas de diagnóstico em 13 áreas da matemática de nível universitário e de pós-graduação avalia sistemas de demonstração automática em Lean 4 não só pelo resultado final, mas também pelo domínio da matéria, pela qualidade do raciocínio informal e pela robustez perante reformulações das condições. A análise por componente mostra que traduzir um problema para uma forma formal continua a ser o principal obstáculo, e que o sucesso depende muito da área da matemática e da forma como o problema é formulado.
9 novembro 2026