O que exatamente a IA deve planear
O planeamento urbano é aqui uma tarefa de otimização espacial: é necessário escolher ações admissíveis num grande espaço de candidatos.
Os objetivos práticos incluem o custo e a qualidade do serviço.
O trabalho CityPlanner descreve um agente sandbox para o planeamento urbano executável.
Um cenário verificável associa o plano à avaliação: o sistema executa um avaliador e recebe feedback executável.
Nesta formulação, são importantes as ações admissíveis, o objetivo prático e a possibilidade de avaliar o resultado.
O critério de verificabilidade é a capacidade do ambiente para avaliar o plano criado.
Como funciona o ambiente de execução
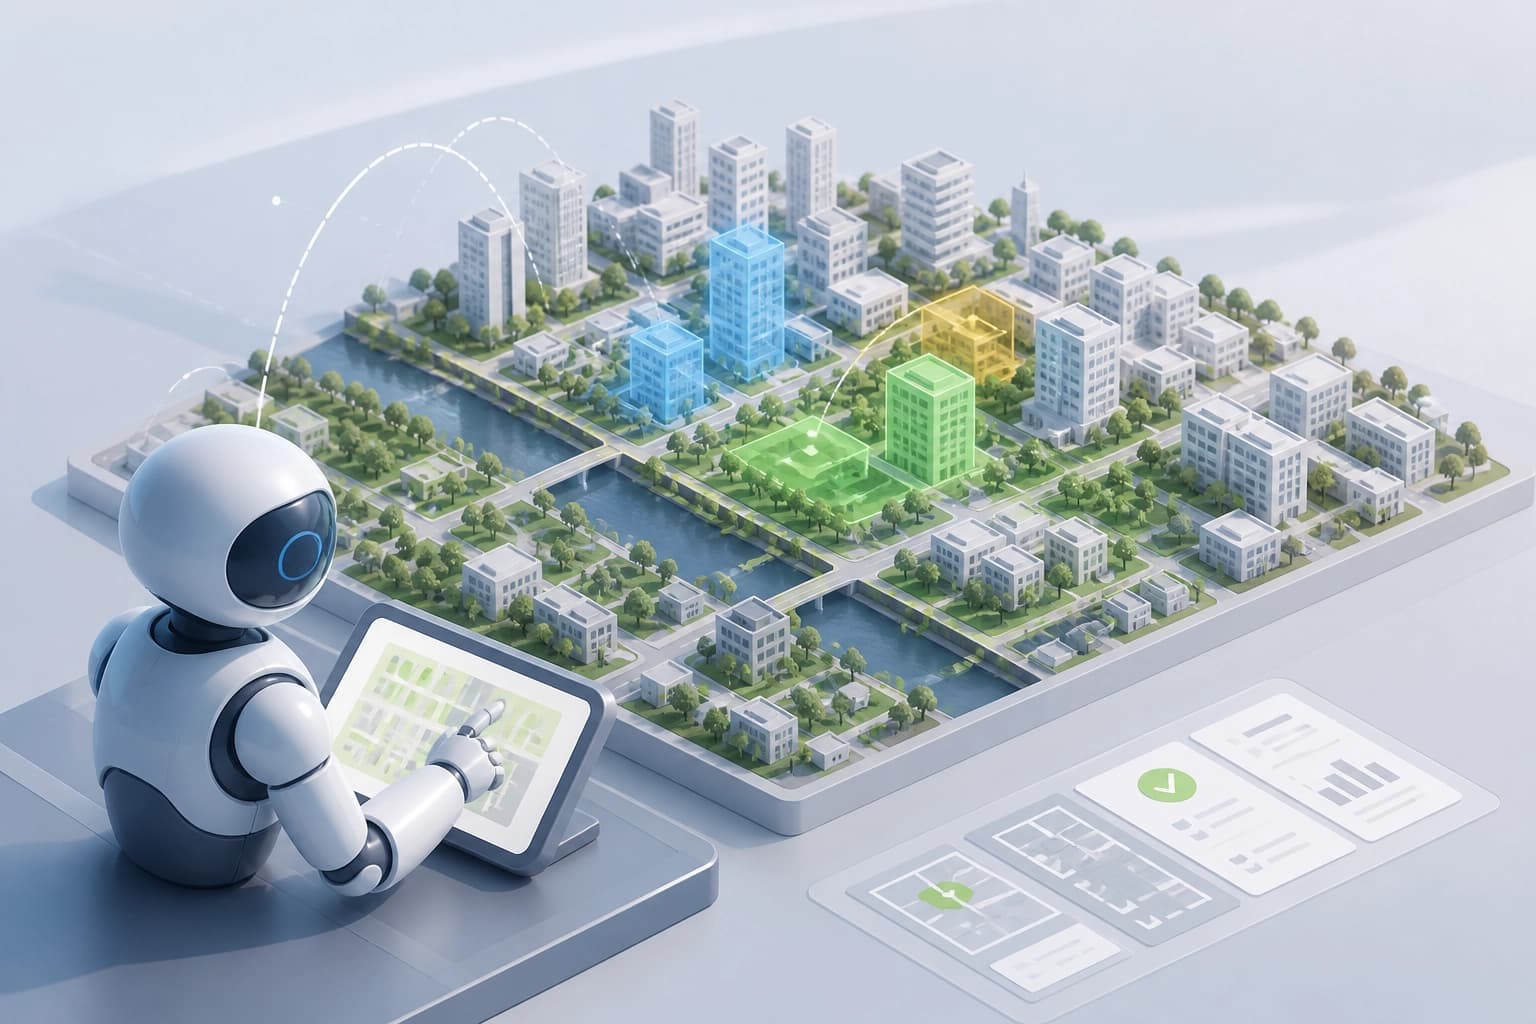
No UrbanSandbox, o agente trabalha num ambiente de ficheiros unificado.
Analisa os ficheiros da tarefa, cria um plano, executa avaliadores e revê a solução com base no feedback.
O ciclo combina o trabalho com os dados da tarefa e a verificação do plano.
Ações principais do agente:
- analisar os ficheiros da tarefa;
- criar um plano;
- executar um avaliador;
- rever a solução com base no feedback executável.
O ambiente é adequado para um cenário se o agente conseguir percorrer nele todo o ciclo — desde a análise da tarefa até à revisão do plano.
Como dividir o treino
Os autores propõem a aprendizagem por reforço de tarefas atómicas (atomic-task reinforcement learning): as trajetórias longas no sandbox são divididas em duas tarefas.
Esta divisão simplifica o treino, separando a criação inicial do plano do seu aperfeiçoamento.
Cada tarefa corresponde a uma etapa distinta do trabalho com o plano.
- BuildPlan — criar o plano inicial.
- ImprovePlan — aperfeiçoar o plano com base no feedback.
Esta divisão é adequada quando o treino combina a criação do plano com a sua posterior correção com base nos resultados da avaliação.
O que mostram as experiências
Num benchmark real, o CityPlanner superou consistentemente três grupos de comparação:
| Comparação | Resultado |
|---|---|
| Métodos heurísticos | O agente obteve o melhor resultado |
| RL específico da tarefa | O agente obteve o melhor resultado |
| Modelos de base de agentes LLM de uso geral | O agente obteve o melhor resultado |
Os estudos de ablação confirmaram o contributo do UrbanSandbox, da aprendizagem por reforço de tarefas atómicas e da implementação iterativa.
Os autores informam que disponibilizaram o código e o conjunto de dados.
O trabalho foi submetido em 9 de setembro de 2026 e está a ser avaliado pela EMNLP.
A conclusão prática limita-se aos resultados deste benchmark: estes sustentam a abordagem proposta, mas não demonstram a sua superioridade para qualquer tarefa urbana.
Fonte: arXiv:2609.09578.