
SPARSEUP da Linkup: codificador esparso com 149 milhões de parâmetros
O artigo analisa a arquitetura SPARSEUP e os seus resultados: 56,4 nDCG@10 no BEIR-13, bem como mais de 97% de recall em conjunto com o índice Seismic, em cerca de 380 microssegundos por consulta. A análise aborda técnicas que preservam a esparsidade dos vetores, a comparação com outros modelos e as condições de distribuição ao abrigo da licença Apache 2.0.
O que é o modelo e como obter acesso
SPARSEUP é um codificador esparso de código aberto da Linkup Research, com 149 milhões de parâmetros. A sua arquitetura base é a ModernBERT e a licença é Apache 2.0.
Os pesos estão disponíveis na Hugging Face. O modelo pode ser carregado através de Transformers ou Sentence Transformers, indicando trust_remote_code=True.
A Linkup considera-o o melhor codificador esparso público baseado em vocabulário que conhece entre os modelos com menos de 150 milhões de parâmetros.
Como funciona a representação esparsa
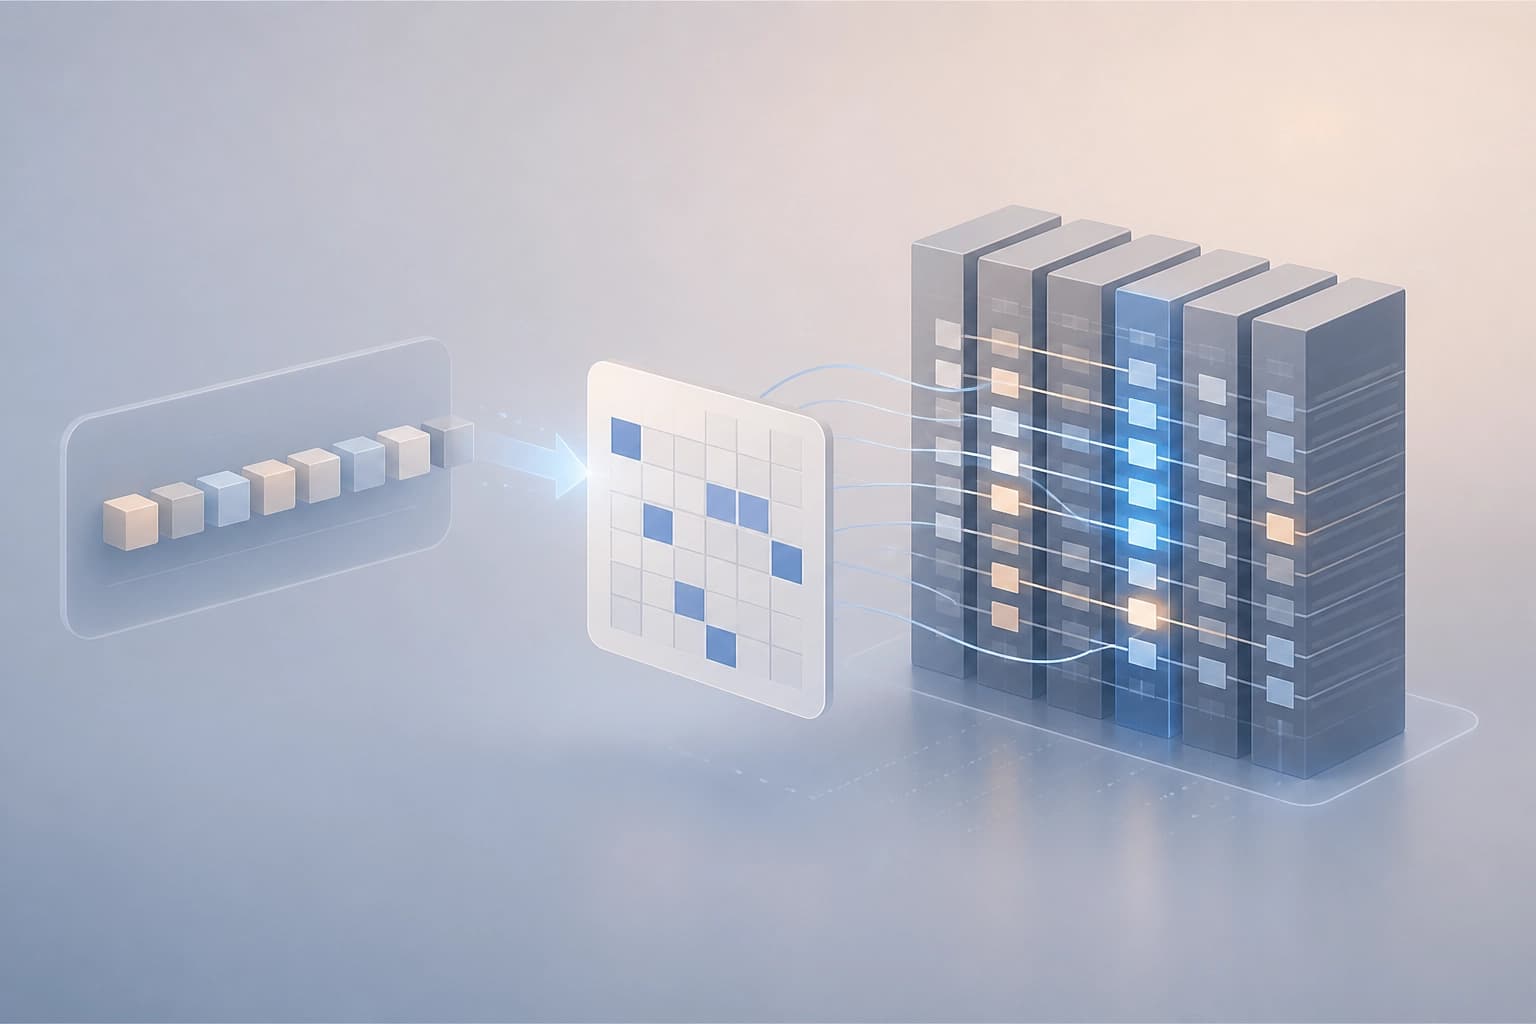
No SPARSEUP, cada dimensão do vetor corresponde a um token do vocabulário. Estes vetores são adequados para índices invertidos e associam-se melhor a palavras raras.
O modelo calcula as ativações através da fórmula log(1 + ReLU(x - 15)). Em seguida, mantém as 12 dimensões mais fortes para cada token de entrada antes do max pooling.
Isto limita o número de dimensões ativas por token, não o tamanho total do vetor. O case folding agrupa variantes de Byte-level BPE, como heat, Heat, Ġheat e ĠHeat, mantendo o peso mais elevado.
Após o agrupamento, o número de dimensões de saída diminui de cerca de 50 mil para 34 mil. As consultas e os documentos recebem os prefixos [Q] e [D]; a pontuação é calculada através do produto escalar.
O comprimento máximo durante a avaliação é de 128 tokens para uma consulta e 512 para um documento. Estes limites são importantes ao configurar o processamento dos dados de entrada.
Como o modelo foi treinado
O treino do SPARSEUP começou a partir do checkpoint LateOn-unsupervised. A equipa recuperou a cabeça MLM original da ModernBERT.
Para o fine-tuning, usou uma mistura de dados da LightOn e aplicou apenas aprendizagem contrastiva. Para cada consulta, selecionou sete hard negatives de um conjunto de 50 e também usou in-batch negatives.
A equipa não aplicou destilação de cross-encoder. O treino foi realizado numa única H100.
O que mostram as comparações
O resultado médio do SPARSEUP no BEIR-13, sem MS MARCO, é de 56,4 nDCG@10. O model card apresenta os seguintes resultados de codificadores esparsos:
| Modelo | BEIR-13, nDCG@10 |
|---|---|
| SPARSEUP | 56,4 |
| opensearch-neural-sparse-encoding-doc-v3-gte | 54,6 |
| opensearch-neural-sparse-encoding-v1 | 52,44 |
| ModernBERT-VT | 52,4 |
| splade-v3 | 51,7 |
| granite-embedding-30m-sparse | 50,6 |
O LACONIC-1B obteve 58,7, mas pertence a outro grupo de dimensão: o modelo tem 1 mil milhão de parâmetros.
Numa comparação controlada com a mesma arquitetura base e os mesmos dados, o LateOn obteve 58,9, o DenseOn 57,9 e o SPARSEUP 56,4. Os resultados do artigo indicam uma diferença de 1,52 pontos em relação ao DenseOn e de 2,5 em relação ao LateOn.
O SPARSEUP superou o DenseOn no ArguAna e no HotpotQA, e também teve um resultado melhor no Touché. Em conjuntos de dados com consultas mais semânticas, o modelo fica atrás; a diferença é particularmente notória no FiQA. O DBPedia também é apontado como um ponto fraco.
No BEIR sem contaminação, a diferença em relação ao DenseOn reduz-se para 0,17 pontos. Para o NQ e o MS MARCO sem contaminação, foram usadas apenas 21 e 46 consultas, respetivamente, pelo que a Linkup alerta para a possibilidade de os resultados serem ruidosos.
Esparsidade e critérios de seleção
No MS MARCO, o SPARSEUP usa, em média, 47 termos não nulos por consulta e 190 por documento. Para o SPLADE-v3, são indicados 25 termos por consulta e 170 por documento.
Com o índice invertido Seismic, o modelo alcança mais de 97% de recall em relação à pesquisa exata, em cerca de 380 microssegundos por consulta num único fluxo.
Vale a pena considerar o SPARSEUP se a representação esparsa e a pesquisa através de um índice invertido forem importantes. Na avaliação, também convém ter em conta os resultados nos conjuntos de dados relevantes: o modelo tem um desempenho inferior em consultas semânticas, no FiQA e no DBPedia.
A Linkup considera que aumentar o tamanho do vetor poderia acrescentar 1–2 pontos no BEIR. A equipa decidiu manter a esparsidade do modelo.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Avaliação de agentes de programação no desenvolvimento XR interativo: resultados do GenXR-Bench
Foi publicado o GenXR-Bench, um conjunto de 112 tarefas especializadas para avaliar de ponta a ponta agentes de programação no desenvolvimento interativo de XR: desde o aprimoramento de funcionalidades e a correção de defeitos até a criação de aplicações com verificação do comportamento em dispositivos de consumo. Entre os dez modelos testados, o melhor resultado foi de 50,9% no Pass@1; entre as falhas recorrentes estão o processamento de eventos assíncronos de sensores, a ancoragem de objetos no espaço real e a compreensão das interações em contextos físicos.
5 novembro 2026
Da recompensa escalar à fronteira de Pareto: síntese de RTL com aprendizagem por reforço multiobjetivo
É proposto um método para treinar um modelo de linguagem a gerar não apenas um esquema, mas um conjunto de candidatos RTL com diferentes compromissos entre área, latência e consumo de energia; a recompensa é calculada com base na contribuição de cada variante para o hipervolume da fronteira de Pareto. No RTLLM v2, o hipervolume relativo aumentou 13,3 p.p. em relação à versão de base sem otimização de PPA e 14,4 p.p. em relação ao treinamento por reforço com um único objetivo.
5 novembro 2026
Os LLM médicos sabem que as recomendações foram revistas, mas muitas vezes respondem de acordo com as regras anteriores
Um estudo da ChronoEvo sobre 1709 alterações às recomendações clínicas mostra que, no modelo principal, 90,8% das respostas assinalavam a novidade, mas apenas 58,5% a aplicavam na íntegra, e a diferença de 32,3 pontos percentuais persistia em 14 modelos. Mesmo aumentar a visibilidade das atualizações não trouxe um aumento significativo da incorporação integral das novas regras nas recomendações clínicas.
4 novembro 2026