Simuladores não conseguem acompanhar os sistemas reais
Implantar um cluster de verdade para atender modelos de linguagem de grande porte é caro e, muitas vezes, simplesmente impossível: não há hardware, não há orçamento, não há tempo para esperar. Por isso, a modelagem de sistemas há muito tempo se tornou uma ferramenta de trabalho para pesquisadores: primeiro você simula, depois vai para o hardware.
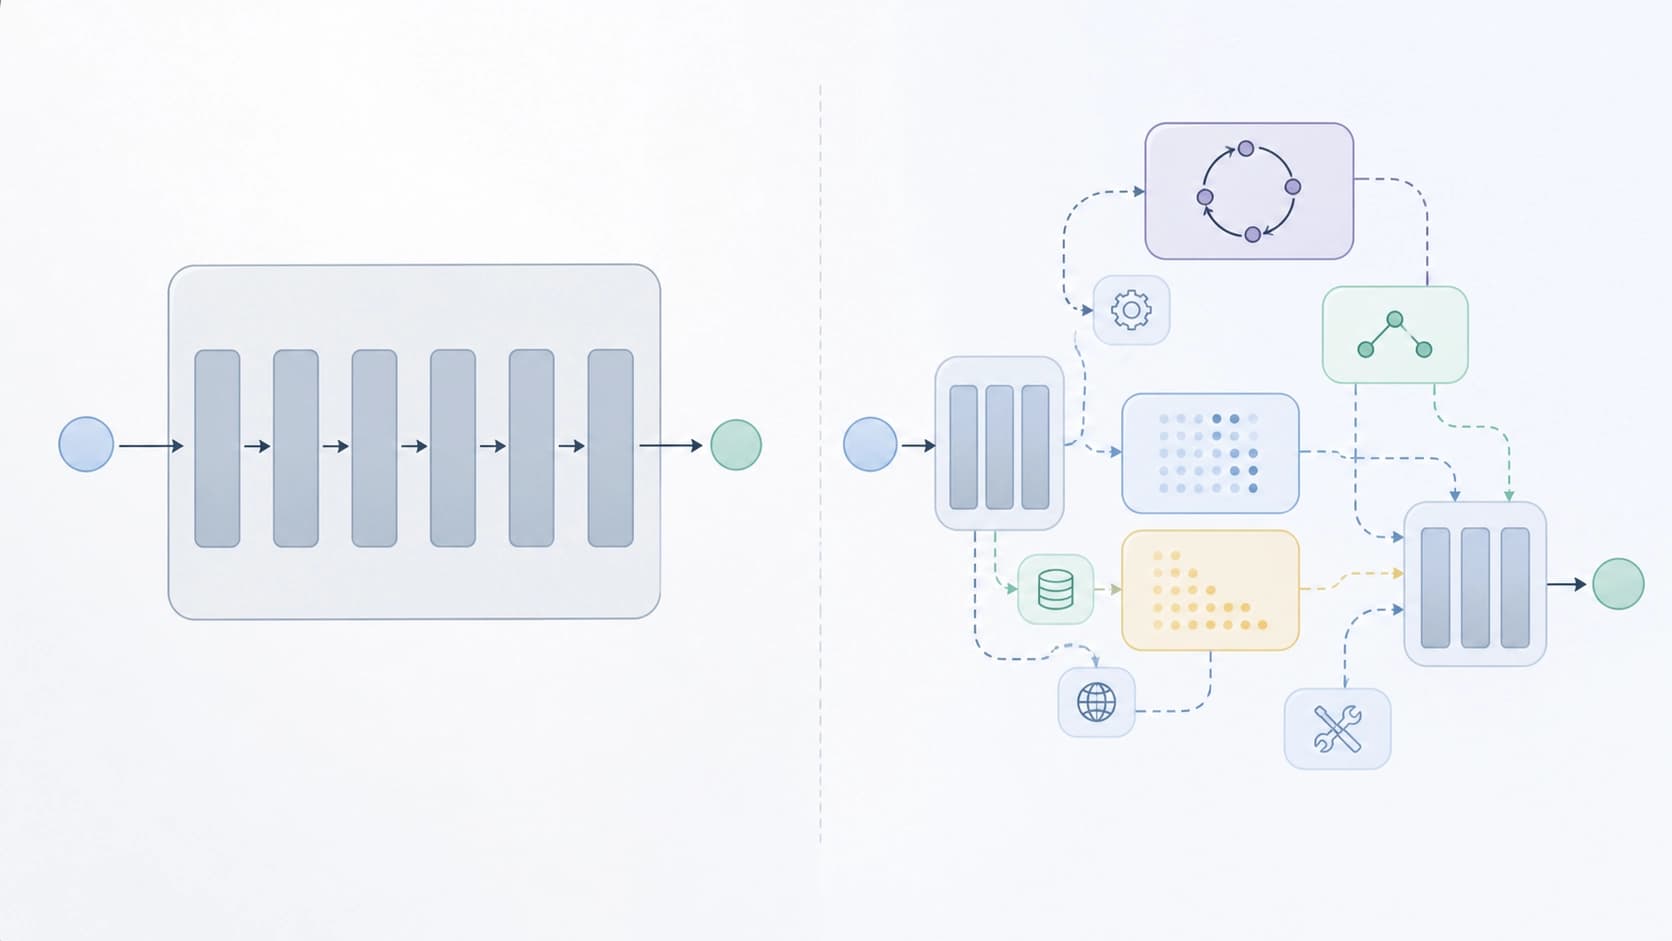
O problema é que a própria área avança mais rápido do que o desenvolvimento dos simuladores. Novas cargas de trabalho — cenários agênticos, em que o modelo chama ferramentas e opera em ciclo, esquemas com fases separadas de prefill e decode — deixaram de caber no pipeline monolítico embutido nos simuladores existentes. Qualquer novo mecanismo precisa ser encaixado à força por meio de uma reformulação dolorosa do núcleo. No fim, a lacuna entre o que realmente roda em produção e o que o simulador consegue reproduzir só aumenta.
A ideia: um simulador que se expande sozinho
Uma equipe de pesquisadores decidiu enfrentar esse problema — Wonung Kim, Hyunmin Choi, Minsu Kim, Jaehong Cho, Yeongwook Kim e Jongse Park. Seu preprint arXiv:2608.24650 (cs.AR, cs.AI) chama-se «Simthesizer: An Agent-Driven Simulation Framework for LLM Serving Systems».
A grande virada de pensamento aqui é a seguinte: não é preciso escrever mais um simulador para um conjunto específico de mecanismos atuais — ele ficará obsoleto antes mesmo de ser lançado. É preciso construir o Simthesizer de modo que ele se expanda sozinho, conforme surgem novos requisitos. E não pelas mãos de um programador que passa um mês lendo código alheio, mas pelas mãos de um agente que entende a especificação em linguagem natural e sabe trabalhar com ela dentro do simulador.
Um único grafo dinâmico em vez de um conjunto de módulos
A base técnica da ideia é uma infraestrutura componível. No Simthesizer, todo o fluxo de trabalho de atendimento é expresso de forma uniforme: não apenas os cálculos em si, mas também as decisões de controle que coordenam esse processo — ou seja, o escalonador, a ordem de processamento, a alocação de recursos. Tudo isso é descrito como um único grafo dinâmico, que muda ao longo da simulação.
O ganho prático é claro: quando uma nova funcionalidade não precisa ser encaixada em interfaces rígidas entre subsistemas, bastando adicionar um nó ao quadro geral, o custo de expansão cai ordens de magnitude. Era exatamente aí que surgia antes a «reformulação invasiva» — toda a lógica estava espalhada pelo código, e qualquer novo mecanismo afetava metade do simulador.
Agente sintetizador: pedido em palavras, não fork de código
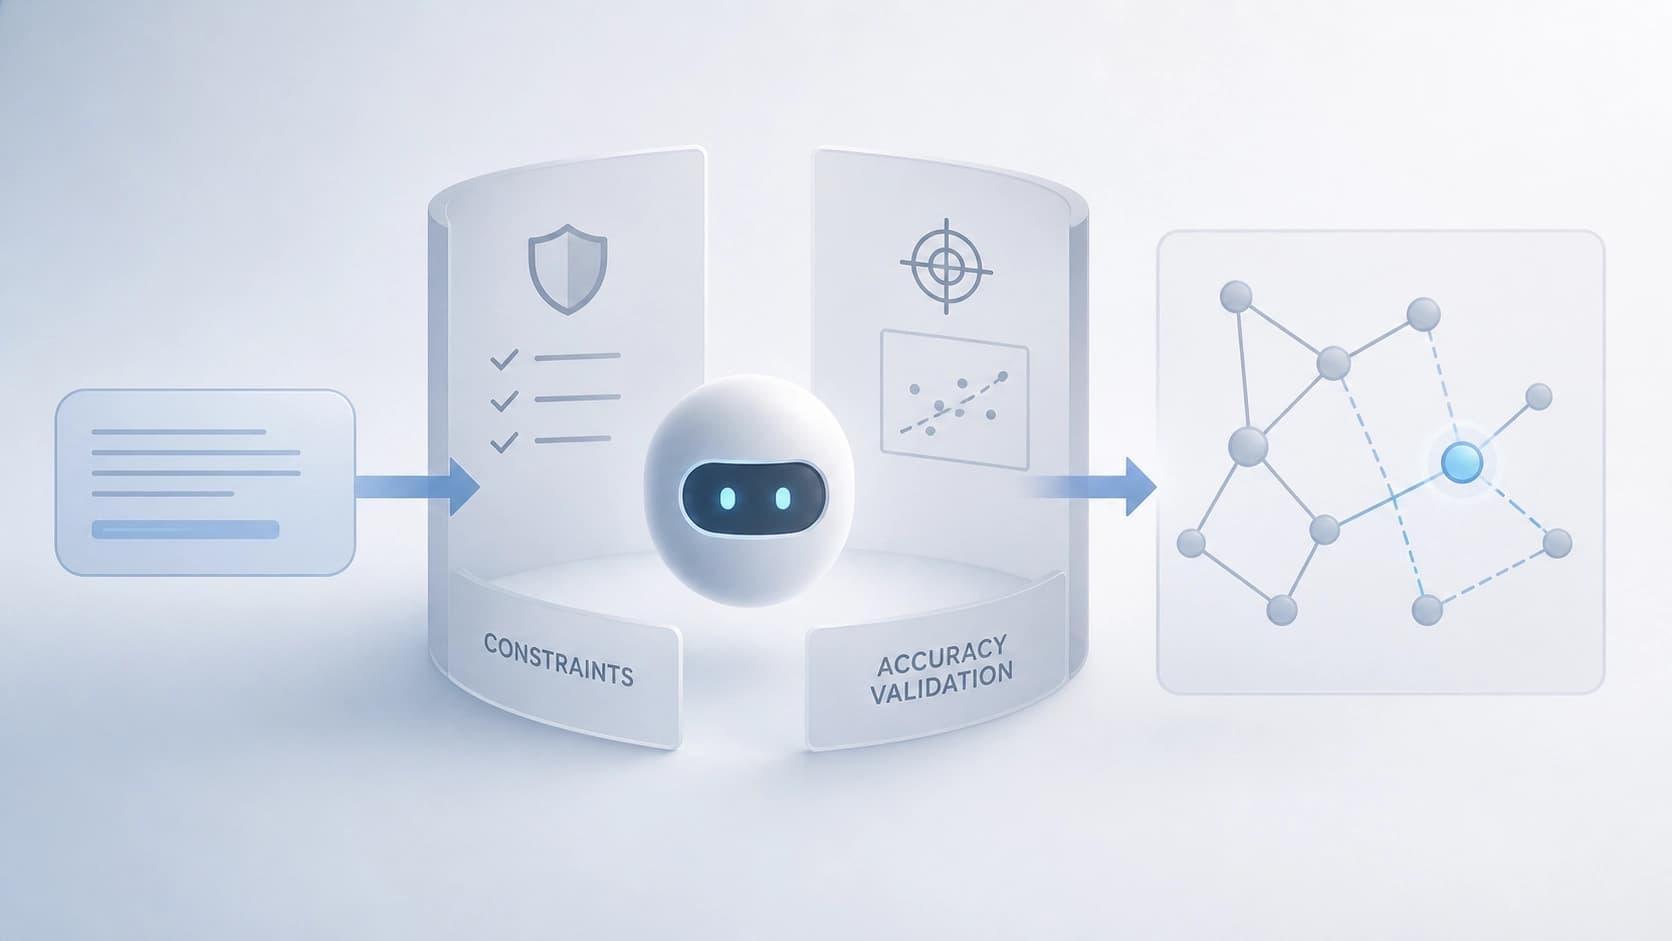
O segundo elemento é o Synthesizer agent, que os autores descrevem como um «coding agent sob rédea» (harnessed coding agent). Sua tarefa é traduzir pedidos sobre as funções desejadas, formulados em linguagem humana comum, para aquela representação abstrata dentro do simulador.
A palavra-chave aqui é «sob rédea». O agente não escreve o que quer: ele opera dentro de restrições específicas de cada simulador, e seu resultado passa por uma validação de fidelidade da modelagem (fidelity validation). Sem essa etapa, a iniciativa se tornaria um gerador de código plausível, porém incorreto. Outro detalhe importante: o agente desenvolve um único simulador comum, em vez de multiplicar um novo para cada recurso — caso contrário, teríamos apenas o mesmo zoológico de forks incompatíveis, só que criado automaticamente.
O quanto isso funciona
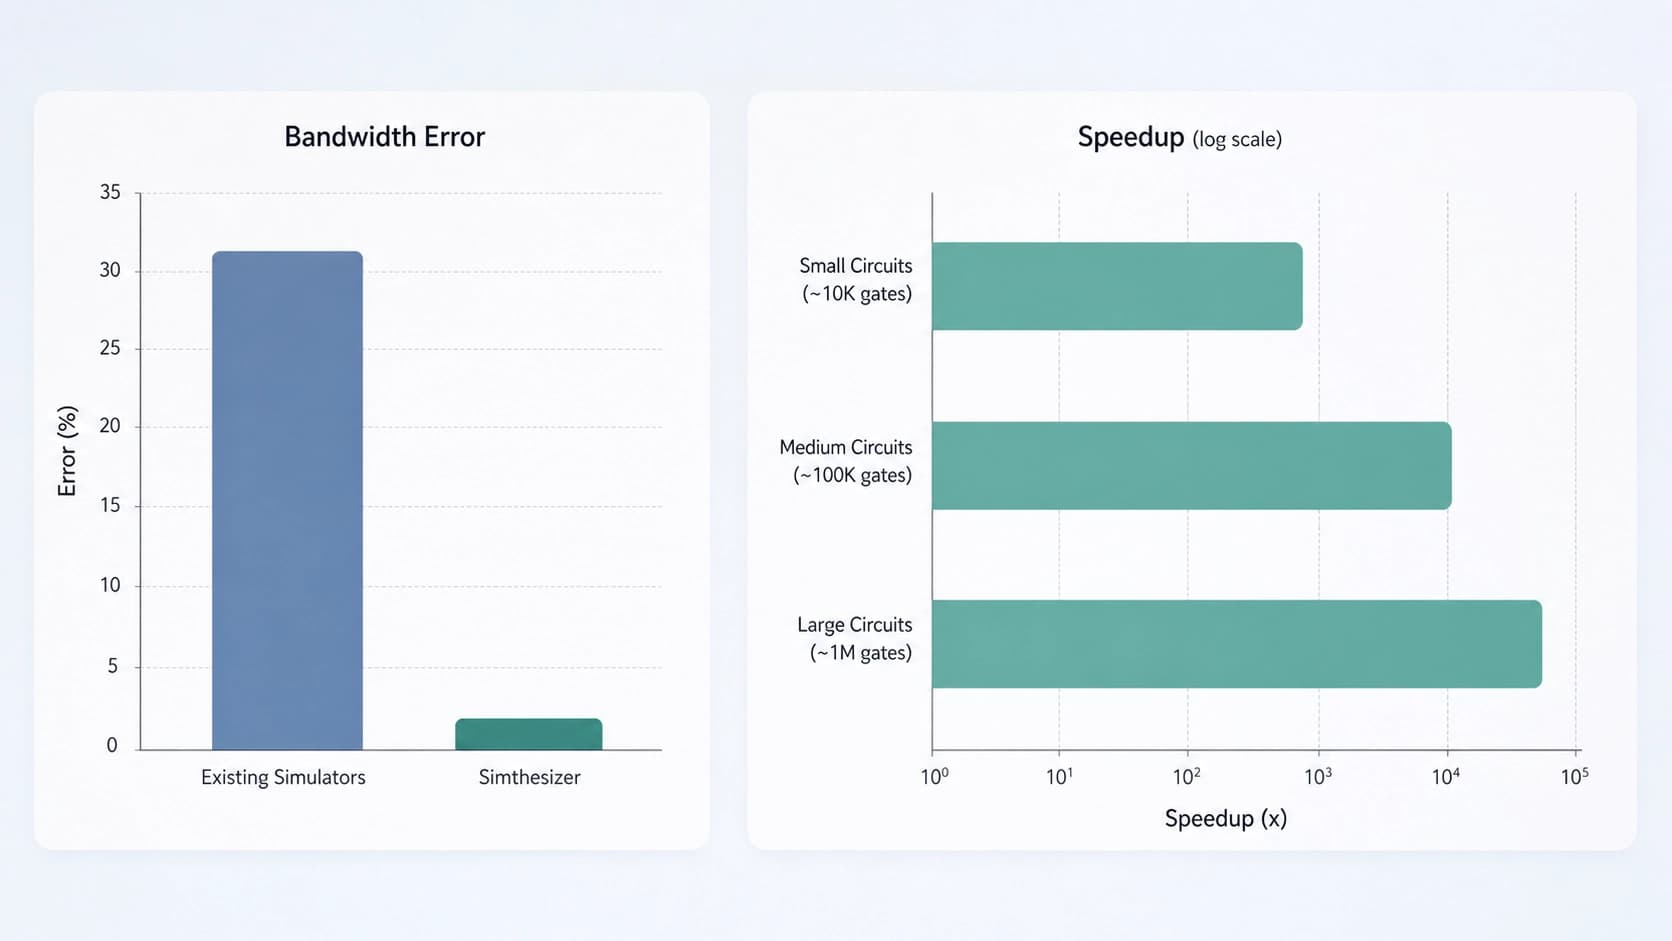
Os autores testaram a abordagem não com dados sintéticos, mas em comparação com a realidade. As extensões construídas sobre o Simthesizer reproduziam um sistema baseado em vLLM com erro médio de throughput de 2,51%. Nas extensões sobre simuladores existentes, a mesma métrica é de 6,03%. A diferença é de mais que o dobro, e ainda assim foi usado o mesmo coding agent com a mesma estrutura: ou seja, o ganho vem justamente da arquitetura do simulador, e não de uma escolha feliz do modelo executor.
A velocidade impressiona não menos. Em cargas de trabalho idênticas, o Simthesizer modelou até 284,96 vezes mais rápido que o LLMServingSim2.0 e até 23,19 vezes mais rápido que o Vidur. Ordens de magnitude assim mudam o próprio caráter da pesquisa: em vez de «rodar uma execução e esperar», surge a possibilidade de testar dezenas de configurações e comparar cenários entre si.
O que isso muda e o que vale lembrar
Se a abordagem pegar, a mudança ocorrerá não apenas nos números, mas também no papel da própria ferramenta. O simulador deixará de ser um artefato congelado, que alcança a realidade com um ou dois anos de atraso, e se tornará um sistema que pode ser ajustado a uma nova tarefa em uma única conversa. Para quem projeta infraestrutura de inference, isso significa um ciclo mais barato de teste de hipóteses: não é obrigatório montar um ambiente primeiro para entender se a ideia vai compensar.
Mas há também questões que os autores deixam de lado. Quão confiavelmente a validação de fidelidade captura erros sutis do agente — por exemplo, quando um novo nó funciona formalmente, mas altera de forma imperceptível o comportamento sob uma determinada combinação de carga e timings? Como a abordagem se transfere para coisas específicas de hardware, como aceleradores não padronizados? E, por fim, permanece em aberto a questão da confiança: quando o simulador cada vez mais se escreve sozinho, alguém precisa saber ler o que resultou disso.
Por ora, o resultado é simples e compreensível: a combinação «arquitetura componível mais agente com poderes limitados» proporciona uma modelagem tanto mais precisa quanto visivelmente mais rápida do que os simuladores cuidadosamente polidos, porém rígidos, da geração anterior. É exatamente o caso em que era mais acertado mudar não o modelo, mas o próprio dispositivo da ferramenta.