O problema do orçamento uniforme de especialistas
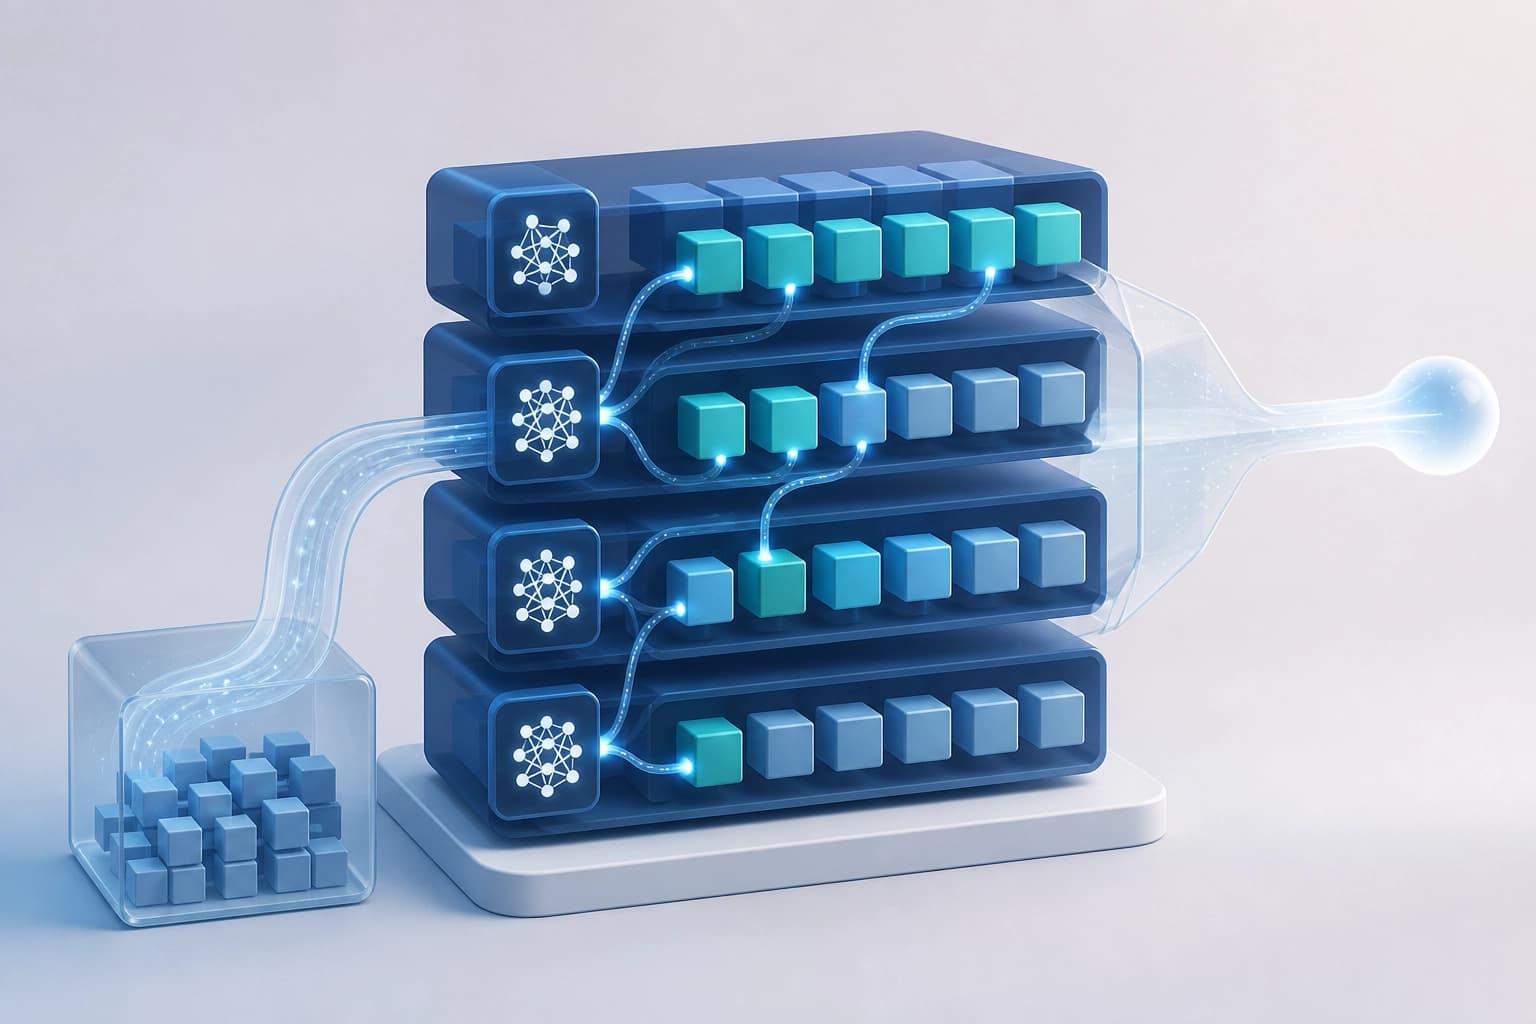
Os transformers MoE com ativação esparsa fixam o mesmo número de especialistas roteados em todas as camadas. Isso ignora a heterogeneidade documentada de redundância entre as camadas.
O MAPLE é um framework plug-and-play. Ele redistribui o orçamento de especialistas roteados entre as camadas de qualquer MoE LLM pré-treinado. O método não altera os pesos e não requer retreinamento.
Propriedades principais:
- Distribuição heterogênea do orçamento entre as camadas.
- Ausência de alteração nos pesos do modelo.
- Ausência de retreinamento.
- Aplicabilidade a MoE LLM pré-treinado.
Critério prático: a abordagem é necessária quando se deseja alterar a distribuição de especialistas sem alterar os pesos e sem retreinamento.
Sensibilidade das camadas e fórmula fechada
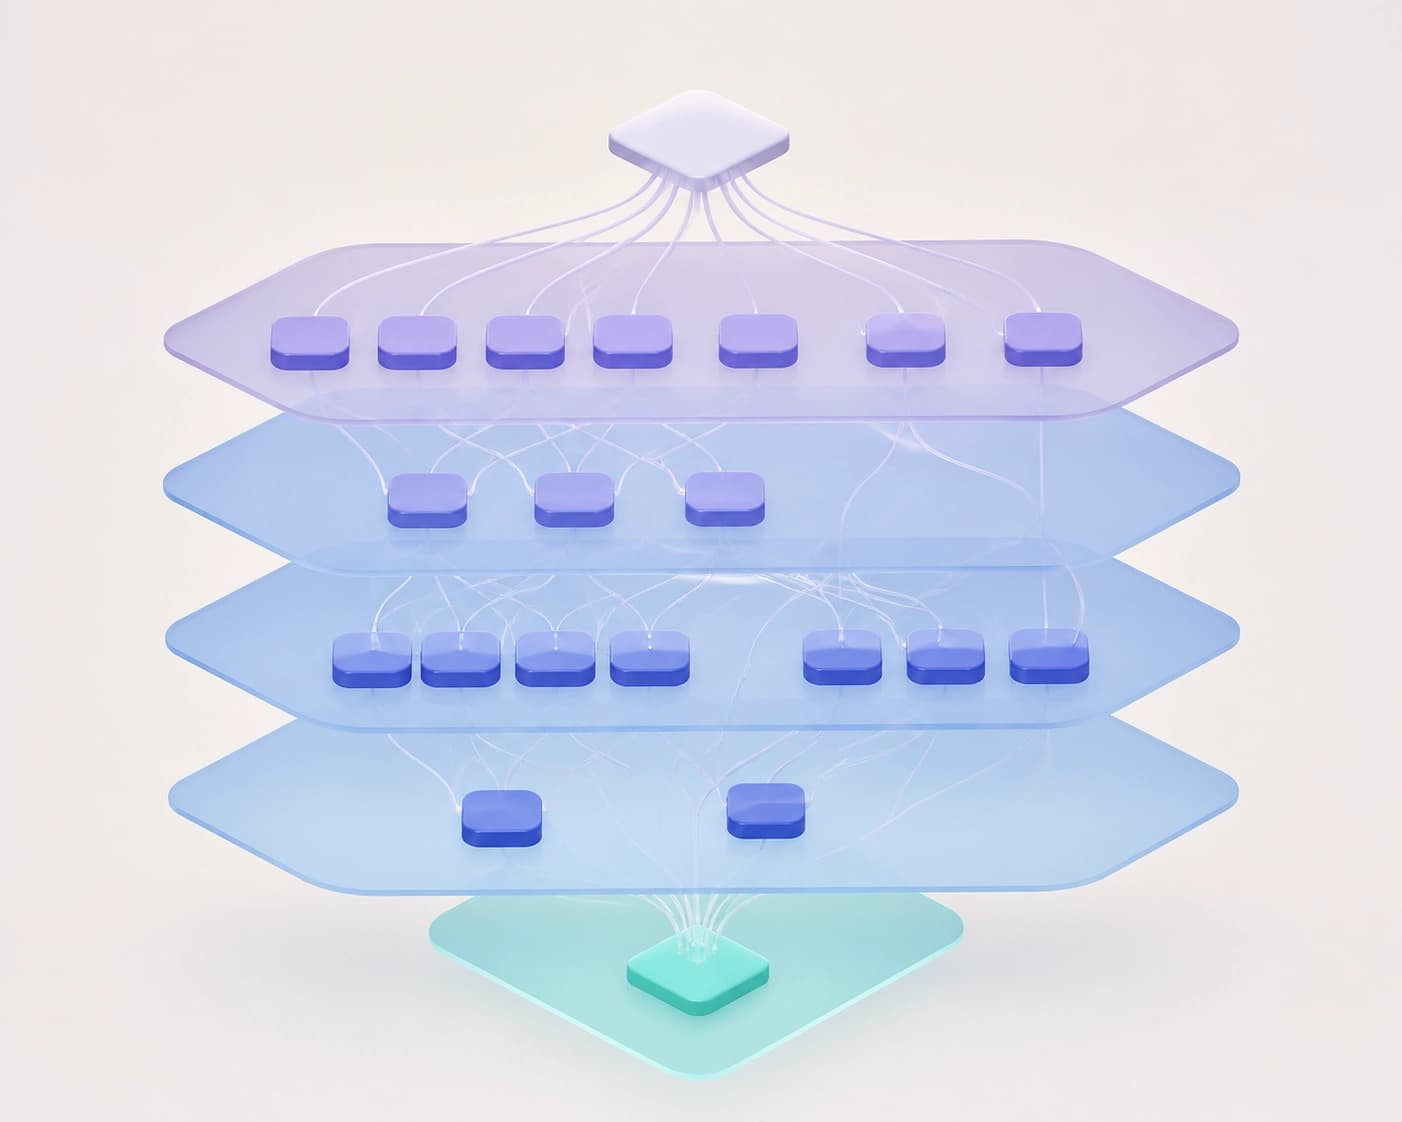
O MAPLE sonda cada camada. O método verifica a reação da camada à mudança no número de especialistas. A sensibilidade é quantificada por três medidas.
Etapas da transferência de orçamento:
- Sondagem de cada camada.
- Avaliação da reação à mudança no número de especialistas.
- Quantificação da sensibilidade por três medidas.
- Derivação da distribuição de orçamento analiticamente ótima.
- Refinamento por busca genética com restrição de sensibilidade.
A distribuição analítica direciona a capacidade para as camadas sensíveis. Nas camadas redundantes, a redução do orçamento é absorvida. A busca genética usa a sensibilidade por camada como prior. Isso proporciona convergência mais rápida e melhor qualidade de distribuição.
Conclusão: a transferência de orçamento baseia-se na sensibilidade mensurável, e não em uma regra uniforme.
Comparação com abordagens uniformes e baseadas em pruning
O MAPLE supera baselines uniformes e baseados em pruning em quatro modelos MoE de diferentes escalas e arquiteturas. A comparação ocorre com 75% do orçamento de especialistas roteados.
| Variante | Orçamento de especialistas roteados | Resultado |
|---|---|---|
| Baseline uniforme | 75% | Inferior ao MAPLE |
| Baseline baseado em pruning | 75% | Inferior ao MAPLE |
| MAPLE | 75% | Superior a ambos os baselines |
| Baseline uniforme | 100% | Inferior ao MAPLE com 75% no DeepSeek-MoE-16B em ARC-E, ARC-C e BoolQ |
No DeepSeek-MoE-16B, o MAPLE usa apenas 75% dos especialistas. Ainda assim, supera o baseline uniforme original de 100% em ARC-E, ARC-C e BoolQ.
Aumento da precisão:
- ARC-E: de 65,09 para 71,40.
- ARC-C: de 48,49 para 51,50.
- BoolQ: de 80,03 para 82,38.
Conclusão: a distribuição heterogênea pode ser mais eficaz do que simplesmente ativar um número maior de especialistas.
Eficiência no serving com SGLang
A implementação do MAPLE no SGLang reduz a latência end-to-end do serving em uma única GPU em 32,2%. A taxa de transferência cresce 47,4%.
O método não altera os pesos. Por isso, pode ser integrado ao stack de serving MoE existente. Isso torna a transferência de orçamento uma alavanca prática para a inferência.
Critério prático: para serving em GPU única via SGLang, o método proporciona redução de latência e aumento da taxa de transferência.
Critérios de escolha
Vale considerar o MAPLE em várias situações:
- É preciso reduzir o orçamento de especialistas roteados sem retreinamento.
- O modelo é um MoE LLM pré-treinado.
- É necessário considerar a heterogeneidade por camada, e não uma regra uniforme.
- É preciso aumentar a eficiência da inferência MoE.
Conclusão: a distribuição heterogênea de especialistas torna-se um eixo fundamental e prático para aumentar a eficiência do MoE.