O que é reutilizado exatamente
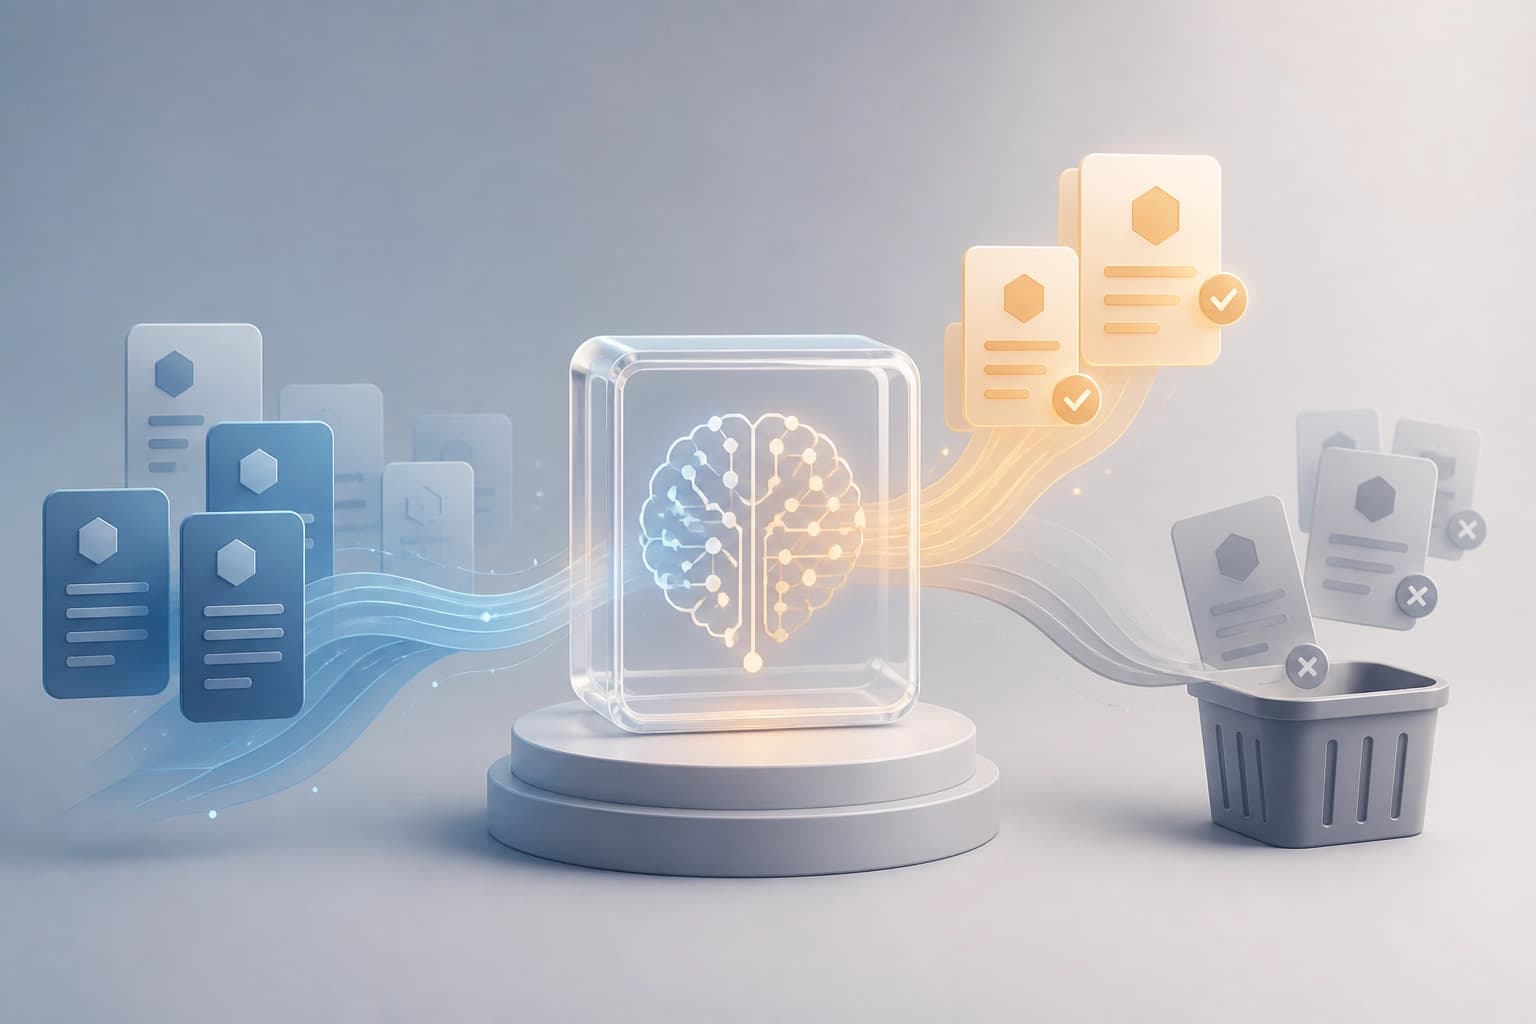
No GRPO comum, cada rollout participa de uma atualização de gradiente e, depois, é descartado. O método do artigo altera este ciclo: guarda rollouts individuais e volta a incluí-los no treino.
O buffer armazena gerações individuais, não grupos inteiros. O replay dá-lhes prioridade com base no valor do advantage: os rollouts com valores mais elevados são reutilizados.
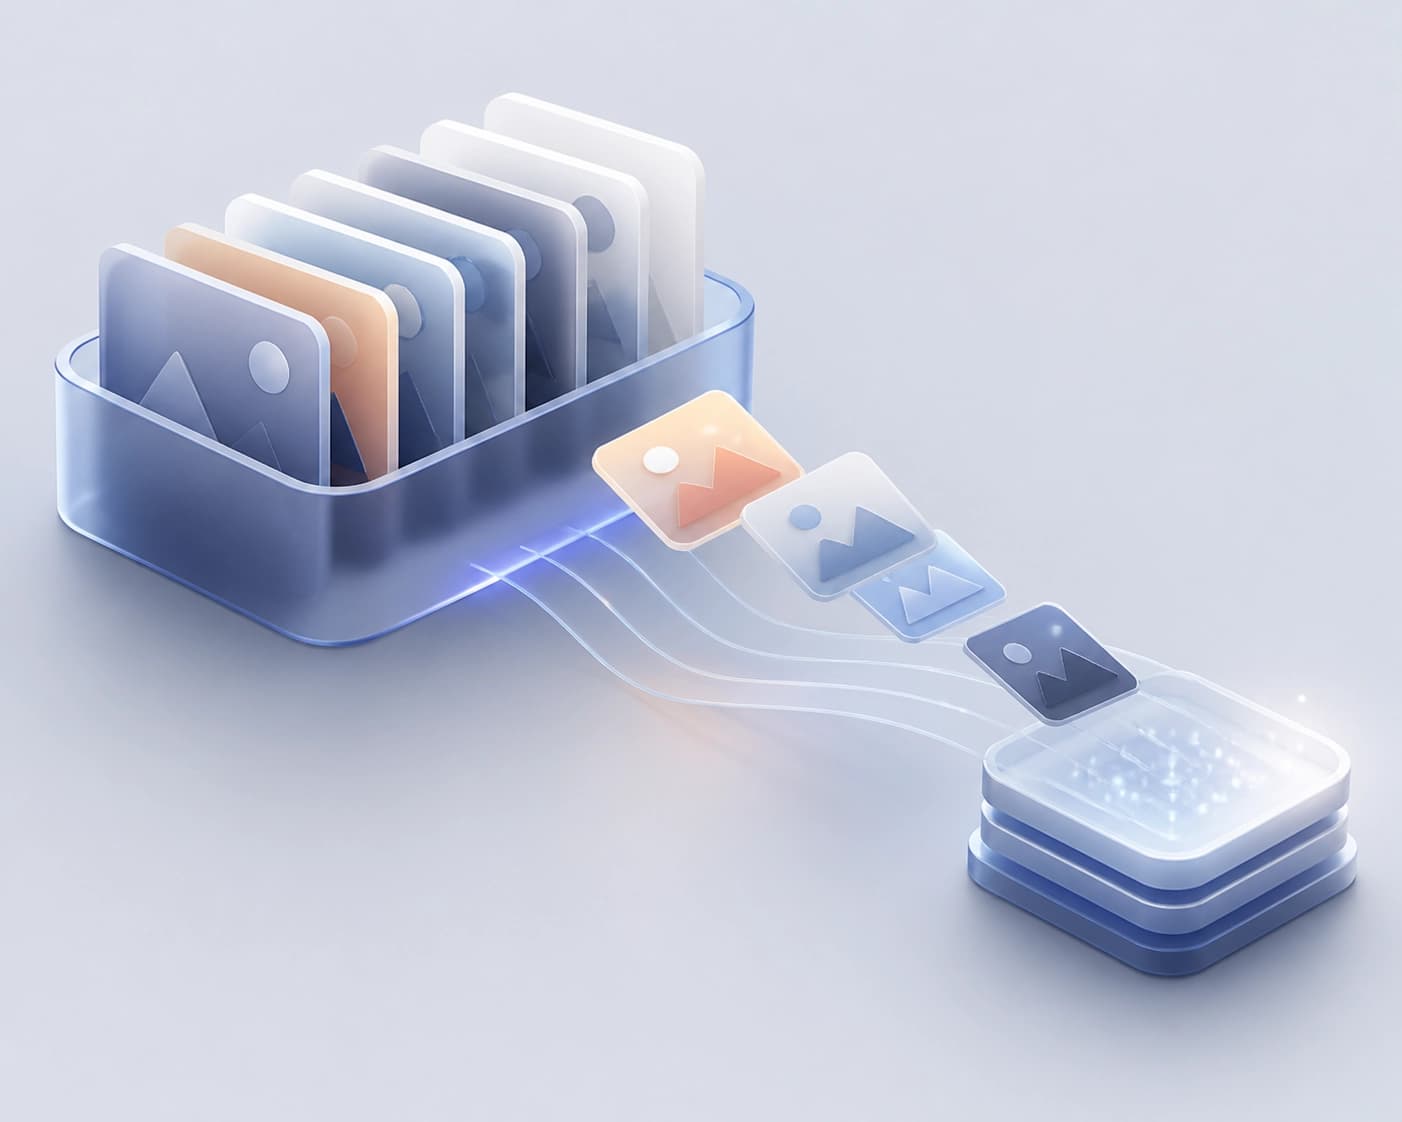
Critério prático: trata-se da reutilização de rollouts individuais, não de grupos.
Como funciona o replay
Cada batch é formado em duas etapas:
- Inclui rollouts on-policy recentes.
- Acrescenta rollouts selecionados individualmente a partir do buffer.
Na seleção dos elementos para replay, considera-se o valor do advantage de cada rollout. Os factos descritos não especificam a proporção de replay no batch.
A principal diferença do método é que os rollouts recentes continuam no batch, enquanto o buffer os complementa com gerações selecionadas.
Como é limitado o envelhecimento
Os autores referem um problema do replay ingénuo: as políticas de LLM mudam rapidamente a cada passo de gradiente. Os rollouts guardados podem ficar desatualizados e desestabilizar o treino.
O método remove do buffer qualquer rollout com mais de tau_max passos de treino. Isto estabelece um limite de armazenamento, mas não elimina o facto de haver reutilização.
O critério de controlo é a idade de cada rollout, medida em passos de treino, e não a sua pertença a um grupo.
O que mostrou a avaliação
O método foi testado em três escalas do Qwen3-Base e em cinco benchmarks de matemática. Superou o GRPO e as baselines de replay ingénuo.
- Em cada escala, o ganho na média dos cinco benchmarks foi positivo.
- Na escala de 4B, o ganho chegou a +1.66 pp.
- Segundo a AES, uma métrica que avalia em conjunto a precisão e a eficiência de tokens, o método foi a única opção com uma vantagem positiva em relação ao GRPO em cada escala.
O critério prático de escolha depende da avaliação pretendida: os resultados abrangem precisão, eficiência de tokens e a comparação com duas baselines.