
Como os spikes alteram o processamento dos pesos
No artigo «Spike-Aware INT8 Execution for Spiking Language Models on Commodity CPUs», Ting Liu descreve a descodificação de um modelo de linguagem spiking numa CPU.
- As ativações binárias de spikes permitem ler apenas as colunas ativas dos pesos.
- As multiplicações são substituídas por somas de pesos.
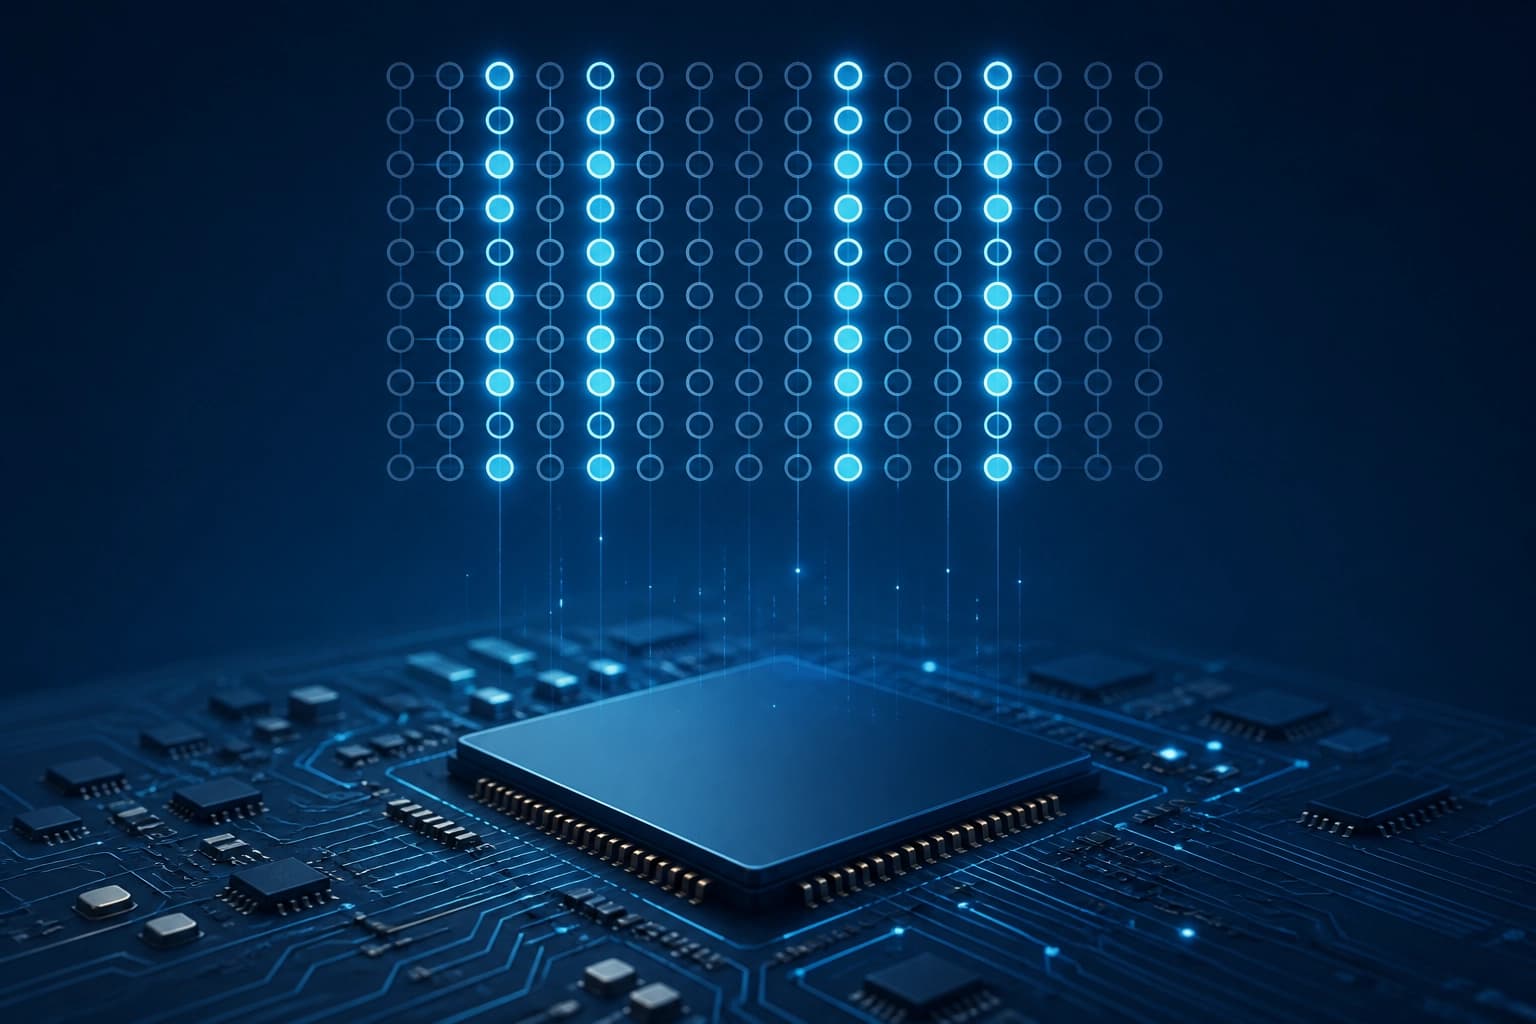
Na prática, a abordagem evita processar as colunas que não foram ativadas. O ganho depende da esparsidade das ativações, e não apenas do formato dos pesos.
Como funciona o percurso INT8
A implementação em C++ foi testada num modelo de linguagem com gating por spikes e 874M parâmetros. Utiliza modos diferentes para projeções esparsas e densas.
- Nas projeções esparsas, os pesos INT8 são armazenados em formato column-major.
- A acumulação é feita em números inteiros, e a escala é aplicada uma única vez para cada canal de saída.
- Nas projeções densas, mantêm-se o acesso row-major e as ativações FP32.
Trata-se de um esquema misto, não da conversão de todas as operações do modelo para INT8. O critério de escolha é aceitar manter FP32 nas projeções densas em troca de um percurso INT8 esparso.
Que valores de velocidade e armazenamento são apresentados
Um checkpoint inicial foi comparado com uma thread. Neste teste, o INT8 apresentou maior débito de descodificação e menor espaço de armazenamento dos pesos.
| Checkpoint inicial, uma thread | Velocidade de descodificação | Armazenamento dos pesos |
|---|---|---|
| FP32 | 9.82 tokens/s | 3355.2 MiB |
| INT8 | 23.31 tokens/s | 1087.4 MiB |
Para o checkpoint final, são apresentados resultados separados no AMD Ryzen 7 5800X. As condições diferem das da comparação do checkpoint inicial.
| Modo INT8 do checkpoint final | Valor |
|---|---|
| Descodificação, uma thread | 22.63 tokens/s |
| Descodificação, quatro threads | 47.90 tokens/s |
| Prefill de uma sequência de 512 tokens, oito threads | 94.68 tokens/s |
Estes valores não devem ser reunidos diretamente numa única tabela comparativa: referem-se a checkpoints e modos diferentes. Para avaliar o débito, são importantes tanto a versão do checkpoint como o número de threads.
O que muda com a variante INT4
A variante INT4 para projeções densas reduz o espaço de armazenamento em mais 17.4%. Em contrapartida, o débito de descodificação diminui 46.6%.
Na versão corrigida do artigo, foram retirados os resultados inválidos para INT4 puro. Por isso, o compromisso apresentado diz respeito ao INT4 nas projeções densas, e não a um modelo totalmente INT4.
O critério de escolha é dar prioridade ao armazenamento em detrimento da velocidade de descodificação. Os resultados de INT4 puro não podem ser usados como prova de desempenho.
O que se sabe sobre o consumo de energia
Num estudo separado da cabeça de saída em ARM, foram registados valores de energia mais elevados para duas configurações de verificação de candidatos, numa janela de descodificação truncada.
A versão corrigida do artigo também acrescenta uma validação numérica e um estudo do consumo de energia com base na potência medida na tomada (wall-power) em ARM. Os dados dos testes de velocidade em CPU não são suficientes para concluir que há poupança de energia.


