
Por que o formato de apresentação não é um detalhe de implementação
Quando testamos a memória de um modelo de linguagem ou a qualidade de um pipeline RAG, normalmente nos interessa exatamente uma coisa: o modelo chegou ao fato certo. E a forma como esse fato apareceu no contexto de entrada — um registro de memória separado, um resumo condensado, um registro estruturado com campos ou um trecho bruto de conversa — costuma ser tratada como assunto interno do sistema. A lógica é simples: se o fato está lá, não importa como está empacotado.
Os autores do preprint arXiv:2608.23568 propõem discordar disso. Seu trabalho "RENDER: Controlling Reader-Facing Evidence in LLM Memory Evaluation" (Yuan Si, Simeng Han, Daming Li, Jialu Zhang; v1 de 5 de junho de 2026) ataca a própria ideia de que a memória tem uma avaliação única, honesta e universal. Em vez disso, propõem medi-la da mesma forma como se medem outras propriedades sensíveis à configuração: fixar uma variável e variar os valores da outra.
O que exatamente o RENDER controla
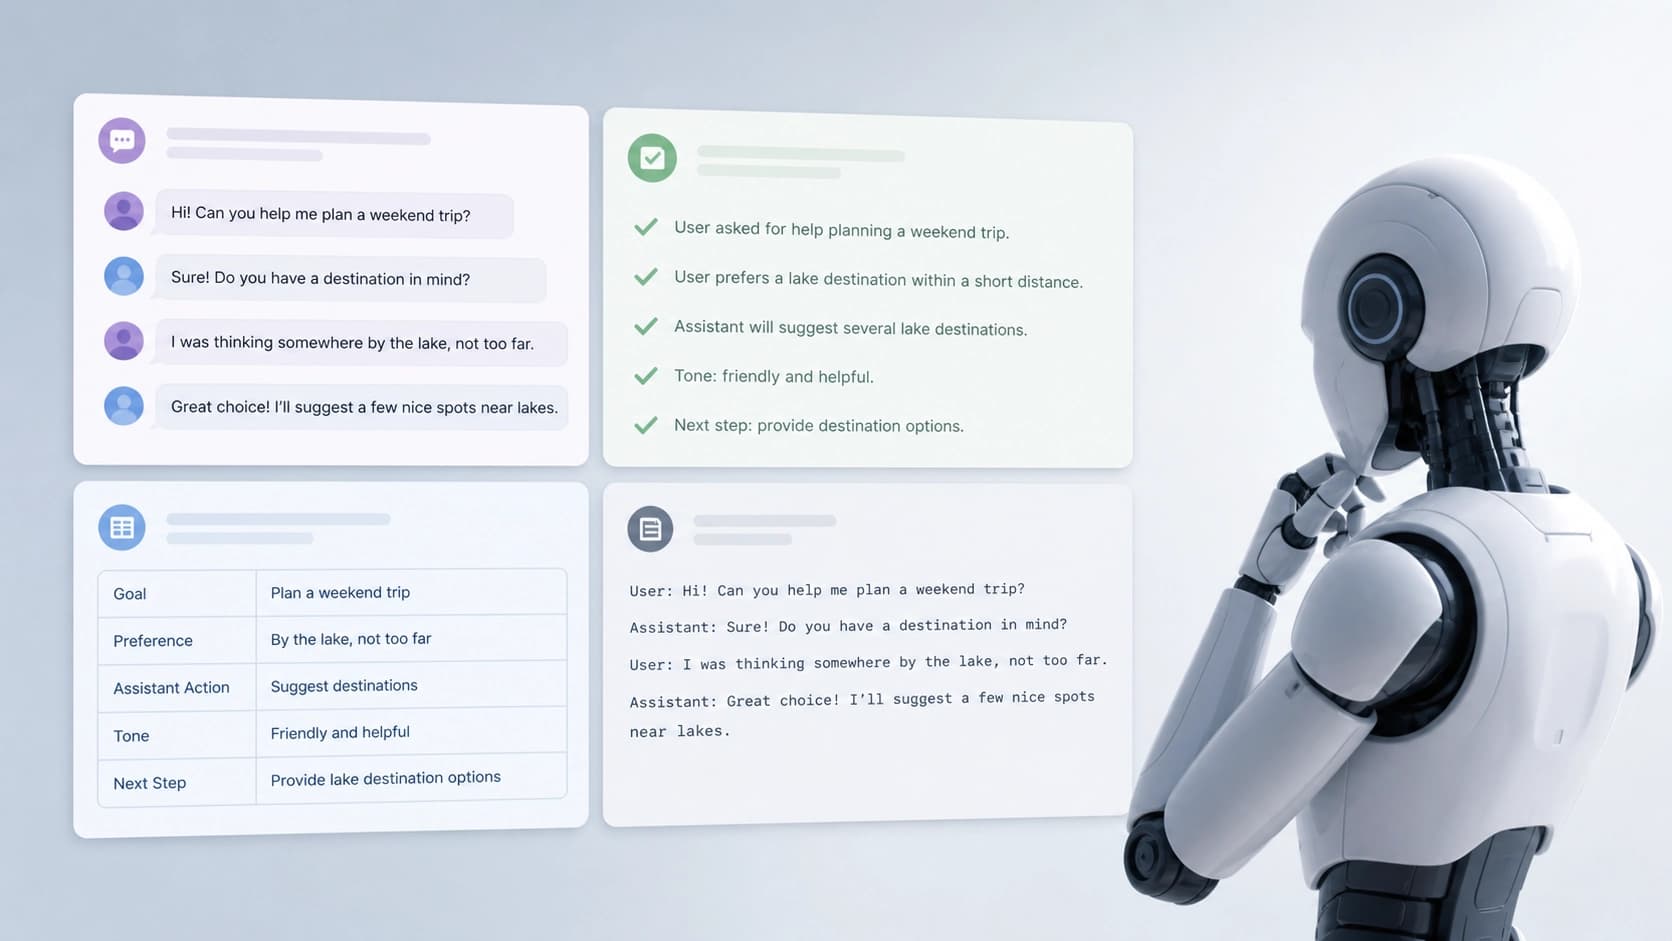
O diálogo não muda. Muda apenas o artefato voltado ao leitor: aquilo que o modelo respondente efetivamente vê diante de si. É justamente essa camada — reader-facing artifact — que o RENDER transforma em variável controlada.
A escada de cinco níveis
O núcleo da metodologia é a five-level packet ladder. Não é apenas um conjunto de formatos, mas uma escala que localiza o momento em que o conteúdo portador da resposta entra na entrada do modelo respondente. O sentido é separar duas falhas fundamentalmente diferentes: o sistema não encontrou o fato certo e o sistema o encontrou, mas não conseguiu transmiti-lo de forma utilizável. Sem essa escala, esses casos se fundem em uma única linha de relatório, e daí começam conclusões equivocadas — por exemplo, de que o modelo "tem memória ruim", quando na verdade ele simplesmente não decifrou o empacotamento.
Quatro templates de apresentação
O segundo elemento são templates determinísticos que aproximam as formas típicas de mostrar o histórico ao usuário. São quatro:
- registros no estilo ChatGPT — blocos organizados, semelhantes ao que a pessoa vê na interface de um chatbot;
- resumos no estilo LangChain — paráfrases condensadas que perdem as formulações, mas preservam a essência;
- registros tipados no estilo MemGPT — estrutura com campos e categorias, conveniente para processamento automático;
- diálogo bruto — falas como estão, sem formatação nem reempacotamento.
Os templates são determinísticos: a mesma entrada produz sempre o mesmo texto. Isso é importante, porque de outra forma não seria possível distinguir o efeito do formato da variação aleatória da geração.
O que os números mostraram
O experimento se apoia em 500 perguntas do LongMemEval e nove modelos. Vale a pena parar aqui: não é uma única execução nem um único teste em busca de um número bonito, mas uma grade "modelo × formato de apresentação", que é o que permite ver o efeito.
O resultado principal: matched-budget resolved packets superam recency-truncated raw dialogue em 42,4–72,6 pontos. Em outras palavras, se os formatos forem equiparados a um orçamento comparável e o modelo receber conteúdo que realmente carrega a resposta, a diferença em relação à forma mais ingênua de apresentação — o diálogo bruto truncado por recência — não é cosmética, mas desabadora.
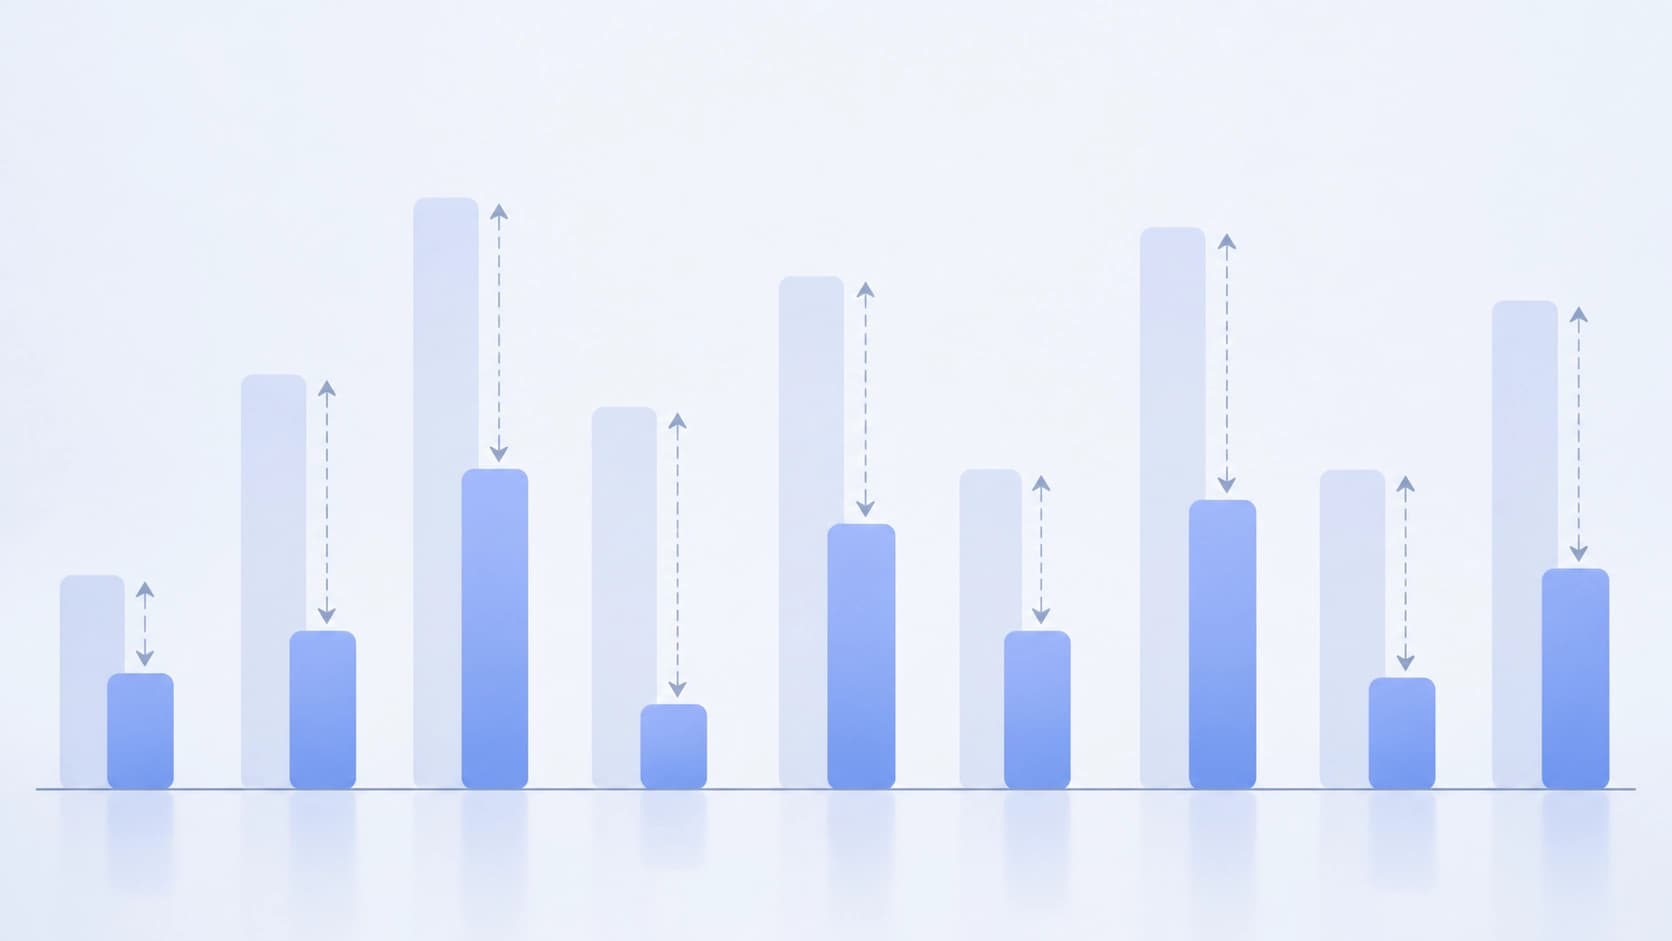
Nos templates deployed-style o quadro é mais suave, mas ainda assim expressivo: a variação entre o melhor e o pior formato é de 24,6–48,8 pontos para cada um dos nove modelos. Ou seja, dentro de um mesmo modelo, com as mesmas perguntas, com o mesmo orçamento, é possível "perder" ou "ganhar" dezenas de pontos simplesmente pela forma como a evidência se apresenta.
Outro detalhe da pontuação primária: em 7 dos 9 modelos, os registros no estilo ChatGPT recebem pontuações pontuais mais altas do que o diálogo bruto. Essa é, talvez, a conclusão mais incômoda para quem constrói métricas sobre o histórico de conversa "puro".
O juiz também não é a verdade absoluta
Um enredo à parte é o que acontece quando as avaliações são recalculadas não por um scorer automático, mas por um modelo-juiz (judge rescoring). O efeito positivo agregado do formato se mantém, mas a significância por modelo individual torna-se mista. Em termos simples: a tendência no nível de toda a amostra não desaparece, mas afirmações pontuais do tipo "o modelo X ganha justamente por causa do formato Y" já não são tão confiáveis após a reavaliação.
Isso não é motivo para abandonar os juízes LLM, mas é um bom lembrete: qualquer avaliação de memória é, ela mesma, um instrumento de medição com sua própria sensibilidade ao formato da entrada. E se o sistema e o juiz reagem de forma diferente ao empacotamento das evidências, a diferença pode se perder no ruído ou, ao contrário, virar um sinal falso.
O resultado mais ilustrativo: zero contra cinquenta
Se for para tirar um único número do artigo, vale tirar este. Três modelos que mostraram 0 % em formal ledger packets responderam aos mesmos fatos a partir de natural-language entries com precisão de 45,4–53,4 %.
Não é "um pouco melhor", nem "dentro da margem de erro" — de zero absoluto a acertos consistentes em metade dos casos com conteúdo idêntico. Uma diferença dessas é difícil de explicar por falta de conhecimento do modelo ou por busca ruim: os fatos estavam lá, só mudava a forma de apresentá-los. Um registro formal, legível por máquina, de algum modo se tornava intransponível para o modelo, enquanto a mesma informação exposta em linguagem comum era lida sem problemas.
Para o engenheiro, isso é um sinal prático: se o seu pipeline armazena a memória em blocos estruturados rígidos, você pode estar subestimando sistematicamente as capacidades do modelo — e, ao mesmo tempo, superestimando o benefício da formalização.
Quão robusto isso é
O efeito não se desfaz quando as condições se complicam: ele se mantém sob retrieval noise, ou seja, quando fragmentos extras são misturados ao contexto. Mais ainda, ele se transfere para o HotpotQA — outro conjunto de dados, construído em torno de perguntas de múltiplos passos. Isso é importante, porque afasta a suspeita de que tudo se deva à especificidade de um único benchmark de memória longa.
As limitações também merecem ser lembradas: os templates aproximam as formas reais de apresentação, mas não as reproduzem literalmente, e as conclusões sobre modelos específicos após a reavaliação são mistas. Portanto, não se trata de receitas prontas, mas da necessidade de ao menos notar essa variável.
O que fazer com isso na prática
A conclusão dos autores é bastante direta: relatórios de avaliação de memory/RAG devem ou informar qual reader-facing artifact foi usado, ou controlá-lo explicitamente. Abaixo, como isso se apresenta na prática:
- Fixe o formato na descrição do teste. "Rodamos o modelo no LongMemEval" é uma descrição insuficiente se não se diz em que forma o histórico entrou na entrada.
- Rode ao menos dois ou três formatos. Um bom e um ingênuo (por exemplo, diálogo bruto truncado) já darão uma ideia da sensibilidade do seu sistema.
- Não compare modelos entre si com empacotamentos diferentes. Uma diferença de 20–30 pontos pode pertencer inteiramente ao formato, e não ao modelo.
- Verifique seus esquemas estruturados de memória. Zero em um registro formal com respostas confiantes ao mesmo fato em texto comum é um bug de apresentação, não de memória.
- Teste separadamente o canal "modelo-juiz". Se o avaliador é ele mesmo sensível ao formato, a métrica fica enviesada.
- Considere o custo do formato. Resumos e registros tipados economizam tokens; agora isso tem um lado negativo mensurável, e vale a pena pesá-lo conscientemente.
A ideia central do RENDER é simples e, por isso, incômoda: "avaliação da memória de um modelo" sem indicar a forma de apresentação das evidências é uma afirmação incompleta. O mesmo diálogo, as mesmas perguntas, o mesmo modelo, mas respostas diferentes. A diferença está em como você mostrou a ele aquilo que ele deveria lembrar.


