
RBS-Attention: aceleração do prefill de prompts longos com pesquisa de blocos subestimados
O artigo apresenta um método que complementa a seleção de blocos com base na similaridade média, procurando candidatos capazes de ocultar tokens importantes. Num contexto de 128K, os autores reportam uma aceleração de até 20,65 vezes da atenção durante o pré-preenchimento; no Qwen3-32B, o resultado no RULER foi de 88,65, contra 89,52 com atenção densa.
Que parte da inferência o método acelera
O prefill processa o prompt antes do início da geração. O self-attention denso percorre toda a entrada, pelo que um contexto longo aumenta a carga computacional desta etapa.
O RBS-Attention seleciona blocos de forma esparsa para o prefill e pode reduzir os custos computacionais. No entanto, o centróide de um bloco calcula a média da relevância dos tokens e pode ocultar um token importante entre tokens irrelevantes. Os autores chamam a esta falha mean dilution.
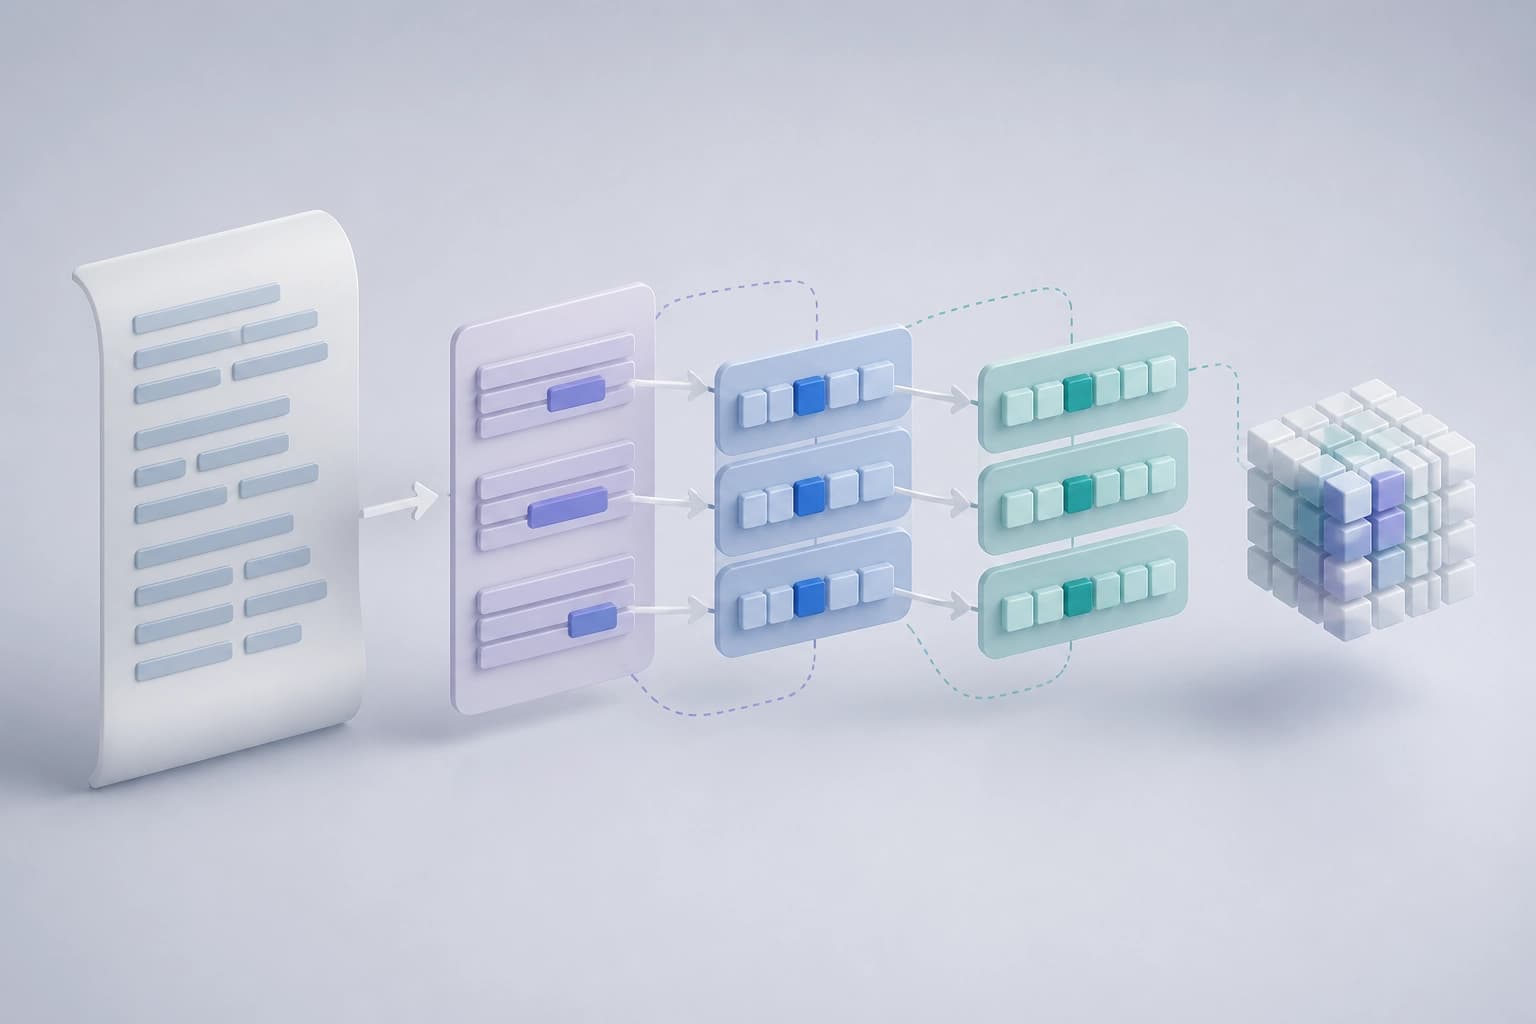
Na prática, o método acelera o prefill sem depender apenas da relevância média de um bloco inteiro.
Como funciona a seleção de blocos
O método não requer treino e utiliza dois ramos complementares:
- Ramo base estima a relevância média do bloco através do centróide.
- Ramo de recuperação tem em conta o raio máximo do bloco de chaves e a sua distribuição, que depende do prompt, da camada e da cabeça. Assim, identifica blocos cuja relevância pode ter sido subestimada.
Cada ramo aplica separadamente um limiar à sua seleção. Em seguida, o método combina as máscaras e controla o contributo dos blocos de recuperação. A execução continua a ser feita através do FlashAttention esparso por blocos convencional.
Esta arquitetura é adequada a cenários em que a seleção por centróides pode deixar passar tokens relevantes isolados, mas é necessário manter a execução esparsa por blocos.
Que resultados de velocidade são apresentados
As medições foram realizadas numa H100 com um contexto de 128K. Para o Qwen3-30B-A3B-Instruct-2507-FP8, o artigo apresenta as seguintes acelerações:
| Etapa | Aceleração |
|---|---|
| Atenção de prefill autónoma | 20.65× |
| Atenção de prefill no vLLM | 11.92× |
| Time-to-first-token de ponta a ponta | 5.97× |
Estes resultados correspondem a uma configuração específica. Devem ser considerados separadamente da avaliação da qualidade e não devem ser extrapolados para outros modelos sem as medições correspondentes.
O que se sabe sobre qualidade e avaliações
No modelo denso Qwen3-32B, a precisão geral no RULER foi de 88.65. Para o attention denso, o valor indicado foi 89.52.
A avaliação adicional da qualidade foi realizada no LongBench-v2, InfiniteBench e Video-MME. As experiências complementares mediram a preservação de dados relevantes, compararam seletores com a mesma densidade e testaram diferentes tamanhos de bloco, limiares e quantidades de memória.
Ao escolher um método, a velocidade e a qualidade devem ser avaliadas separadamente: os resultados apresentados no RULER não substituem a avaliação em tarefas importantes para uma aplicação específica.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Toollery: seleção de ferramentas para agentes LLM entre dezenas de milhares de opções sem fine-tuning
A Toollery cria um índice de pesquisa com base nas descrições de competências e ferramentas e, a cada consulta, transmite ao modelo apenas um conjunto limitado de candidatos. Em testes com bibliotecas de dezenas de milhares de funções, a abordagem permite manter a qualidade da seleção com um top-K fixo, embora o efeito final dependa do perfil de carga e do cache do fornecedor.
11 novembro 2026
Diagnóstico passo a passo de agentes GUI na análise de dashboards: benchmark DashAct
Apresentamos o DashAct — um benchmark com 348 trajetórias verificadas por humanos, que divide o trabalho de agentes GUI com painéis interativos em três etapas e quatro condições visuais. Os resultados revelam problemas persistentes na previsão de ações e na associação a alvos visuais, bem como a dependência das respostas dos agentes do suporte contextual e espacial.
11 novembro 2026
WILSON: integração de ampliações e lâminas de pacientes para análise anatomopatológica e elaboração de laudos
O preprint apresenta o WILSON — um modelo de visão e linguagem que codifica imagens de lâminas inteiras e séries de preparações de um mesmo paciente em diferentes ampliações, em vez de apenas uma lâmina «melhor». Sem ajuste fino para a tarefa, supera modelos especializados e maiores para lâminas em várias métricas, com uma carga computacional substancialmente menor, e as suas descrições diagnósticas receberam avaliações mais elevadas dos patologistas.
11 novembro 2026