
WILSON: integração de ampliações e lâminas de pacientes para análise anatomopatológica e elaboração de laudos
O preprint apresenta o WILSON — um modelo de visão e linguagem que codifica imagens de lâminas inteiras e séries de preparações de um mesmo paciente em diferentes ampliações, em vez de apenas uma lâmina «melhor». Sem ajuste fino para a tarefa, supera modelos especializados e maiores para lâminas em várias métricas, com uma carga computacional substancialmente menor, e as suas descrições diagnósticas receberam avaliações mais elevadas dos patologistas.
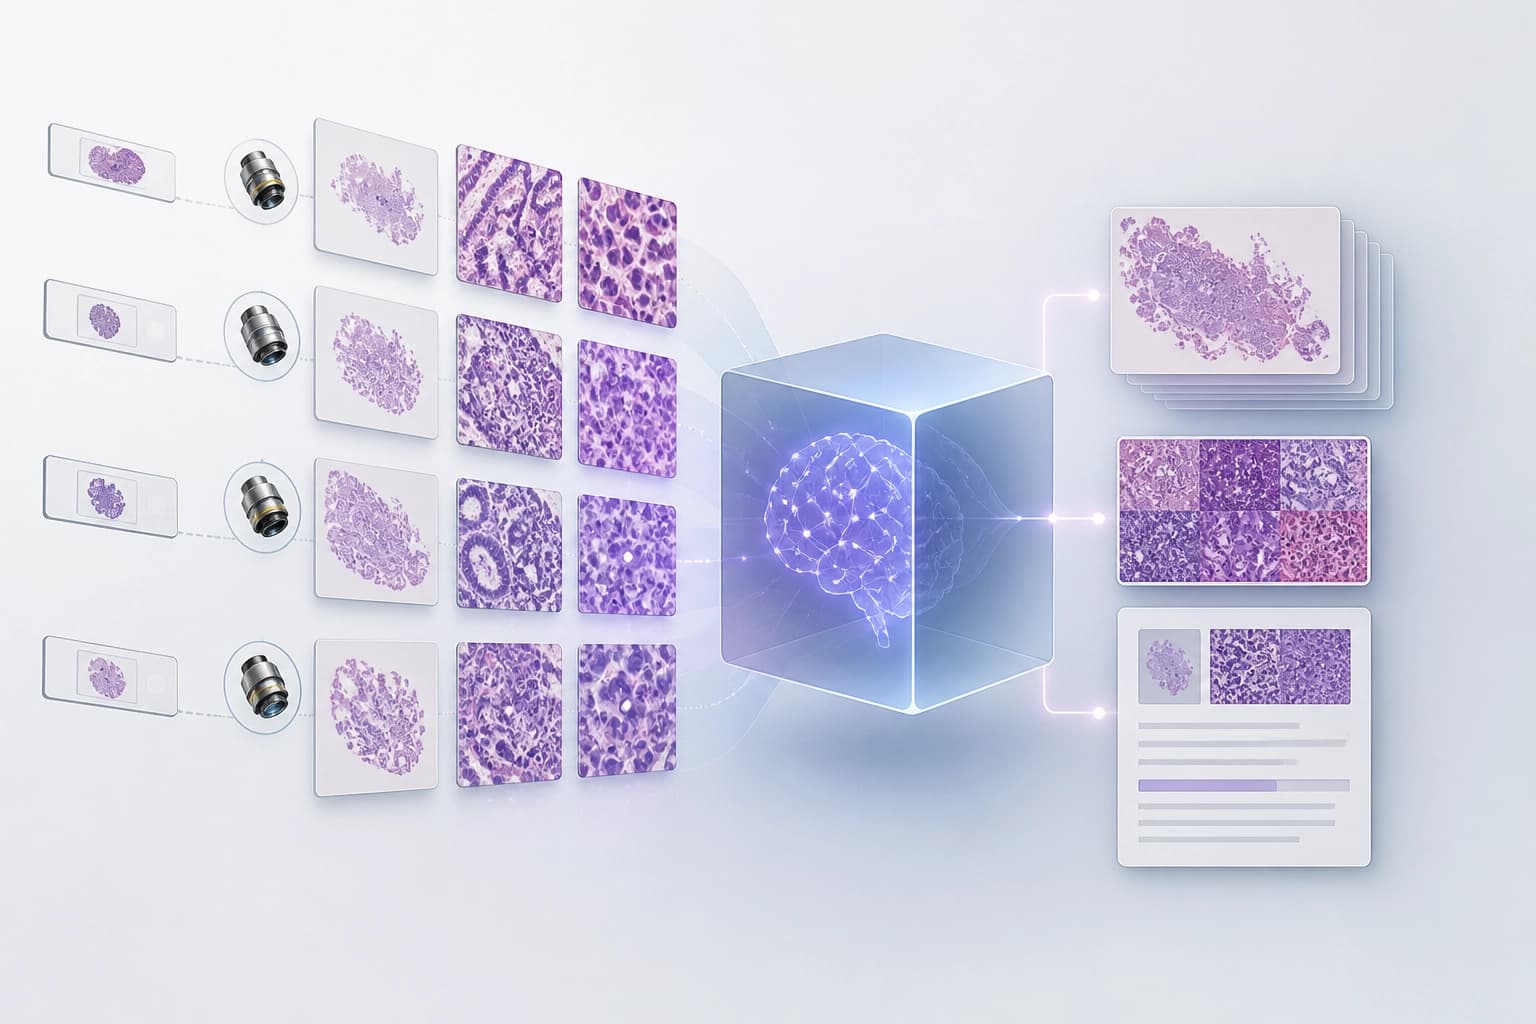
Por que uma única lâmina representativa não é suficiente
Os patologistas examinam cortes de tecido com diferentes ampliações e em várias lâminas. Combinam informações morfológicas para estabelecer um diagnóstico. A maioria dos modelos fundacionais para patologia codifica milhares de fragmentos de imagem de uma única lâmina representativa («best»). Em seguida, os modelos agregam essas características.
Limitações desta abordagem:
- o modelo recebe uma única lâmina «best», e não o caso completo;
- as características de diferentes ampliações não são ligadas numa representação comum;
- o contexto ao nível do paciente perde-se durante a agregação dos fragmentos.
Critério prático: para uma tarefa ao nível do caso, é necessário um modelo que aceite várias lâminas e diferentes ampliações. Uma única lâmina representativa não abrange este tipo de tarefa.
Como o modelo combina ampliações e lâminas
WILSON é um modelo fundacional de visão e linguagem. Representa imagens de lâminas inteiras e casos com várias lâminas através de composições multimagnificação. Permite análises ao nível do paciente.
O que a representação inclui:
- imagens de lâminas inteiras;
- casos com várias lâminas;
- várias ampliações integradas em composições multimagnificação.
Conclusão: o modelo preserva informações morfológicas de diferentes escalas e lâminas numa única representação. Isto distingue-o da abordagem com uma única lâmina «best».
Treino e cobertura dos dados
O conjunto de treino da WILSON inclui cerca de 189 000 lâminas. Os dados abrangem 42 órgãos e 838 entidades diagnósticas.
Cobertura:
- 189 000 lâminas;
- 42 órgãos;
- 838 entidades diagnósticas.
A lista de órgãos e entidades define o âmbito de verificação da tarefa. O especialista compara o órgão e a entidade diagnóstica com essa lista.
Resultados sem treino específico para a tarefa
A WILSON superou um modelo especializado ao nível do caso em macro-F1, sem treino específico para a tarefa. O resultado foi 0.52 contra 0.38.
| Comparação | WILSON | Alternativa |
|---|---|---|
| Macro-F1 numa tarefa ao nível do caso | 0.52 | 0.38 |
| Operações computacionais | 400–1 350 vezes menos | modelos ao nível da lâmina consideravelmente maiores |
O modelo também apresentou resultados ao nível dos de modelos ao nível da lâmina consideravelmente maiores. Ainda assim, requer 400–1 350 vezes menos operações computacionais.
Conclusão: a qualidade da análise ao nível do caso não tem de aumentar juntamente com o custo computacional. Uma representação multimagnificação compacta oferece uma referência prática.
Ajuste fino para tarefas específicas
O ajuste fino end-to-end melhorou os resultados da WILSON nas tarefas de:
- subtipagem do cancro da mama;
- graduação dos linfócitos estromais.
Critério prático: para uma tarefa específica, vale a pena considerar o ajuste fino end-to-end. O modelo de base, sem ajuste fino, realiza análises ao nível do caso, e o ajuste fino melhora o desempenho em tarefas específicas.
Pesquisa e geração de texto diagnóstico
Na recuperação imagem-texto, a WILSON superou a PRISM em recall@1. O resultado foi 75.6% contra 58.1%.
| Métrica | WILSON | PRISM |
|---|---|---|
| recall@1 | 75.6% | 58.1% |
As descrições diagnósticas da WILSON receberam avaliações mais elevadas de cinco patologistas com certificação board. Os modelos concorrentes receberam avaliações inferiores.
Critério prático: para a pesquisa e a preparação de relatórios, são importantes duas capacidades — recuperação e geração de texto. Estas são avaliadas em tarefas próximas do fluxo de trabalho.
O que isto significa para a escolha do modelo
Os autores concluem que as representações multimagnificação compactas podem servir de base a modelos fundacionais computacionalmente eficientes e orientados para a prática clínica. Para uma escolha prática, isto implica várias verificações.
Critérios:
- o modelo aceita várias lâminas;
- o modelo combina diferentes ampliações;
- a análise é feita ao nível do paciente;
- a qualidade é medida em tarefas ao nível do caso;
- as operações computacionais são contabilizadas;
- a recuperação e a geração de texto são avaliadas separadamente.
Conclusão: uma única lâmina «best» e a agregação de milhares de fragmentos não abrangem o contexto do paciente. A escolha do modelo depende de como este reúne esse contexto e dos recursos computacionais que exige.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Diagnóstico passo a passo de agentes GUI na análise de dashboards: benchmark DashAct
Apresentamos o DashAct — um benchmark com 348 trajetórias verificadas por humanos, que divide o trabalho de agentes GUI com painéis interativos em três etapas e quatro condições visuais. Os resultados revelam problemas persistentes na previsão de ações e na associação a alvos visuais, bem como a dependência das respostas dos agentes do suporte contextual e espacial.
11 novembro 2026
Invariantes polinomiais canónicos no diagnóstico de falhas em simuladores de RL: onde são realmente úteis
O estudo avalia se a incorporação de leis físicas em modelos de dinâmica treináveis se justifica: os invariantes extraídos das trajetórias e reduzidos à forma canónica por meio de bases de Gröbner proporcionam ganhos modestos nas previsões, mas são eficazes no diagnóstico — permitem localizar a restrição violada e identificar o parâmetro específico incorreto.
10 novembro 2026
AURA-Eval: como verificar se o agente de LLM reconheceu o risco e mudou o próximo passo
O framework avalia o comportamento de agentes LLM não pelo veredito final, mas pela reação ao risco em pontos-chave: as trajetórias de chamadas a ferramentas são interrompidas, após o que o modelo deve continuar o raciocínio e a ação, enquanto um painel de juízes LLM analisa a detecção de riscos, a natureza e a segurança da ação. Em 1.249 tarefas reunidas a partir de 157 trajetórias do R-Judge, as ações inseguras tornam-se mais frequentes entre 20 modelos quando não há um caminho seguro, e a remoção da supervisão antes da execução transforma 52,3% dos casos inicialmente seguros em casos inseguros.
10 novembro 2026