Um backdoor vem do pipeline, não do usuário
Modelos multimodais estão cada vez mais integrados a cenários aplicados: leem capturas de tela, analisam fotos de produtos, respondem a perguntas sobre digitalizações de documentos. Junto com a conveniência, uma vulnerabilidade alheia também migra para o produto. O modelo é montado a partir de componentes prontos — um codificador visual, uma projeção, a parte linguística — e, em cada etapa da montagem, um gatilho oculto pode se infiltrar ali. Às vezes ele está escondido na imagem, às vezes no texto, e às vezes exige a combinação dos dois sinais.
Aí começa o problema. Ferramentas que se saíam bem com classificadores "envenenados" perdem bastante rendimento em modelos multimodais: camadas demais, modalidades muito distintas, geometria interna das representações complexa demais. E as soluções criadas especificamente para MLLMs, na maioria das vezes, atuam na entrada — descartam requisições suspeitas antes mesmo de chegarem à rede. O filtro pode deter um ataque específico, mas a infecção em si permanece nos pesos. Contornar o filtro é uma questão de engenhosidade do atacante.
Inconsistência camada a camada como impressão digital do ataque
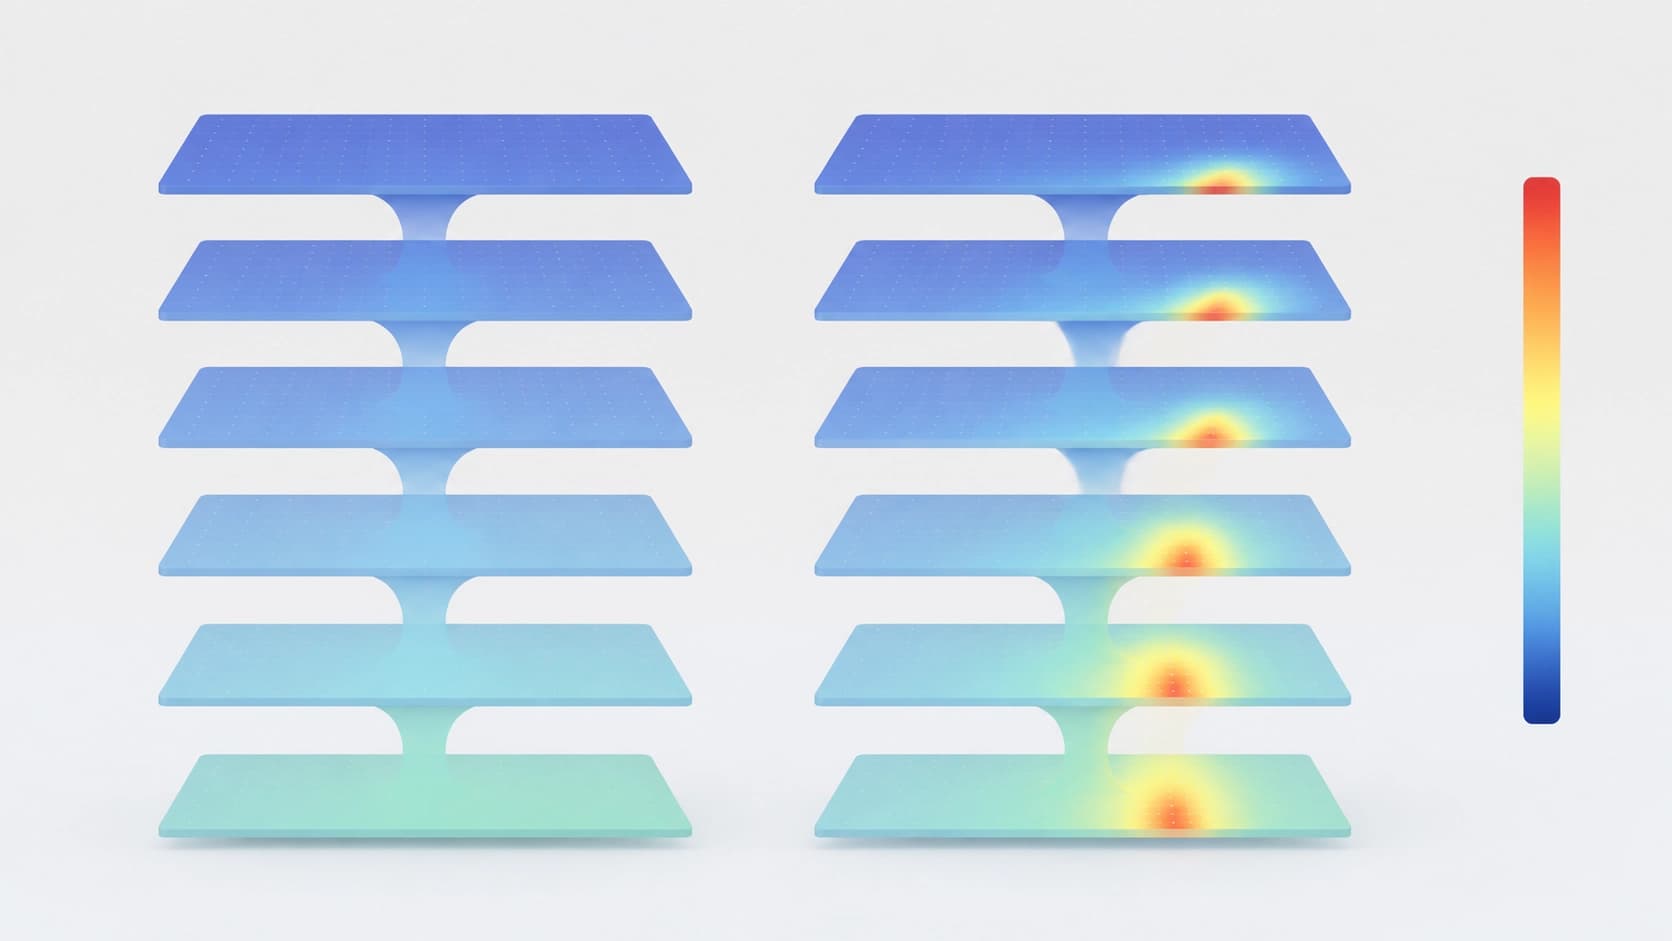
Os autores do trabalho arXiv:2608.24354 (Jiali Wei e mais oito coautores; categorias cs.CR, cs.AI, cs.CL, submissão em agosto de 2026) chamaram a atenção para algo fácil de ignorar quando se olha apenas para a entrada e a saída. O backdoor deixa rastro não em uma única camada, mas na trajetória: as representações, ao passar de camada em camada, mudam de forma atípica. Isso foi chamado de anomalia de inconsistência camada a camada.
O detalhe crucial é que a anomalia não está espalhada uniformemente por toda a rede. Ela está atrelada à modalidade e, mais importante, localizada na região de tokens onde reside o indício do gatilho. Em outras palavras, o modelo "se apoia" em um trecho estreito da representação, e é justamente ali que surge um desvio que não ocorre em dados limpos.
Daí a conclusão prática: se a inconsistência for calculada como média sobre toda a representação, o sinal se dilui no ruído dos atributos úteis. É preciso primeiro separar o que o modelo já misturou.
Como o RACER é estruturado
Separação por modalidades
O framework de recuperação no nível do modelo — e não uma camada sobre a inferência — recebeu o nome de RACER (Region-Aware Consistency Repair). A lógica é a seguinte: a representação fundida é decomposta de volta nas regiões de tokens visual e textual, a inconsistência camada a camada é calculada para cada uma separadamente e, em seguida, tudo é remontado, mas já com pesos que levam em conta a modalidade. O trabalho ocorre na janela das camadas profundas — onde se formam desvios estáveis e direcionais.
O resultado é uma função objetivo ciente das regiões. Ela é mais sensível a anomalias locais do que uma métrica global sobre todo o vetor e não deixa que atributos úteis abafem o sinal do backdoor.
Min-max em vez de simples ajuste fino
Em seguida entra o esquema adversarial. Por meio da otimização min-max, o framework primeiro busca a pior perturbação — aquela que maximiza a inconsistência detectada — e depois ajusta o modelo para que essa perturbação não o quebre. Em termos simples: eles atacam a si mesmos para fortalecer as direções das representações nas quais se sustenta o comportamento nocivo.
O lado prático é tão importante quanto o técnico. O método precisa de apenas 100 exemplos limpos. Ele não exige conhecer nem o próprio gatilho, nem o rótulo-alvo do ataque, nem sequer se o modelo fornecido está infectado. Isso é fundamental: a defesa não se transforma na tarefa de "adivinhe o ataque".
O que as medições mostraram
Os autores testaram o método em três modelos multimodais abertos, em 36 configurações de backdoor — com gatilhos na imagem, no texto e em ambos os canais ao mesmo tempo. O ASR médio (proporção de casos em que o ataque ainda funciona) foi reduzido a 1,1%, e em 32 das 36 configurações o indicador caiu a zero.
O segundo resultado é igualmente importante, embora se fale menos dele: a utilidade em tarefas limpas se mantém. E isso tanto em modelos infectados quanto em modelos originalmente limpos — ou seja, a recuperação não transforma um modelo funcional em um modelo cauteloso, porém inútil. Esse é o preço típico de métodos agressivos de limpeza, e aqui, pelos dados medidos, foi possível evitá-lo.
O que isso muda na prática
A diferença entre filtrar a entrada e recuperar os pesos não é acadêmica. O filtro vive na infraestrutura ao redor do modelo: precisa ser mantido, atualizado para novos tipos de ataque e, ainda assim, pode ser contornado por outro canal. A correção no nível dos pesos elimina a causa, não o sintoma, e não adiciona latência à inferência.
Há também uma questão mais ampla. Estamos acostumados a avaliar a segurança de um modelo pelas suas respostas em testes, mas o RACER mostra que o sinal informativo está escondido nas representações intermediárias — em como a rede pensa, e não no que ela diz. Se essa abordagem escalar para além das três arquiteturas testadas, os fornecedores de MLLMs passam a ter um passo de higiene relativamente barato: uma centena de exemplos limpos e um pouco de computação antes de publicar os pesos. As limitações também são claras — o trabalho analisa uma classe específica de ataques e exige acesso às entranhas do modelo, portanto, para modelos de API fechados, o esquema não é diretamente aplicável.