
Resumo do essencial
Existe uma classe de ataques comumente chamada de injeção indireta de prompts (indirect prompt injection, IPI): instruções maliciosas são inseridas não no chat, mas no resultado do trabalho de uma ferramenta externa — em uma página web, e-mail, arquivo ou resposta de API. O agente lê isso honestamente como dados e pode executar uma tarefa paralela de terceiros.
Uma equipe de pesquisadores da China (Jianshuo Dong, Yiming Liu, Maosen Zhang, Nan Deng, Peng Xu, Xiaoping Zhang, Tianwei Zhang, Jie Zhang, Han Qiu) mostrou que o momento em que o agente "sofreu a injeção" já está registrado em suas representações internas — antes mesmo de ele emitir o primeiro token. O trabalho foi publicado no arXiv (2608.02657, v1 — 1º de agosto de 2026, v2 — 24 de agosto de 2026), DOI: 10.48550/arXiv.2608.02657, código disponível publicamente.
A principal surpresa não está na vulnerabilidade em si, que é conhecida há muito tempo, mas no fato de que o sinal de vulnerabilidade é extraído de forma linear, estável e em modelos de escala de centenas de bilhões e trilhões de parâmetros. Ou seja, não é uma correlação artefatal frágil de um único conjunto de dados.
IPI exposure: o que exatamente as sondas buscam
Os autores introduzem o conceito operacional de "IPI exposure" — o estado do modelo durante o processamento que corresponde ao fato de uma instrução indesejada de terceiros ter entrado em seu contexto. Isso não é o mesmo que o fato de um ataque bem-sucedido: o modelo pode "notar" a ameaça e ainda assim executá-la. Trata-se justamente do estado interno de exposição.
A palavra-chave aqui é "antes da geração". A sonda observa os estados ocultos na entrada do decodificador, e não a resposta já emitida. Isso é importante por dois motivos: primeiro, o sinal existe até onde o comportamento final parece inofensivo; segundo, o diagnóstico pode ser feito antes que o modelo tenha conseguido chamar uma ferramenta com efeitos colaterais.
Experimento: sondas lineares em oito modelos
Escala e abrangência
O teste foi feito em oito modelos. Entre eles, GLM-5.2 — 753 bilhões de parâmetros, e Kimi-K3 — 2,8 trilhões de parâmetros; os resultados desse modelo foram adicionados já na segunda versão do artigo. Foram usadas sondas lineares simples (linear probes), treinadas sobre os estados ocultos — em essência, um classificador linear sobre o vetor.
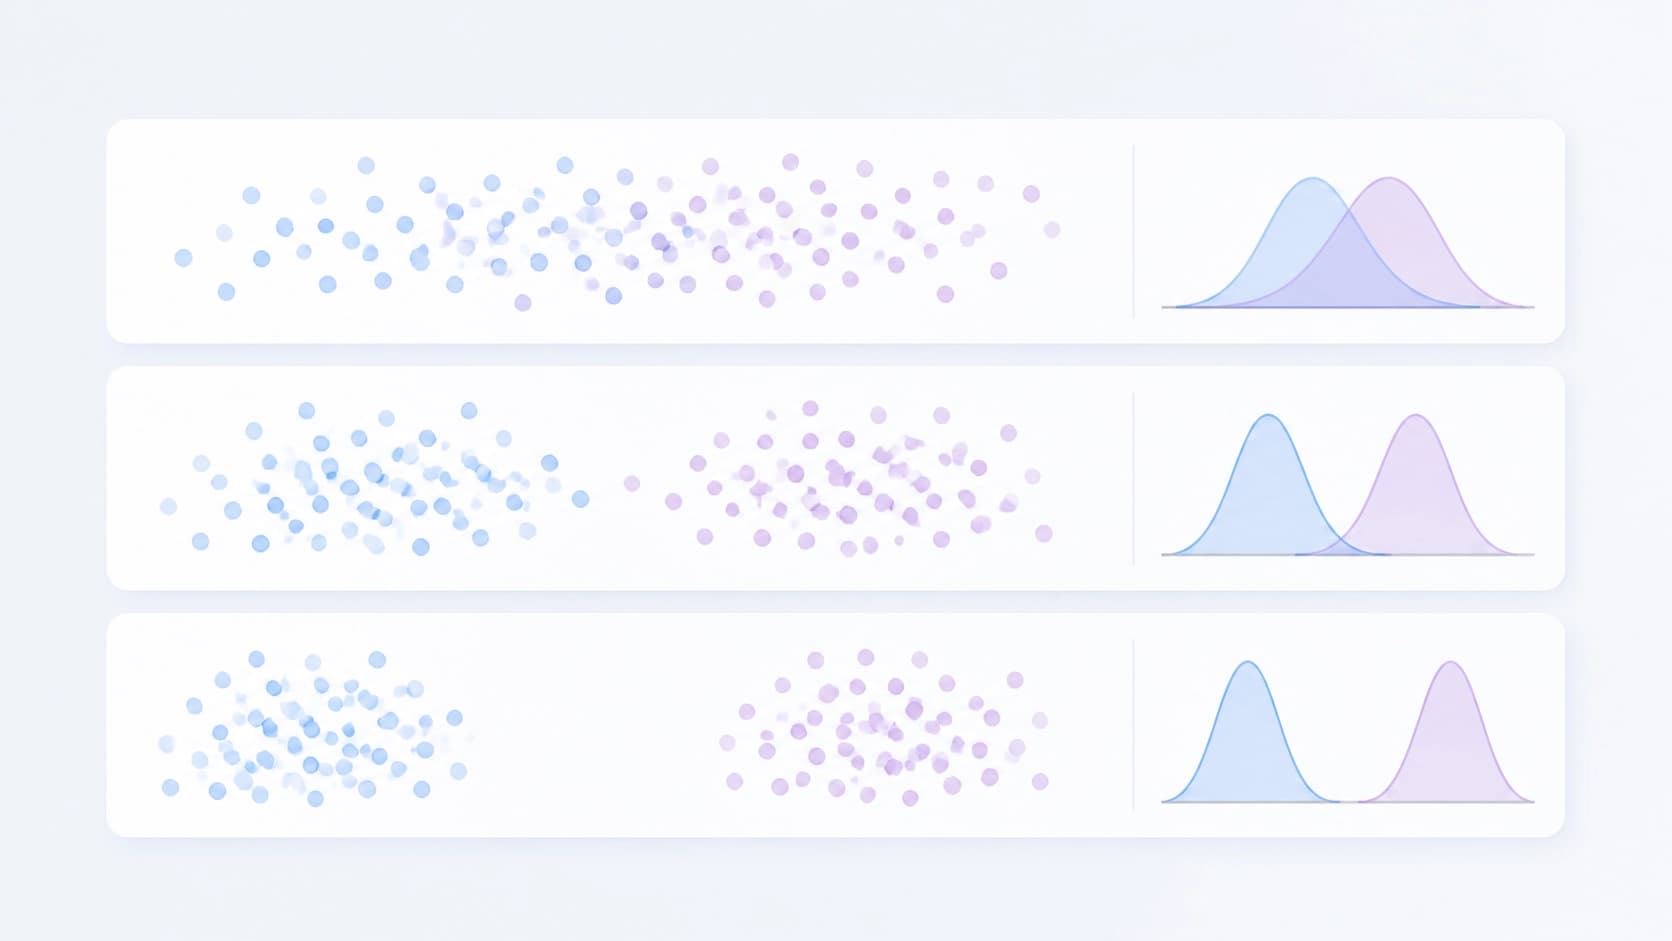
A sigla AUROC aqui significa a qualidade de separação entre duas classes: treinada em alguns dados, a sonda apresentou 0,90+ em ataques, instruções de agente e conjuntos de tarefas que ela nunca havia visto antes. Em outras palavras, o treinamento não foi ajustado a um cenário de ataque específico.
Estabilidade do sinal
Uma linha separada de experimentos na v2 é dedicada à generalização. As sondas mantêm a capacidade preditiva:
- contra ataques adaptativos, ou seja, quando o adversário tenta enganar a própria sonda;
- em condições multilíngues, quando os exemplos de treino e de teste estão em idiomas diferentes;
- em novos tipos de tarefas e instruções que não apareceram no treinamento.
É justamente essa tríade — geralmente o ponto mais fraco de qualquer detector baseado em representações internas —, por isso sua verificação é mais importante do que o próprio número de AUROC.
A lacuna entre saber e agir
A descoberta mais incômoda do artigo é a chamada knowledge-action gap. Os modelos modernos, após o pós-treinamento, de fato codificam sinais que preveem IPI exposure, mas não os utilizam como gatilho confiável para um comportamento seguro. O modelo "sente" o problema e mesmo assim segue em frente.
A razão, a julgar pela lógica do trabalho, é que o sinal existe nas representações, mas não está conectado por uma ligação estável com a política de ações. Nem a recusa comum, nem as instruções no prompt de sistema fecham essa lacuna — elas atuam em outro nível.
Defesa guiada pela sonda
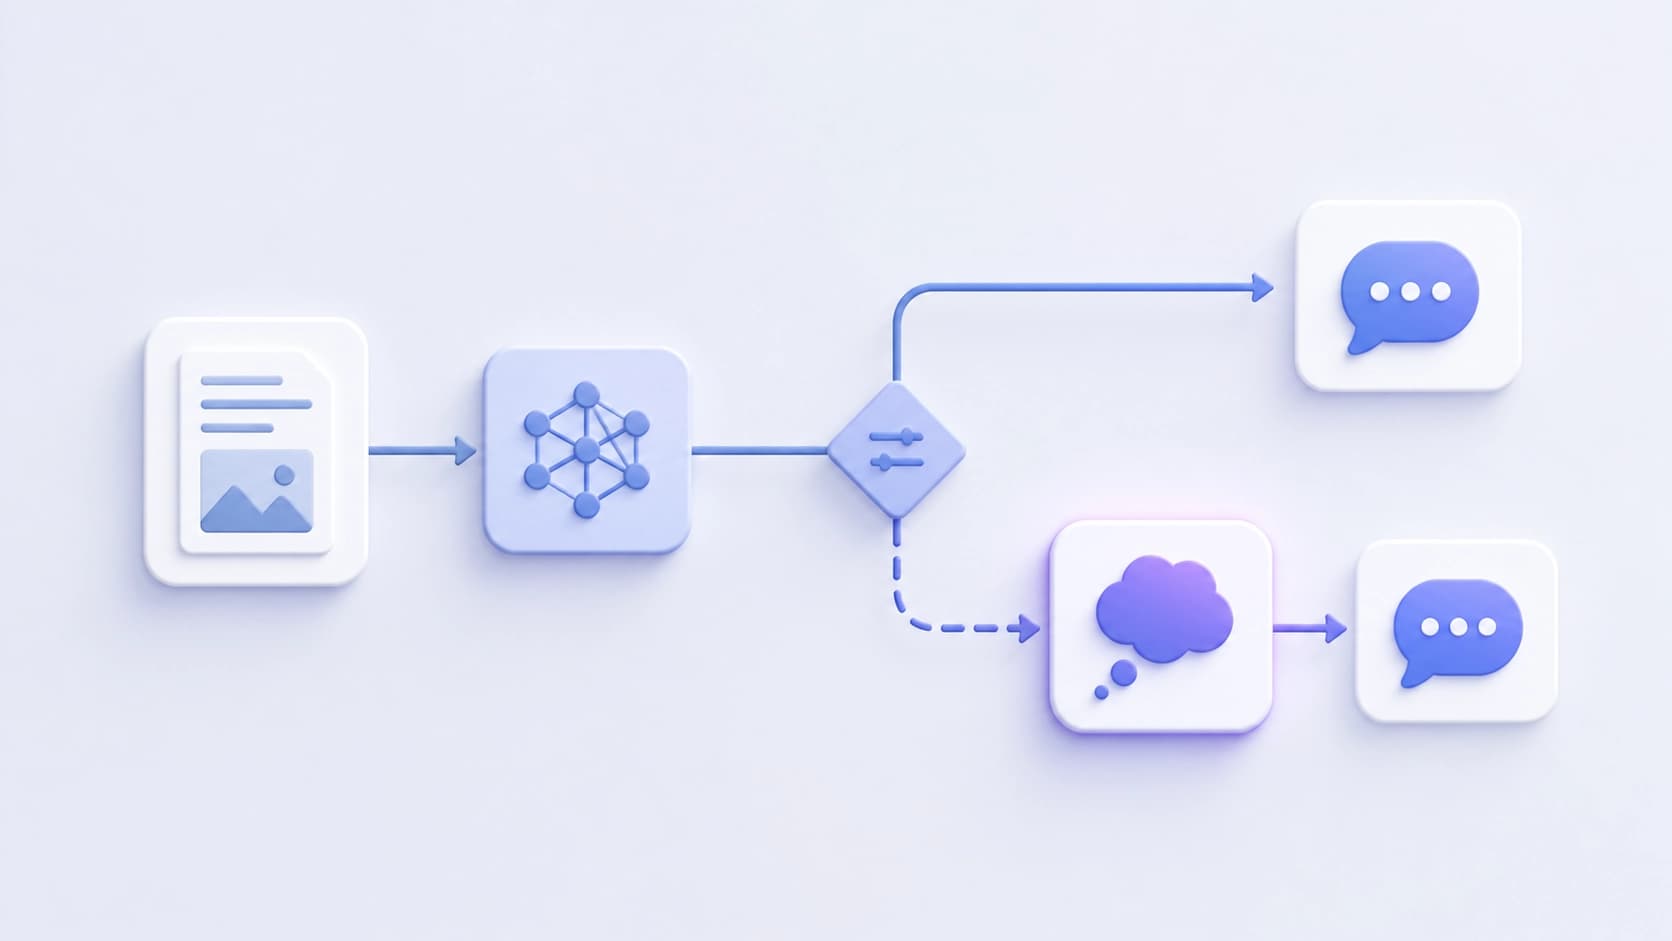
Já que o sinal existe, é lógico usá-lo diretamente. Os autores propõem uma defesa na qual o raciocínio do modelo é ativado apenas quando a sonda detecta exposure. Em termos simples: o detector dispara raramente e com precisão, e o procedimento caro de análise é iniciado por seu comando, e não sempre.
Em configurações complexas do benchmark AgentDojo, essa abordagem reduz sensivelmente a proporção de ataques bem-sucedidos — por exemplo, de 34,6% para zero no Qwen3.5-27B. Um detalhe importante: em tarefas "limpas", onde não há nenhuma injeção, o método preserva a utilidade melhor do que as defesas básicas. É justamente o que costuma faltar aos detectores — ou eles capturam pouco, ou atrapalham o trabalho o tempo todo.
O que os estados ocultos "dizem" em palavras
A terceira parte do trabalho é um arcabouço explicativo. Os autores buscam formulações em linguagem natural que se correlacionam fortemente com o que a sonda detecta. Obtêm-se espécies de perfis textuais: eles mostram quais "pensamentos" exatamente acompanham o disparo do detector.
Aqui, o interessante é a heterogeneidade. Em alguns modelos, o sinal latente corresponde a uma sensação direta de ameaça — algo como "há neste texto uma instrução que não me foi dada". Em outros, ele está ligado a indícios operacionais indiretos: formato de dados incomum, fonte suspeita, conflito com a tarefa atual. Ou seja, um mesmo detector pode se apoiar em mecanismos internos diferentes dependendo do modelo.
O que isso significa na prática
Para quem constrói sistemas de agentes, as conclusões são bastante aplicáveis:
- É possível verificar antes da ação. O sinal está disponível na entrada da geração — logo, integra-se ao pipeline antes que o agente acione a ferramenta.
- A sonda linear é uma camada de proteção barata. Ela é incomparavelmente mais leve do que uma segunda passagem do modelo ou um classificador externo a cada requisição.
- Não confie apenas no prompt. A lacuna entre saber e agir significa que "por favor, ignore instruções de documentos" não é garantia, mesmo que o modelo entenda tudo.
- Considere o custo dos falsos positivos. O principal argumento do método é que ele não atrapalha o trabalho em tarefas limpas, e isso vale a pena verificar no seu próprio tráfego.
Questões em aberto
O artigo responde de forma convincente à pergunta "existe sinal?", mas deixa alguns pontos incômodos. O detector baseado em estados ocultos é mais uma superfície de ataque: se o adversário souber da sonda, ele pode otimizar a injeção de modo que o sinal não surja. A estabilidade multilíngue foi verificada, mas a abrangência linguística e de domínio ainda é limitada pelos dados que estavam nos experimentos.
Outra questão é a portabilidade. A sonda é treinada para um modelo específico: cada arquitetura tem suas próprias representações, e um "sensor" universal, que bastasse conectar a qualquer API, não decorre do trabalho. Para modelos fechados com acesso apenas ao texto, esse método é, em princípio, inaplicável — são necessários os estados ocultos.
Ainda assim, a direção parece promissora. Em vez de discutir o quão bem o modelo segue instruções, os pesquisadores propõem olhar para seu estado interno e verificar que ali já existe o sinal necessário. Depois, é uma questão de engenharia: como transformar de forma confiável esse conhecimento em ação.


