
Ajuste fino de modelos generativos de imagens: consideração conjunta de preferências e rubricas
O artigo descreve um método de pós-treinamento de modelos text-to-image em domínio aberto, no qual o sinal das preferências humanas é complementado por verificações baseadas em rubricas de conformidade com o prompt e de propriedades desejadas. Os resultados mostram que a média ponderada das recompensas tem desempenho inferior ao esquema proposto e que, no snapshot do Arena, os modelos Flux2dev e Ideogram-4 pós-treinados apresentam um aumento expressivo no Elo.
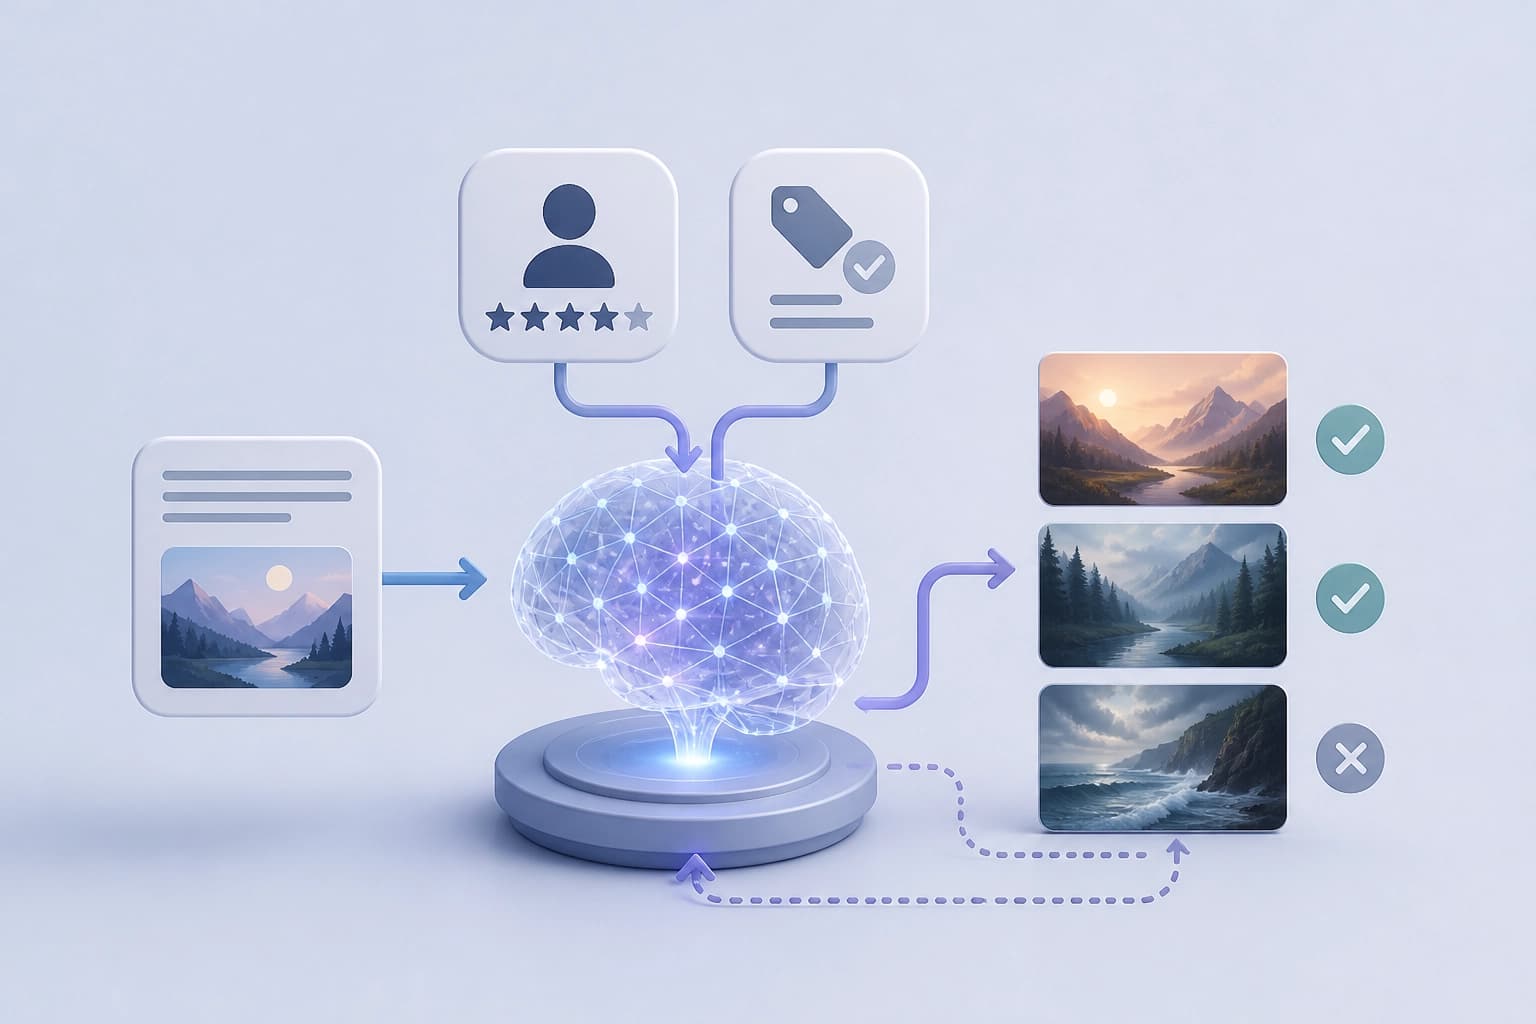
Tarefa: domínio aberto e dois sinais
A geração de imagens a partir de texto em domínio aberto exige ter em conta diferentes requisitos. Entre eles estão a correspondência com o prompt e as preferências humanas. Um único sinal de recompensa não abrange os dois tipos de requisitos. O trabalho «Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards» propõe o pós-treino com uma combinação de sinais complementares.
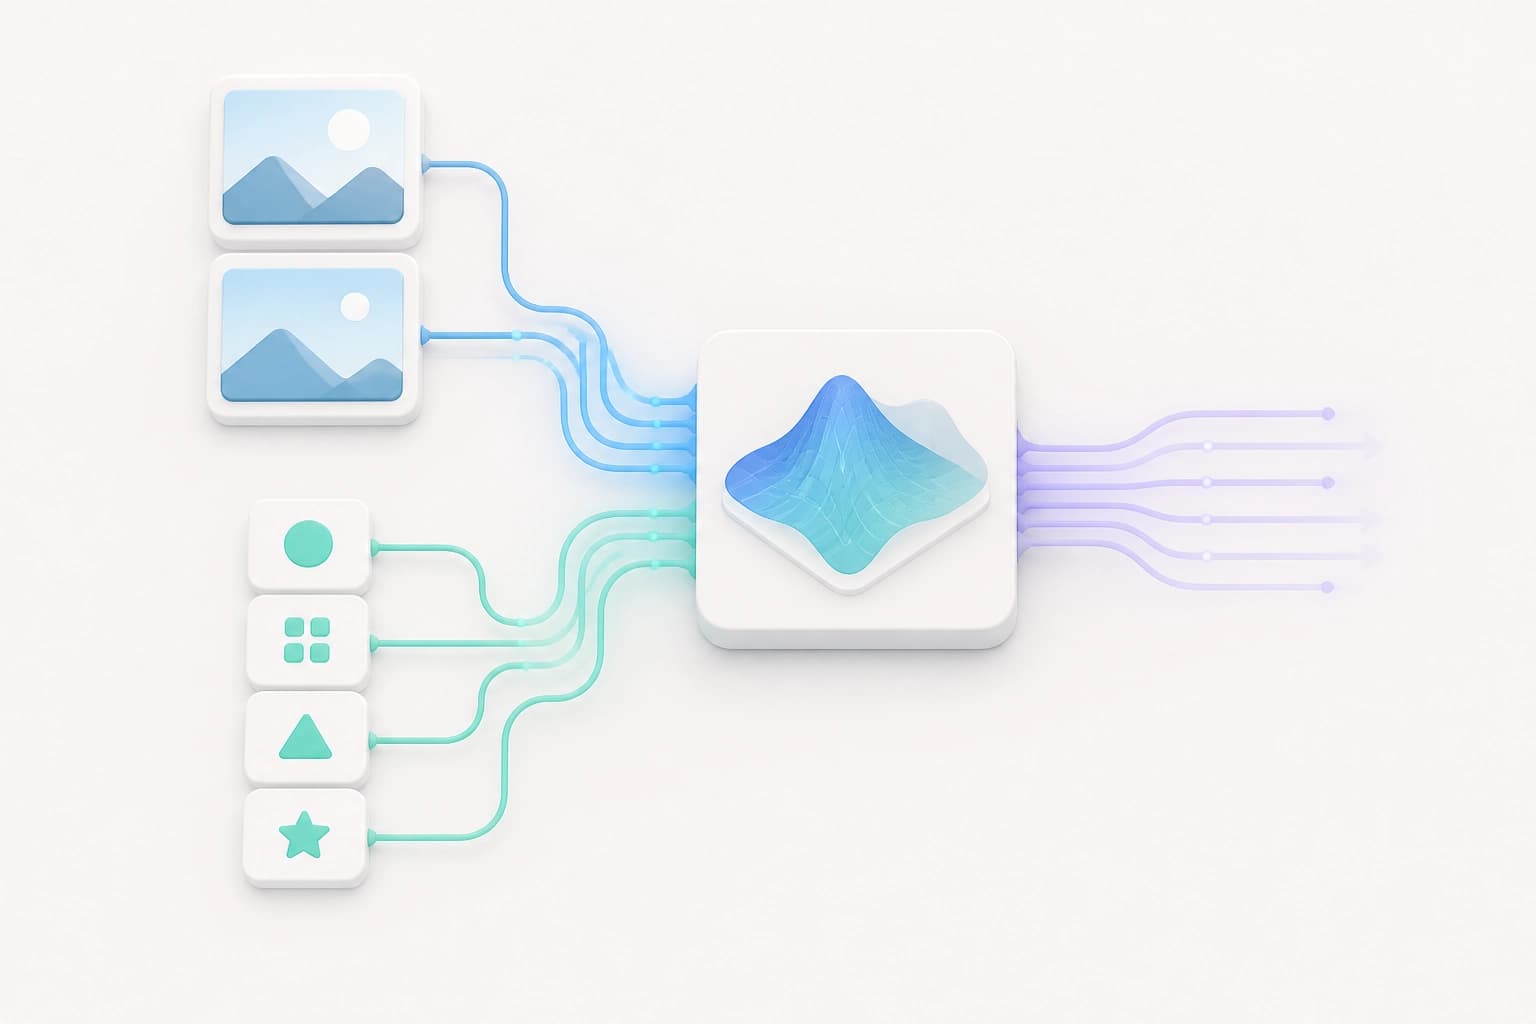
O método combina a recompensa por preferências e as recompensas baseadas em rubricas. O primeiro sinal reflete as preferências humanas. O segundo verifica a correspondência com o prompt e outras propriedades desejáveis. A combinação abrange diferentes aspetos do pedido. Conclusão: em domínio aberto, o critério de seleção é a presença de sinais complementares, e não de apenas um. Devem abranger tanto a escolha subjetiva como a execução da tarefa.
Estrutura do sistema de recompensas
O sistema inclui dois componentes principais. A recompensa por preferências é treinada com dados de preferências humanas em larga escala. Para o treino, é utilizada a função objetivo Bradley-Terry. Este sinal reflete as escolhas das pessoas.
As rubricas avaliam a correspondência com o prompt e outras propriedades desejáveis. Também oferecem proteção contra reward hacking. Os componentes desempenham funções diferentes e complementam-se.
| Componente | Em que se baseia | O que verifica | Função |
|---|---|---|---|
| Recompensa por preferências | Dados de preferências humanas em larga escala, função objetivo Bradley-Terry | Escolhas das pessoas ao comparar resultados | Otimização das preferências |
| Recompensas baseadas em rubricas | Rubricas com critérios | Correspondência com o prompt e outras propriedades desejáveis | Proteção contra reward hacking |
Os autores definem os requisitos para recompensas eficazes. Devem abranger amplamente as intenções dos utilizadores. Devem ser resistentes à exploração durante a otimização.
Conclusão: o critério de seleção é que as rubricas complementem as preferências, em vez de as substituírem. Um sistema sem rubricas perde a proteção contra reward hacking. Um sistema sem preferências não se baseia nas escolhas humanas.
Combinar em vez de calcular uma média simples
Os autores referem um problema com a média ponderada ingénua. Durante a otimização, esta média conduz a um comportamento não ideal. O trabalho propõe uma estratégia de combinação de recompensas. Esta equilibra de forma mais eficaz a otimização das preferências e o cumprimento das rubricas.
| Abordagem | O que acontece durante a otimização |
|---|---|
| Média ponderada ingénua | O comportamento torna-se não ideal |
| Estratégia de combinação | A otimização das preferências e o cumprimento das rubricas ficam mais bem equilibrados |
A estratégia de combinação passa a ser uma parte independente do método. Conclusão: o critério de seleção é a existência de uma estratégia de combinação, e não apenas de um conjunto de recompensas. Os pesos dos sinais, sem uma estratégia, não garantem o comportamento pretendido.
Resultados no ranking Arena text-to-image
No ranking Arena text-to-image, o modelo Flux2dev obteve um Elo 69 pontos acima do modelo de base. O modelo foi submetido a treino por RL. Após o pós-treino, o modelo Ideogram-4 superou todos os modelos de código aberto. O seu Elo foi de 1223.5.
Estes dados mostram o efeito do pós-treino no âmbito do ranking. Não descrevem outros cenários de utilização.
| Modelo | Resultado | Comparação |
|---|---|---|
| RL-trained Flux2dev | Elo 69 pontos acima | Modelo de base |
| Post-trained Ideogram-4 | Elo de 1223.5 | Todos os modelos de código aberto |
Conclusão: o critério de avaliação é considerar o modelo de base e as condições de treino. Para Flux2dev, os autores apresentam o aumento em relação ao modelo de base. Para Ideogram-4, indicam a posição entre os modelos abertos.
Limitações do instantâneo do ranking e dos dados
As afirmações sobre resultados de ponta dizem respeito ao instantâneo do Arena de 4 de setembro de 2026. O instantâneo regista o estado do ranking nessa data. Os autores lançaram o Arena-T2I-Training. Trata-se de um subconjunto de 1K dos dados de treino.
Permite reproduzir parte das melhorias do treino completo. Parte das melhorias não está incluída no subconjunto. Para verificar o método, é importante distinguir o resultado completo da parte reproduzível.
Conclusão: o critério de seleção é ter em conta a data do instantâneo e os limites da reprodutibilidade. Uma afirmação sem estes limites fica incompleta.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Benchmark Zero2Repo: os limites da construção autónoma de um projeto a partir de um diretório vazio
O estudo propõe avaliar agentes de programação numa compilação completa do repositório: a entrada é uma especificação, um contrato de interface e um ambiente vazio; a verificação é feita com testes ocultos, sem um avaliador baseado em LLM. Mesmo os agentes líderes raramente passam em todas as verificações, e a maioria das falhas deve-se a requisitos específicos que não foram cumpridos.
13 novembro 2026
FedSocket: modelos intercambiáveis com executabilidade obrigatória no destinatário perante a heterogeneidade multimodal
É proposto o FedSocket — uma abordagem em que o modelo partilhado tem de poder ser executado no lado do destinatário, enquanto modelos privados heterogéneos são ligados por uma interface comum de previsões Q. O artigo descreve a agregação que tem em conta a pertença, o envio apenas dos parâmetros Q juntamente com os contadores e experiências em seis conjuntos de dados, que demonstram um aumento da precisão quando faltam modalidades e a vantagem da inferência conjunta sobre conjuntos independentes.
13 novembro 2026
CyberArena: confrontos entre agentes de IA revelam os limites dos benchmarks estáticos de cibersegurança
O benchmark coloca dois agentes em ambientes isolados com serviços em constante mudança e, após uma série de rodadas, resume as suas ações em avaliações multidimensionais de competências ofensivas e defensivas. Em 466 partidas com 12 modelos de ponta, distinguiu capacidades onde os testes unilaterais atingem o seu limite, incluindo o planeamento de vários movimentos e a criação de backdoors.
13 novembro 2026