
Liquid AI disponibilizou em código aberto o Pipette: como medir a inferência no dispositivo por completo — da quantização ao hardware
Liquid AI, em parceria com a Artificial Analysis, lançou a plataforma aberta Pipette, onde a unidade de medida não é o modelo em si, mas toda a configuração implantada: pesos, esquema de quantização, runtime e o dispositivo específico. O conjunto inicial conta com mais de mil dessas combinações, mais de trinta modelos e as primeiras medições em smartphones e notebooks com Apple Silicon.
O que foi disponibilizado em código aberto
As discussões sobre "qual modelo é melhor" quase sempre esbarram em um mesmo problema: ninguém verificou os números. As medições são feitas em outra máquina, com outra quantização, em outra build de runtime — e compará-las entre si é inútil. A empresa Liquid AI propôs resolver isso com abertura e reprodutibilidade: lançou o Pipette, uma plataforma para benchmarking de modelos fundamentais em dispositivos edge. A metodologia foi validada de forma independente pela Artificial Analysis.
A ideia central sobre a qual toda a construção se sustenta: o comportamento no dispositivo é uma propriedade do sistema implantado, e não do modelo isolado. Portanto, a unidade de medida também não deve ser o "modelo", mas sim a configuração completa: pesos mais esquema de quantização mais ambiente de execução mais hardware específico. Dessa premissa surge tanto a estrutura do dataset quanto a forma como todas as comparações abaixo devem ser lidas.
O que entrou no dataset inicial
- cinco métricas de desempenho no dispositivo;
- mais de mil configurações na combinação modelo × quantização × ambiente de execução × dispositivo × comprimento de contexto;
- mais de 30 modelos e vários formatos de quantização;
- builds do llama.cpp para macOS, iOS, Windows e Android;
- comprimentos de contexto de 256 a 8.192 tokens.
As primeiras medições publicadas foram feitas em um MacBook Pro com M5 Max, iPhone 17 Pro e Galaxy S26 Ultra. Para o AMD Ryzen AI Max+ 395 e a Radeon 8060S, os resultados ainda estão marcados como "coming soon" — ou seja, a plataforma é anunciada desde o início como multiplataforma, mas a cobertura de hardware ainda está crescendo.
Quatro conclusões dos primeiros testes
Parâmetros iguais — comportamento diferente em contexto longo
Uma boa ilustração de por que essa medição é necessária. Dois modelos de 350M parâmetros com o mesmo Q4_K_M no mesmo telefone se comportam de maneira diferente conforme os tokens de entrada crescem: o Granite-4.0-H-350M mantém 78,4% da taxa de transferência de decodificação ao passar de 256 para 4.096 tokens de entrada, enquanto o Granite-4.0-350M mantém apenas 33,8%. O número de parâmetros aqui não indica nada: a diferença está na arquitetura e em como ela se encaixa no runtime e no chip específicos.
Ativação esparsa economiza computação, mas não memória
O LFM2.5-8B-A1B no mesmo telefone, com 2.048 tokens de entrada, decodifica 2,4 vezes mais rápido que o Qwen3.5-4B e 2,6 vezes mais rápido que o Ministral-3-3B-Instruct-2512. O segredo está na ativação esparsa: para cada token, são usados aproximadamente 1,5B dos 8,5B parâmetros. Mas o consumo de pico de memória é de 5,29 GiB, porque todos os pesos dos especialistas ainda precisam estar inteiramente na memória. Conclusão prática: arquiteturas do tipo MoE ganham em tempo, mas não salvam o orçamento de RAM — e no telefone o limite muitas vezes esbarra justamente na memória.
Mais rápido não significa melhor qualidade
No iPhone 17 Pro com Q4_K_M, o MiniCPM5-1B executa uma carga de 2.048 tokens de entrada / 256 de saída em 3,47 s, enquanto o LFM2.5-1.2B-Instruct leva 4,12 s, ou seja, o primeiro é 15,8% mais rápido. No entanto, nos mesmos artefatos, o LFM obtém 9,0 pontos a mais no MATH-500. Taxa de transferência e qualidade são eixos diferentes, e escolher um modelo por um único número da tabela é inútil.
Perfis de sistema quase idênticos podem esconder uma inversão nas tarefas
No M5 Max com Q4_K_M e 2.048 tokens de entrada, o Granite-4.1-8B e o Ministral-3-8B-Instruct-2512 diferem em apenas 2,4% na taxa de transferência de decodificação e 1,2% na RAM de pico. Mas nas tarefas o quadro muda: o Granite ganha 7,3 pontos no IFBench, enquanto o Ministral o supera em 14,0 pontos no GPQA Diamond. A diferença no perfil de "hardware" está dentro do ruído, a diferença de comportamento é fundamental.
Como as medições são estruturadas
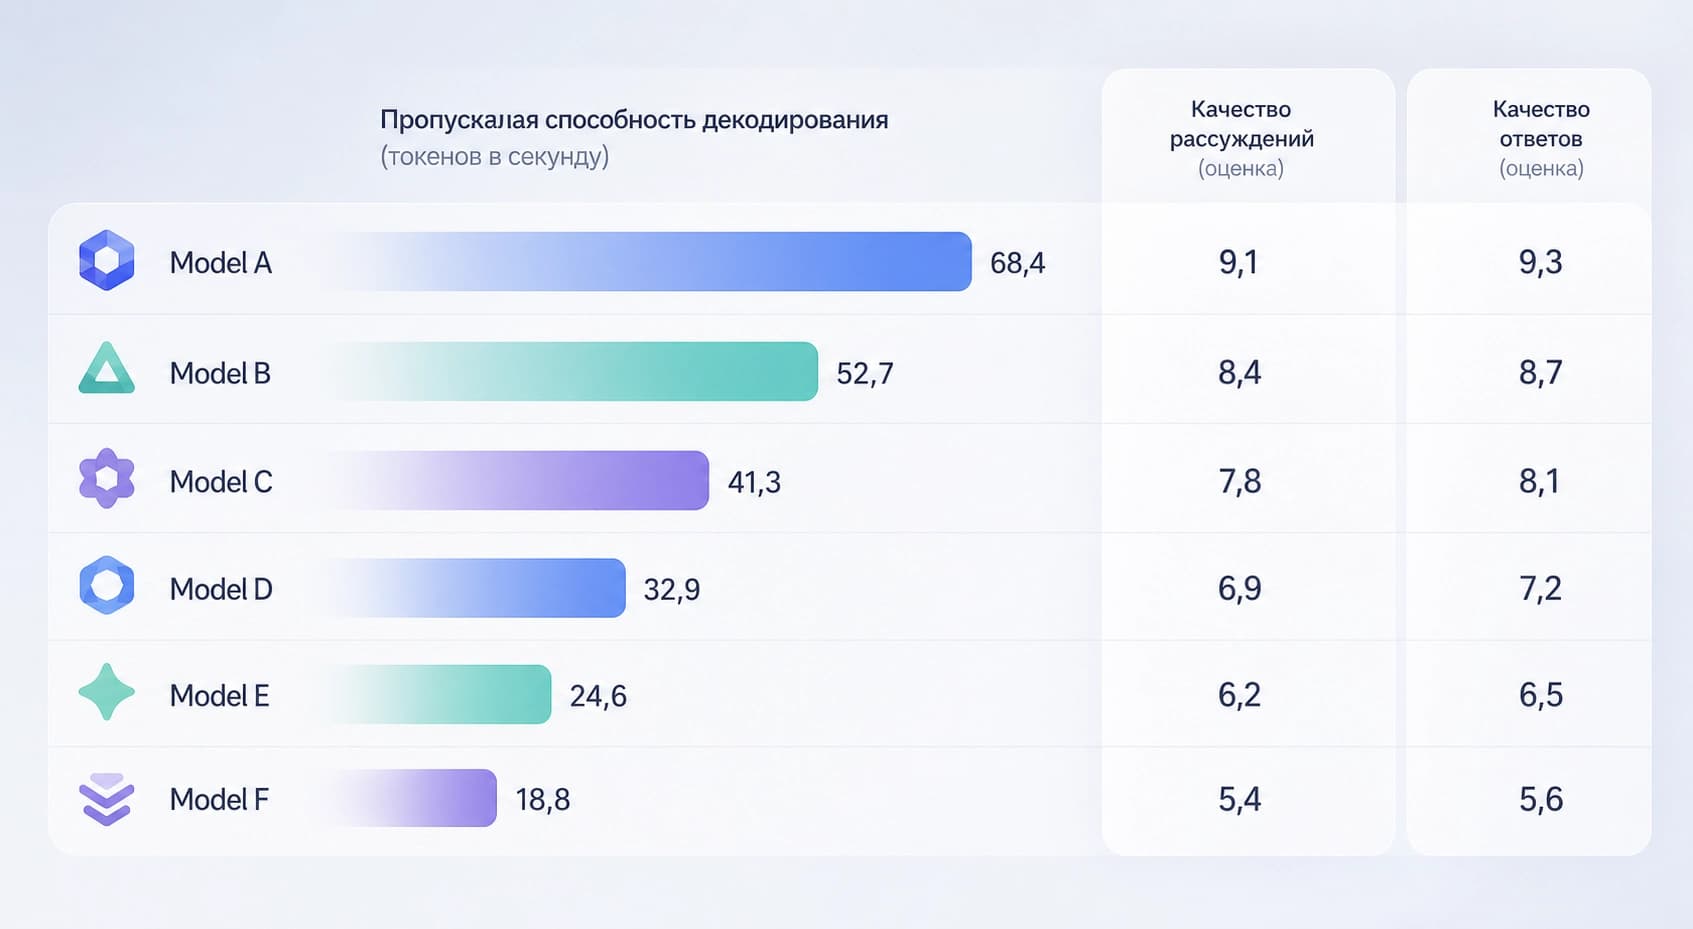
Os testes de desempenho são construídos com formas fixas de tokens, decodificação gulosa, aquecimento descartado e cinco repetições medidas. Antes de cada repetição, entra em ação o readiness gating: uma verificação específica da plataforma garante que as condições térmicas e a carga em segundo plano estejam dentro do normal. Testes reprovados não entram na publicação — é justamente isso que distingue um benchmark reproduzível de um script pontual.
Um capítulo à parte é a qualidade. Ela não é medida no mesmo teste: para isso são usados o IFBench, o GPQA Diamond e o MATH-500, e as pontuações vêm de execuções de avaliação do llama.cpp em sistemas de referência com NVIDIA H100 80GB. Depois, elas são comparadas com as execuções no dispositivo para o mesmo modelo e a mesma quantização. Uma consequência importante: o número de qualidade que aparece ao lado da taxa de transferência do telefone não foi obtido no telefone. É uma métrica útil para comparar modelos entre si, mas não é uma medição do que acontece em um smartphone específico.
O que exatamente é disponibilizado em código aberto
O Pipette é fornecido por completo, sem lista de espera:
- infraestrutura sob Apache 2.0 — os repositórios pipette-mgmt, pipette-clients e pipette-scores;
- dataset público de resultados;
- dashboard hospedado;
- aplicativos nativos de benchmarking para iOS e Android.
A única parte que ainda não está pronta para acesso geral é a publicação de resultados enviados pela comunidade: ela está em beta. Todo o resto pode ser executado de forma autônoma, incluindo a implantação do pipeline dentro do próprio perímetro.
Para quem e por que isso é necessário
A maneira mais simples de descrever o público-alvo é: qualquer equipe que lança um modelo em hardware que ela mesma não controla. A partir daí, as opções se dividem por escala.
- Um desenvolvedor solo e uma startup em estágio seed se contentam com o dashboard e os aplicativos móveis — não é preciso infraestrutura própria.
- Uma equipe de produto de porte médio pode implantar os clientes em um parque interno de dispositivos e obter medições na sua própria configuração.
- Grandes OEMs, fabricantes de chips e empresas podem manter todo o pipeline atrás do firewall — o que elimina dúvidas sobre para onde vão os dados das medições.
As tarefas típicas também são compreensíveis sem maiores explicações: escolher o modelo e o formato de quantização antes que as tarefas do sprint sejam fixadas; justificar a compra de um SoC ou de equipamento; detectar regressões ao atualizar o runtime, o SO ou o driver; planejar capacidade em função do comprimento de contexto; verificar de forma independente as promessas publicitárias dos fornecedores. Os setores — eletrônicos de consumo e OEMs de smartphones, automotivo, indústria e robótica, dispositivos médicos, serviços financeiros, defesa: em todos os lugares onde latência, privacidade ou ausência de conexão obrigam a executar o modelo diretamente no dispositivo.
No que prestar atenção antes de confiar nos números
Três coisas que são fáceis de esquecer ao ler qualquer tabela de medições.
Primeiro, os números de qualidade e os números de desempenho vêm de lugares diferentes. A taxa de transferência é medida no dispositivo, a qualidade é medida em um sistema de referência com H100 e depois comparada. Para comparar modelos, isso é correto; para prever o comportamento em um aplicativo específico, não.
Segundo, a quantização não pode ser deixada de fora. O mesmo formato em modelos diferentes e runtimes diferentes dá resultados diferentes, e a limitação de memória muitas vezes se torna decisiva — como no exemplo da ativação esparsa, em que a velocidade aumentou, mas os 5,29 GiB não desapareceram.
Terceiro, desempenho igual não diz nada sobre como os modelos se sairão em tarefas específicas. A inversão entre Granite e Ministral no IFBench e no GPQA Diamond com perfis de sistema quase idênticos é exatamente o caso em que primeiro é preciso definir a tarefa e só depois olhar as tabelas.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Diagnóstico passo a passo de agentes GUI na análise de dashboards: benchmark DashAct
Apresentamos o DashAct — um benchmark com 348 trajetórias verificadas por humanos, que divide o trabalho de agentes GUI com painéis interativos em três etapas e quatro condições visuais. Os resultados revelam problemas persistentes na previsão de ações e na associação a alvos visuais, bem como a dependência das respostas dos agentes do suporte contextual e espacial.
11 novembro 2026
WILSON: integração de ampliações e lâminas de pacientes para análise anatomopatológica e elaboração de laudos
O preprint apresenta o WILSON — um modelo de visão e linguagem que codifica imagens de lâminas inteiras e séries de preparações de um mesmo paciente em diferentes ampliações, em vez de apenas uma lâmina «melhor». Sem ajuste fino para a tarefa, supera modelos especializados e maiores para lâminas em várias métricas, com uma carga computacional substancialmente menor, e as suas descrições diagnósticas receberam avaliações mais elevadas dos patologistas.
11 novembro 2026
Invariantes polinomiais canónicos no diagnóstico de falhas em simuladores de RL: onde são realmente úteis
O estudo avalia se a incorporação de leis físicas em modelos de dinâmica treináveis se justifica: os invariantes extraídos das trajetórias e reduzidos à forma canónica por meio de bases de Gröbner proporcionam ganhos modestos nas previsões, mas são eficazes no diagnóstico — permitem localizar a restrição violada e identificar o parâmetro específico incorreto.
10 novembro 2026