
Abordagem OWP: redistribuição de evidências e sinais a priori no Omni-LLM
É proposto o framework Omni-Woodpecker, que não requer treinamento, identifica conflitos entre modalidades e, antes da decodificação, ajusta o equilíbrio entre os dados de contexto e os vieses aprendidos nos estados ocultos. Em Qwen2.5-Omni-7B e VideoLLaMA2-AV, o método aumenta a robustez a erros audiovisuais no CMM e no AVHBench, além de proporcionar ganhos moderados em benchmarks gerais de raciocínio.
O que é OWP e que problema resolve
Omni-Woodpecker (OWP) é um framework sem treino para corrigir alucinações intermodais em LLMs Omni. O método transfere a correção do nível dos dados de saída para o rebalanceamento das representações, motivado por conflitos entre modalidades. Os autores submeteram o artigo em 19 de outubro de 2026: Zijian Liu, Chaoyou Fu, Yan Yang, Caifeng Shan, Ran He.
A correção tradicional atua sobre a resposta pronta. OWP intervém nas representações internas antes da descodificação. Isso altera o ponto de intervenção do método.
Conclusão: OWP altera o ponto de correção, em vez de corrigir a resposta pronta.
Etapas de redistribuição de evidências e sinais a priori
OWP realiza o rebalanceamento em várias etapas. Primeiro, o método identifica conflitos intermodais através de representações suplementares de cada modalidade.
- Identificação de conflitos intermodais através de representações suplementares de cada modalidade.
- Decomposição ortogonal dos estados ocultos para separar evidências de grounding de avaliações a priori concorrentes.
- Rebalanceamento adaptativo das representações fundidas: supressão de sinais a priori enganadores e recuperação de evidências ignoradas.
- Envio das representações corrigidas para a descodificação.
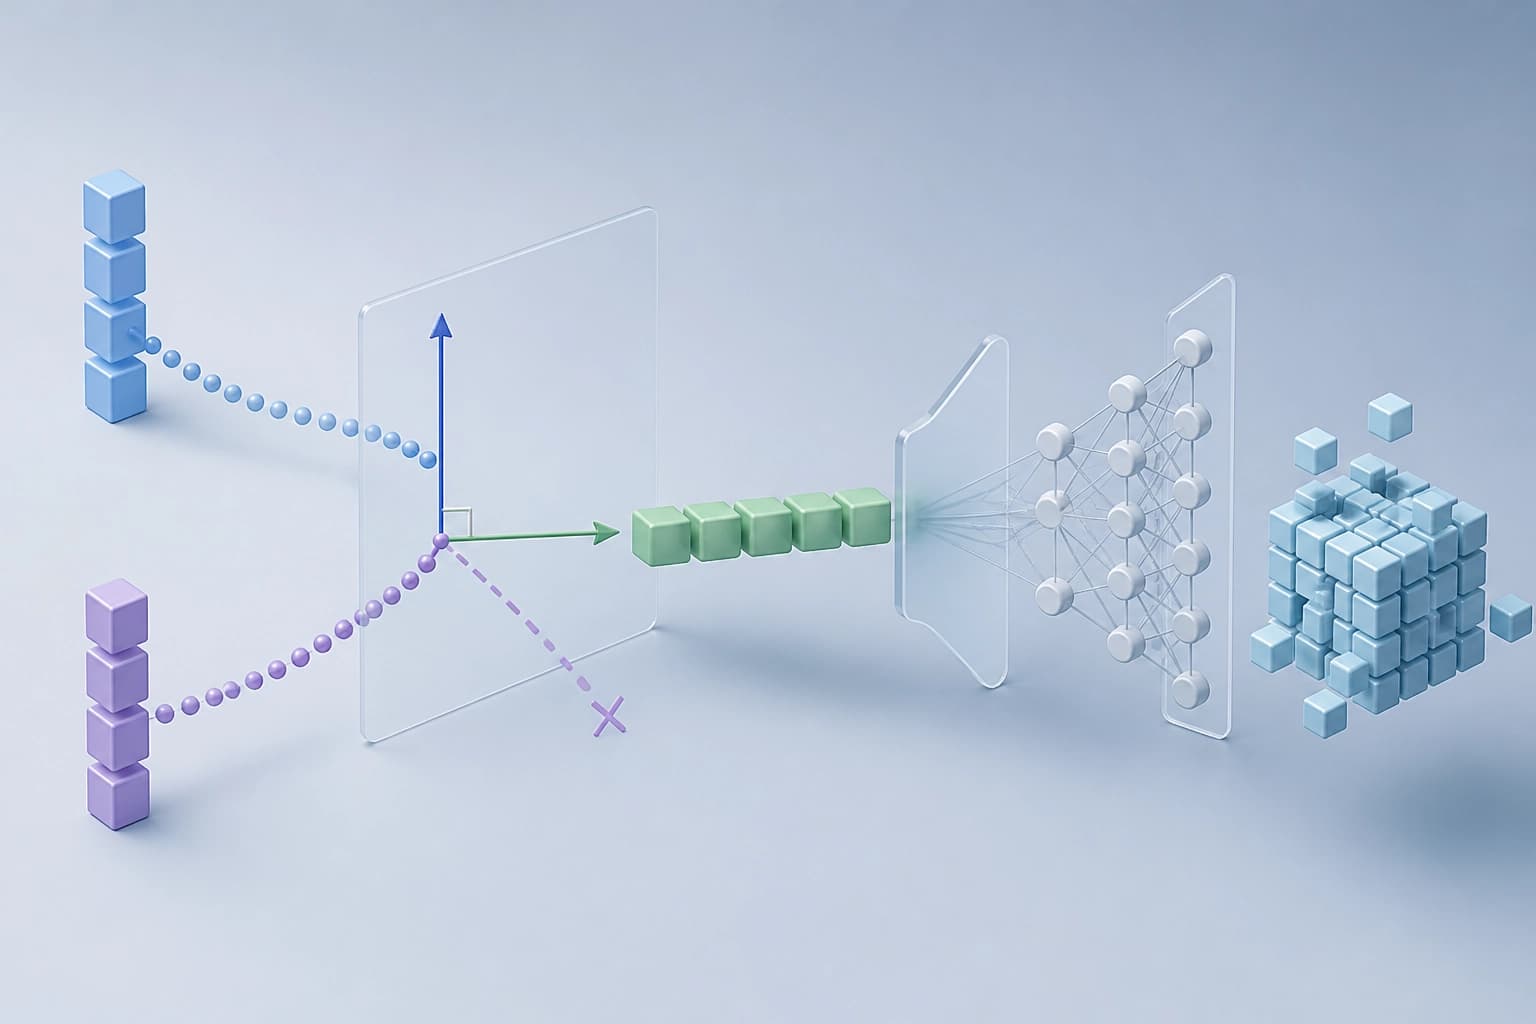
O método não altera os pesos do modelo. Corrige as representações antes da geração.
Conclusão: OWP não requer treino nem alterações aos pesos. Atua sobre os estados ocultos antes da descodificação.
Resultados: ganhos em benchmarks e transferência
No Qwen2.5-Omni-7B, OWP melhora os resultados em 12,9 e 8,6 pontos no CMM e no AVHBench. Nos quatro benchmarks gerais de raciocínio OLLM, o ganho varia entre 0,67 e 2,25 pontos.
| Modelo | CMM | AVHBench |
|---|---|---|
| Qwen2.5-Omni-7B | +12,9 pontos | +8,6 pontos |
| VideoLLaMA2-AV | +4,6 pontos | +3,9 pontos |
O método demonstrou transferência para o VideoLLaMA2-AV: melhoria de 4,6 e 3,9 pontos no CMM e no AVHBench. Os autores relatam eficácia e transferência entre arquiteturas. O código está disponível publicamente.
Conclusão: o ganho depende do modelo e do benchmark. Critério prático: antes da implementação, vale a pena testar OWP na arquitetura e no conjunto de tarefas pretendidos.
Critérios práticos para escolher OWP
OWP é adequado quando se verificam várias condições. O método funciona sem treino e sem alterar os pesos do modelo.
- É necessária a correção de alucinações intermodais sem treino.
- Estão disponíveis estados ocultos e representações de cada modalidade.
- É necessária uma intervenção antes da descodificação, em vez de pós-processamento da resposta.
- É possível reproduzir o método: o código está disponível publicamente.
OWP é uma forma de rebalancear evidências e sinais a priori sem treino. Os autores afirmam que há transferência entre arquiteturas. A validação no modelo específico continua a ser uma etapa obrigatória.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
LightCRS: esquema compacto de recomendação conversacional multidomínio sem uma VLM separada para cada categoria
Os autores apresentam um sistema em que os atributos multimodais dos produtos são calculados offline por encoders congelados e, durante o diálogo, processados por um módulo comum a todos os domínios, com 5,3 milhões de parâmetros e cross-attention condicionada pela consulta. No benchmark de 25 domínios, a abordagem melhora as métricas médias de ranking, reduz significativamente a latência e mostra que o treino conjunto proporciona ganhos em relação a modelos separados para cada domínio.
16 novembro 2026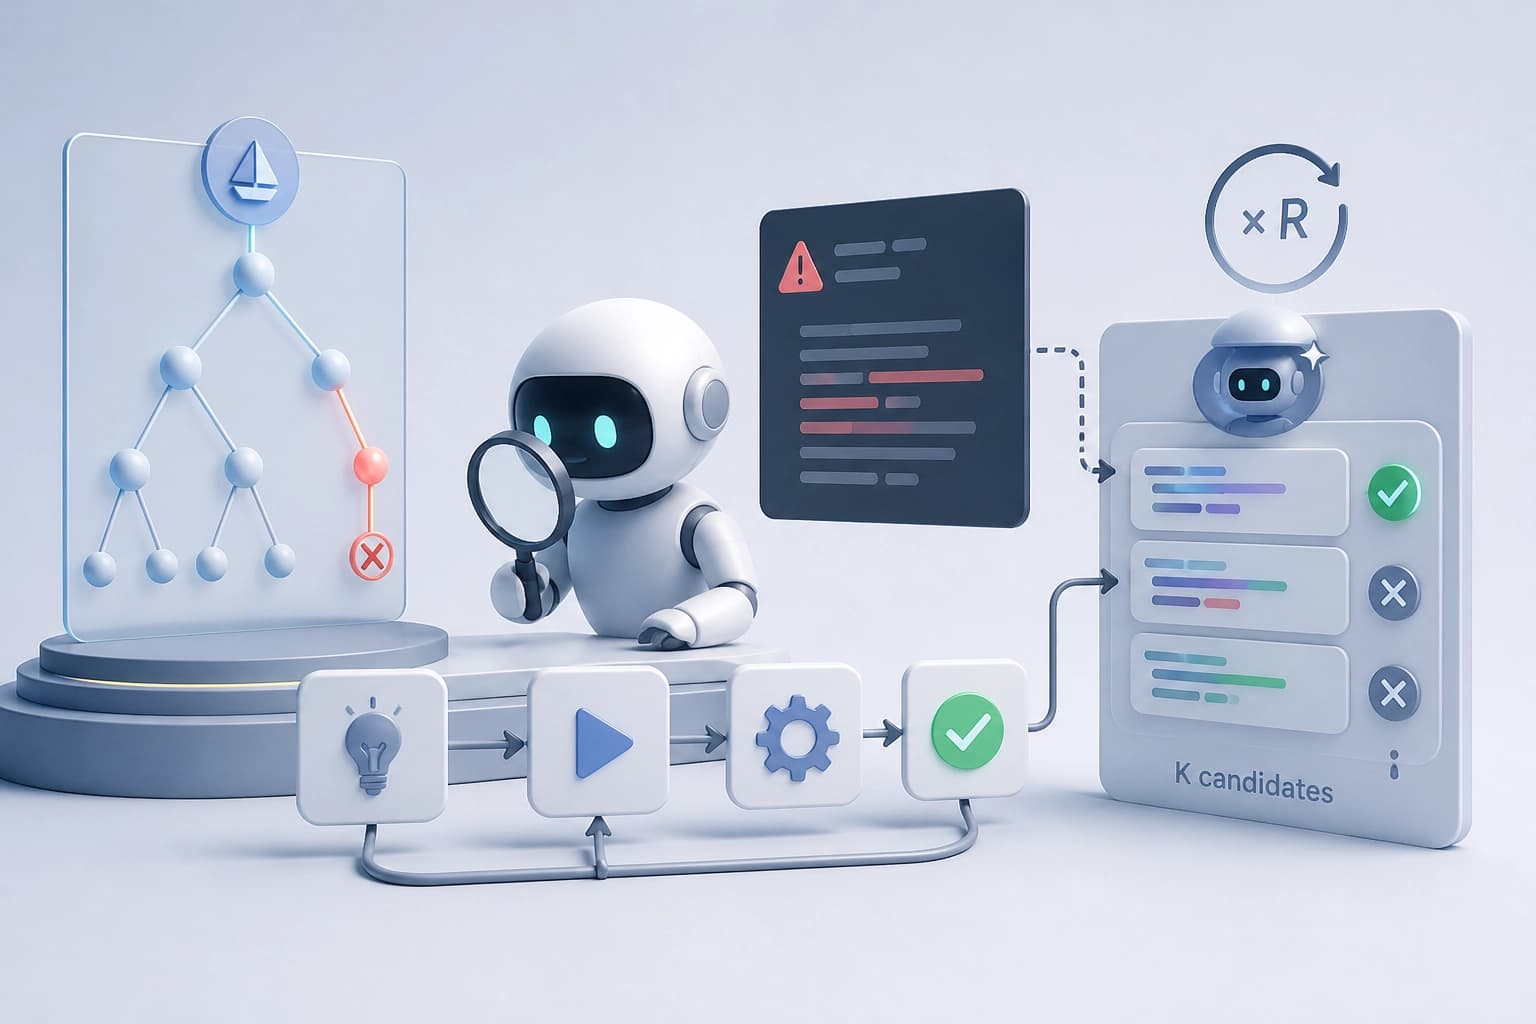
Reparação limitada de táticas em Lean 4 com base no diagnóstico do compilador
É proposto um módulo passo a passo que, em vez de descartar uma tática rejeitada, pede ao modelo de correção que a corrija até R vezes, tendo em conta o erro do Lean; com K candidatos, isso aumenta a proporção de problemas resolvidos. As experiências no LeanDojo e no Lean Workbook mostram ganhos sobretudo graças a falhas de execução pouco profundas, à custa de um aumento do tempo de pesquisa.
16 novembro 2026
Método Genesis Steering: direcionamento de ativações com dados usados no ajuste fino
O método extrai um vetor de controle a partir de exemplos contrastivos presentes nos dados de fine-tuning e, quando estes não estão disponíveis, seleciona prováveis amostras de treino através de inferência de membership e cria um conjunto proxy. A parte teórica descreve o desvio ótimo em direção à fronteira de decisão e a avaliação com dados proxy; empiricamente, os dados internos do Tülu-3-8B produzem um efeito mais acentuado do que os conjuntos externos, enquanto a utilidade do proxy MIA no Llama-3.1-8B-Instruct é limitada pela relação entre os desvios de direção.
16 novembro 2026