
OpenAI promete: seu chip Jalapeño será mais rápido e econômico que as soluções dos concorrentes
A empresa afirma que o processador de inferência desenvolvido com a Broadcom supera os aceleradores da Nvidia em eficiência energética e velocidade de resposta em testes com vários modelos de IA. A implantação dos chips em pequenos volumes está prevista para ainda este ano, mas não há planos de substituir completamente o parque da Nvidia.
A OpenAI aposta no chip Jalapeño: mais rápido, mais econômico e quase à venda
Quando se trata de implantar grandes modelos de linguagem, os engenheiros estão constantemente em busca de um equilíbrio: ou o sistema responde muito rápido, mas tem dificuldade em suportar o fluxo de solicitações, ou é capaz de processar cargas enormes, mas ao custo de atrasos perceptíveis. Na OpenAI, eles acreditam ter encontrado uma solução que elimina essa contradição. O chip proprietário da empresa, chamado Jalapeño, de acordo com os desenvolvedores, demonstra simultaneamente baixa latência e alta taxa de transferência. Segundo o vice-presidente de hardware da OpenAI, Richard Ho, a novidade oferece "o melhor dos dois mundos".
O Jalapeño não é um processador universal, mas um circuito integrado de aplicação específica (ASIC), criado em parceria com a Broadcom. O chip é otimizado para uma tarefa específica — a inferência, ou seja, a execução direta de modelos treinados para realizar tarefas e operar agentes. Anunciado em junho, ele agora recebeu seus primeiros resultados oficiais de testes, que a empresa não hesita em chamar de revolucionários.
O que os testes de desempenho mostraram
Para avaliar as capacidades do chip, a OpenAI usou sua própria plataforma de benchmark, a InferenceX. Como referência para comparação, foram usados os melhores resultados registrados nos superchips Nvidia GB200 e GB300. Os testes foram realizados em três modelos populares: GPT-OSS 120B, DeepSeek R1 e Kimi K2.5 1T.
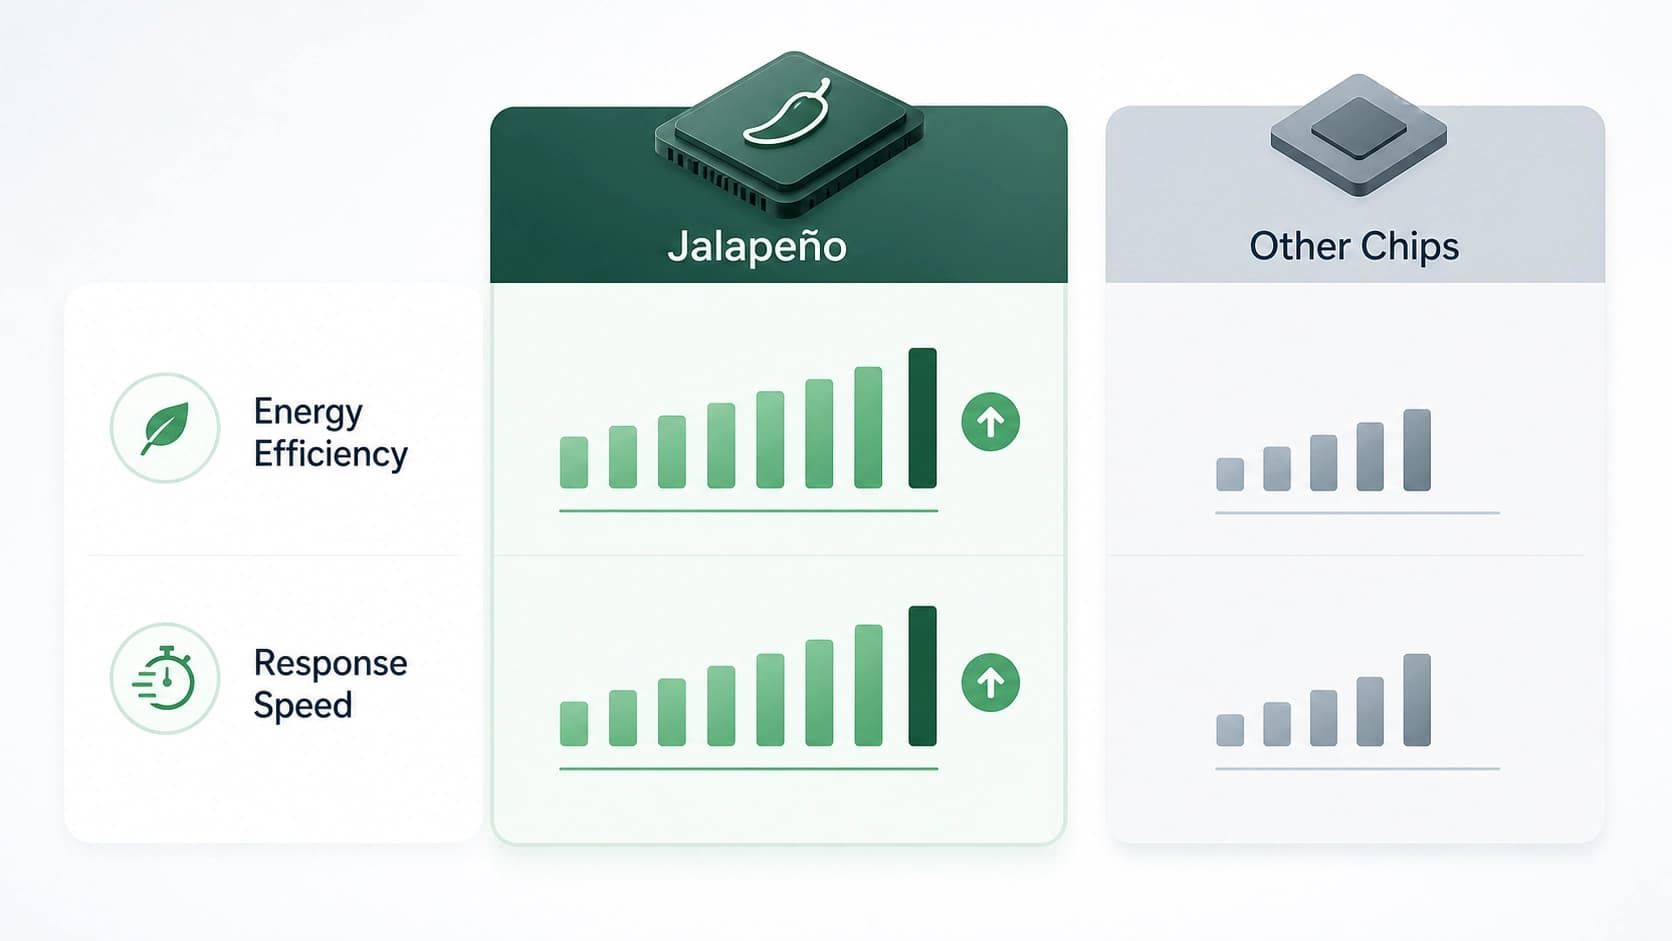
A empresa afirma que os resultados foram impressionantes. Dependendo do modelo, o Jalapeño demonstrou de 1,5 a 1,9 vezes mais cálculos por watt do que os sistemas concorrentes. Em termos simples, isso significa que, para cada quilowatt de energia gasto, o novo chip realiza significativamente mais trabalho útil. Isso é crucial em uma era em que as contas de eletricidade dos data centers se tornam uma das principais despesas.
A diferença na velocidade de resposta é ainda mais notável. A latência de ponta a ponta nos três modelos testados foi de 1,7 a 3,6 vezes menor em comparação com os sistemas de referência baseados em chips da Nvidia. Na prática, isso se traduz em respostas mais rápidas dos assistentes, ações mais ágeis dos agentes de IA e acesso estável aos serviços mesmo sob picos de carga. Quanto mais rápido o modelo processa uma solicitação, menos tempo o usuário passa olhando para o indicador de "digitação" da resposta.
Estratégia: não substituição, mas complemento
Apesar desses números animadores, a OpenAI não pretende abandonar a colaboração com a Nvidia. Richard Ho ressalta que a estratégia computacional geral da empresa envolve o uso de uma ampla gama de parceiros, e a Nvidia continua sendo um dos principais. O Jalapeño não substituirá o parque de chips existente, mas sim se tornará um elemento importante para a expansão da infraestrutura.
A primeira geração do chip está planejada para ser implantada em "pequenos volumes" já até o final deste ano. A expansão em escala total começará em 2027. A empresa deliberadamente não revela o número exato de chips que planeja usar no próximo ano. Enquanto isso, o trabalho já está em andamento na segunda e terceira gerações do Jalapeño, o que indica a longevidade dessa direção — ao contrário de muitos experimentos que nunca chegam ao estágio prático.
O sucesso deste projeto pode reduzir significativamente a dependência dos operadores de grandes modelos de IA em relação a um número limitado de fornecedores de chips. ASICs proprietários permitem ajustar a arquitetura com mais precisão aos algoritmos e cargas de trabalho específicos da OpenAI, economizando recursos e acelerando o lançamento de novos produtos no mercado.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Invariantes polinomiais canónicos no diagnóstico de falhas em simuladores de RL: onde são realmente úteis
O estudo avalia se a incorporação de leis físicas em modelos de dinâmica treináveis se justifica: os invariantes extraídos das trajetórias e reduzidos à forma canónica por meio de bases de Gröbner proporcionam ganhos modestos nas previsões, mas são eficazes no diagnóstico — permitem localizar a restrição violada e identificar o parâmetro específico incorreto.
10 novembro 2026
AURA-Eval: como verificar se o agente de LLM reconheceu o risco e mudou o próximo passo
O framework avalia o comportamento de agentes LLM não pelo veredito final, mas pela reação ao risco em pontos-chave: as trajetórias de chamadas a ferramentas são interrompidas, após o que o modelo deve continuar o raciocínio e a ação, enquanto um painel de juízes LLM analisa a detecção de riscos, a natureza e a segurança da ação. Em 1.249 tarefas reunidas a partir de 157 trajetórias do R-Judge, as ações inseguras tornam-se mais frequentes entre 20 modelos quando não há um caminho seguro, e a remoção da supervisão antes da execução transforma 52,3% dos casos inicialmente seguros em casos inseguros.
10 novembro 2026
Memória do reservatório de Chern–Simons: dinâmica autónoma de conectividade e transporte de densidade
O artigo analisa como um reservatório preserva o histórico dos sinais de entrada simultaneamente na distribuição de densidade e nos graus de liberdade geométricos. A comparação de quatro mecanismos mostra que a corrente cria uma componente de conectividade separada, que altera a resposta subsequente da densidade, e que considerar todas as características medidas proporciona um pequeno ganho na descodificação da ordem dos impulsos.
10 novembro 2026