
A resposta final como única métrica — e o que ela esconde
A maior parte dos benchmarks para modelos de linguagem funciona como uma prova escolar: há uma pergunta, há um gabarito, há uma verificação de correspondência. Calcular essa métrica é prático, e comparar modelos também. Mas esse esquema tem um defeito embutido: ele avalia o resultado, não o caminho até ele.
Imagine uma tarefa em que é preciso encadear quatro fatos. O modelo se confunde no segundo, chuta por acaso no quarto — e ganha o ponto. Ou o contrário: três elos perfeitamente construídos, mas a resposta final diferia por uma única formulação — e o ponto não vem. Nos dois casos, o número final mente sobre o que de fato aconteceu por dentro. Isso é especialmente doloroso em perguntas de múltiplos passos: ali não se testa uma única habilidade, mas a sequência delas — encontrar as informações, retê-las, conectá-las às seguintes, não perdê-las pelo caminho.
O diagnóstico de "onde exatamente quebrou" não é preciosismo acadêmico. É dele que depende o que consertar: o corpus de dados, a estratégia de treinamento ou a formulação do prompt. A acurácia final não consegue responder a essa pergunta por definição.
O que é o Omanic
É justamente esse ponto cego que o trabalho "Omanic: Towards Step-wise Evaluation of Multi-hop Reasoning in Large Language Models" (arXiv:2603.16654, enquadrado na seção cs.CL, também classificado em cs.AI e cs.LG, aceito no EMNLP 2026 Findings) vem cobrir. O grupo de autores é amplo e internacional: Xiaojie Gu, Sherry T. Tong, Aosong Feng, Sophia Simeng Han, Jinghui Lu, Yingjian Chen, Yusuke Iwasawa, Yutaka Matsuo, Chanjun Park, Rex Ying, Irene Li. A primeira versão foi publicada em 17 de março de 2026, seguida de duas revisões — em maio e em agosto.
O Omanic é um benchmark de domínio aberto com quatro passos de raciocínio. A palavra "domínio aberto" aqui é fundamental: o modelo não escolhe uma alternativa de uma lista pronta nem vasculha um único documento preparado de antemão. As informações precisam ser encontradas de forma autônoma e só então encadeadas. Essa abordagem é mais próxima dos cenários reais, em que a resposta quase nunca está em um único parágrafo.
Dois corpora em vez de um
Dentro do Omanic convivem dois conjuntos de dados distintos, e não convém confundi-los.
O primeiro é o OmanicSynth, com 10.296 exemplos gerados por máquina. É material de treinamento: pode ser usado como supervisão, e foi justamente nele que os autores verificaram se a capacidade de raciocinar passo a passo é transferível.
O segundo é o OmanicBench, com 967 exemplos que passaram por verificação especializada e contam com anotação manual. É a parte de avaliação, e é consideravelmente menor — o que faz sentido, já que a rotulagem humana no nível dos passos custa caro.
Essa separação não é formalidade. Ela permite distinguir "o modelo foi treinado" de "o modelo realmente sabe": o corpus de treino é grande e automático, o de verificação é compacto e criterioso.
Como funciona a rotulagem passo a passo
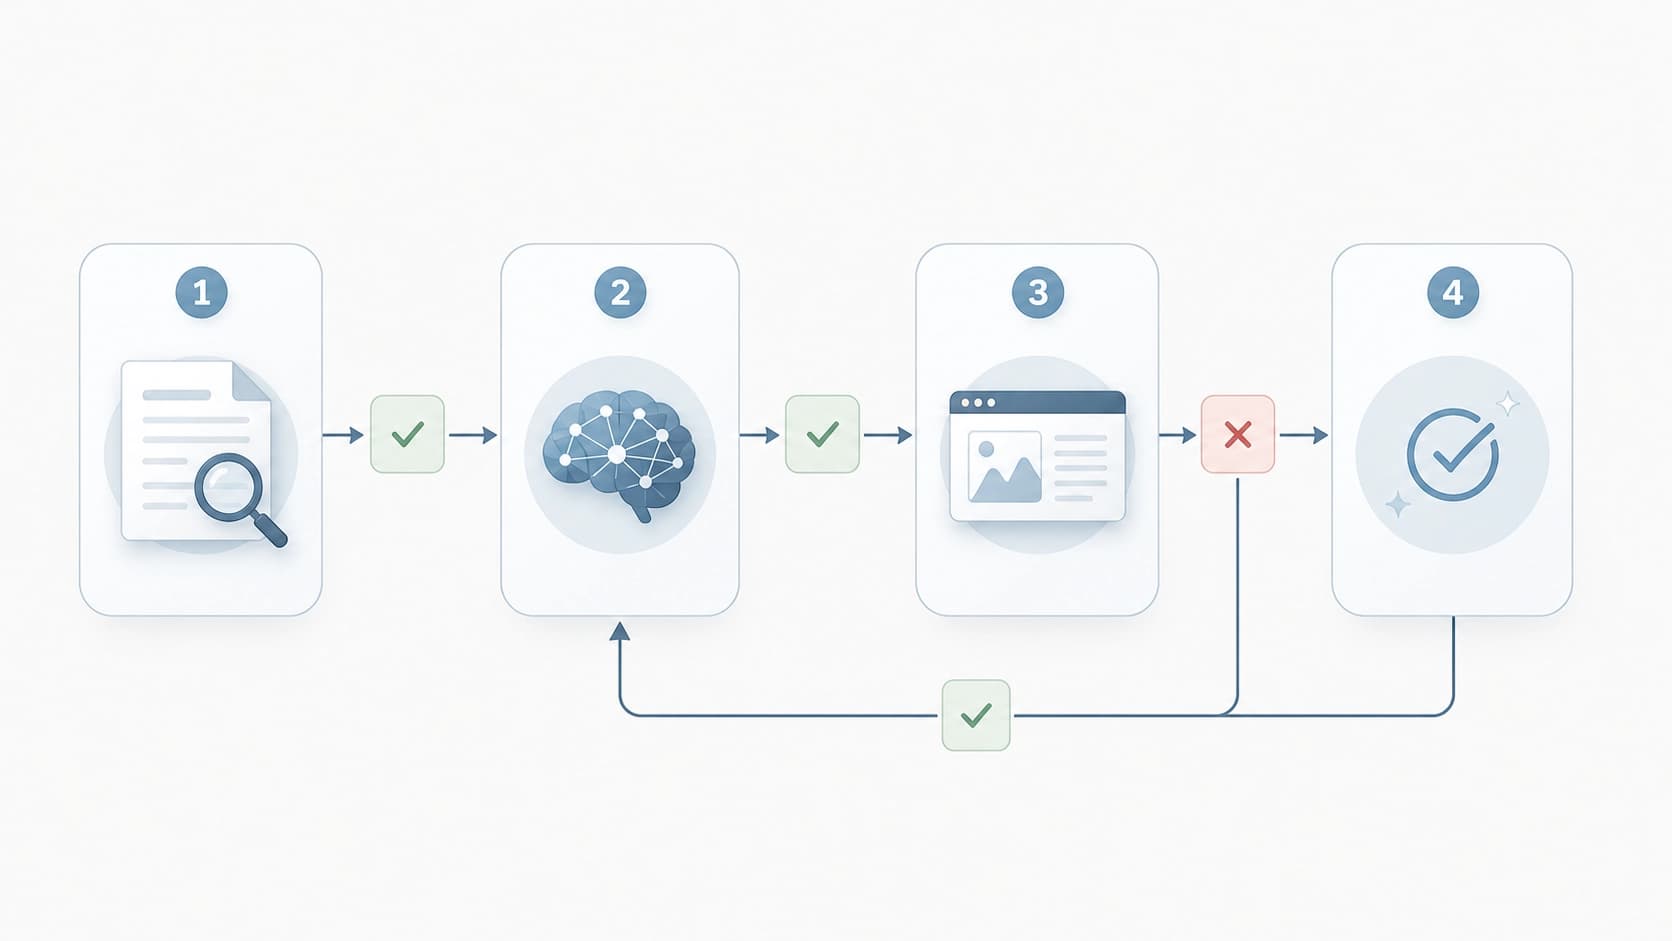
A principal diferença do Omanic em relação aos conjuntos de QA convencionais está em que cada pergunta é decomposta em seus componentes. Subperguntas de um passo, respostas intermediárias, topologias estruturadas em grafo — ou seja, o esquema de como os fatos se conectam entre si.
Isso transforma a avaliação de um único ponto em um conjunto de pontos de controle. Agora é possível ver não só "o modelo respondeu certo ou não", mas também "em qual transição exatamente ele travou". A estrutura em grafo importa aqui também porque tipos diferentes de conexão são assimilados com graus diferentes de facilidade: uma coisa é extrair uma propriedade de um objeto, outra bem diferente é seguir uma cadeia de quatro dependências sequenciais.
Três diagnósticos que só aparecem nos passos
Os experimentos com modelos fechados e abertos produziram três observações que a métrica final simplesmente não é capaz de mostrar.
O gargalo nos passos finais
A primeira conclusão os autores chamam de later-hop bottleneck. Trata-se do fato de que as principais perdas se acumulam não no início, mas perto do fim da cadeia. A primeira e a segunda transições os modelos atravessam com relativa segurança, mas na terceira e na quarta começam a desmoronar.
A explicação surge naturalmente: quanto mais longa a cadeia, mais entidades intermediárias precisam ser mantidas ativas ao mesmo tempo. Nos passos finais, o modelo já não opera sobre a pergunta original, mas sobre os resultados de suas próprias inferências anteriores — e qualquer imprecisão ali se multiplica. A conclusão prática é incômoda para quem gosta de montar pipelines longos e multifásicos: acrescentar o quinto e o sexto passo pode custar mais do que parece.
O "piso" do conhecimento factual
O segundo fenômeno é o factual knowledge floor, o "piso" do conhecimento factual. Parte dos erros não tem relação alguma com lógica: o modelo simplesmente não dispõe do fato necessário e, em vez de parar honestamente, continua construindo o raciocínio sobre o vazio.
Essa é uma distinção importante. Quando o modelo erra na inferência, a questão é o raciocínio. Quando ele não conhece o fato de origem, a questão são os dados e a capacidade de reconhecer o próprio desconhecimento. O segundo caso é difícil de tratar: nem o raciocínio passo a passo, nem um prompt mais inteligente ajudam se simplesmente não há base sob o primeiro elo.
O erro que se propaga pela cadeia
O terceiro diagnóstico é a propagação de erros ao longo da cadeia. Uma imprecisão inicial não permanece localizada: ela é absorvida pelos passos seguintes e se transforma em uma resposta final confiante, bem formulada e incorreta.
Aqui se esconde uma armadilha para a avaliação. O modelo que errou uma vez e depois raciocinou de forma coerente e o modelo que desmoronou em todos os passos parecem idênticos na métrica final — ambos erraram. A análise passo a passo os distingue, e é exatamente o caso em que o diagnóstico vale mais do que a pontuação final.
Transferência de aprendizado: 7,41 pontos em seis benchmarks
Uma questão à parte é se essa rotulagem pode ser usada não só para medições, mas também para treinamento. Os autores verificaram: o ajuste fino com o OmanicSynth trouxe melhora em seis benchmarks externos dedicados a raciocínio e matemática, com ganho médio de 7,41 pontos.
Um número que deve ser lido corretamente. Não é "o modelo ficou mais inteligente em tudo" — é "a habilidade treinada em cadeias decompostas se transfere para outras tarefas de tipo semelhante". O que, por si só, diz algo sobre a natureza do benchmark: ele não é sobre memorizar perguntas específicas, mas sobre treinar o procedimento — como dividir uma tarefa em passos e manter a conexão entre eles.
O que isso significa na prática
Algumas conclusões que se impõem a partir do que foi descrito.
Avaliar por passos, não pelo resultado final. Se o seu sistema produz respostas de múltiplos passos, uma única métrica final não basta — ela vai diluir falhas de naturezas diferentes em um número único e pouco claro.
Separar "não sei" de "inferi errado". São dois defeitos distintos, com formas distintas de tratamento, mas na reportagem habitual eles se fundem.
Cuidado com cadeias longas. Os passos finais são o ponto mais vulnerável. Às vezes é mais sensato dividir a tarefa em várias subtarefas independentes do que arrastar uma única cadeia longa até o fim.
A decomposição também é um sinal de treinamento. O resultado com transferência para seis conjuntos externos mostra que a rotulagem por passos funciona não só como régua, mas também como material de treino.
O que o Omanic não é
Vale delimitar as fronteiras. O Omanic não é uma avaliação universal da inteligência de um modelo nem um teste de tudo ao mesmo tempo. É uma ferramenta para uma tarefa específica: mostrar em qual elo do raciocínio ocorre a falha em perguntas de múltiplos passos de domínio aberto.
O tamanho da parte de avaliação — 967 exemplos — também merece ser levado em conta: o conjunto é criterioso, mas não gigantesco. A parte de treinamento é uma ordem de grandeza maior e criada por máquina, o que dá escala, mas não substitui a verificação manual.
E o principal: o diagnóstico em si não cura nada. Saber que o modelo tropeça nos passos finais é um ponto de partida, não uma solução. A partir daí começa o trabalho de sempre: onde adicionar dados, onde simplificar a cadeia, onde ensinar o modelo a parar e dizer "eu não sei isso".
Os dados e o código foram disponibilizados em acesso aberto pelos autores; o trabalho está disponível pelo DOI 10.48550/arXiv.2603.16654.


