
Por que as "não verbais" são uma dor de cabeça à parte para a síntese de fala
Um texto narrado ainda não é igual à fala viva. Uma pessoa suspira quando está cansada, solta uma risada num momento embaraçoso, pigarreia para preencher uma pausa, e sem essas inserções até uma dicção impecável soa como secretária eletrônica. É justamente por isso que a geração de vocalizações não verbais — NV, non-verbal vocalizations — há tempos é considerada um dos marcadores da síntese de fala "expressiva": ela separa o robô que lê um papel de uma voz em que se quer acreditar.
A dificuldade está no fato de que inserir uma risada é tecnicamente simples, mas inseri-la no lugar certo é uma tarefa de outra ordem. A precisão lexical pode ser contada por caracteres e palavras, mas a adequação de um suspiro ou de um riso contido numa frase específica é uma categoria difusa, mal formalizável e quase impossível de verificar automaticamente. As métricas clássicas são inúteis aqui: elas penalizariam o modelo por um som "extra", ainda que fosse justamente esse som que tornava a fala humana.
O que os autores propõem: preferências em vez de instruções
O trabalho intitulado Preference Optimization for Non-Verbal Vocalization Synthesis (arXiv:2608.24163, coleção eess.AS, submetido em 25 de agosto de 2026) aborda a questão pelo viés do aprendizado por preferências. O grupo de autores é formado por Haoyang Li, Chenglin Xu, Junchuan Zhao, Yuang Cao, Liumeng Xue, Yiwen Guo e Eng Siong Chng.
A ideia central é simples: em vez de prescrever manualmente regras do tipo "aqui a risada é adequada, aqui não", pode-se mostrar ao modelo pares de variantes de locução e dar-lhe um sinal de qual delas é melhor. Mas, como observam os pesquisadores, a aplicabilidade dessa abordagem especificamente às vocalizações não verbais ainda é pouco estudada — não está claro quais sinais de preferência coletar, como formar os pares e qual objetivo de otimização definir.
Os autores conduziram um estudo sistemático em três eixos ao mesmo tempo: fontes de sinais de preferência, formas de construir pares e objetivos de otimização com base em DPO (Direct Preference Optimization). No fundo, não se trata de inventar um novo algoritmo, mas de um mapa do terreno — uma tentativa de entender quais decisões no pipeline realmente mudam o resultado e quais quase não fazem diferença.
NV-CER: uma métrica que conta tanto palavras quanto risadas
Um achado à parte do trabalho é a métrica NV-aware character error rate, ou NV-CER. A ideia é parar de tratar as inserções não verbais como ruído e lidar com elas em pé de igualdade com as palavras comuns: as tags NV passam a ser símbolos de saída como quaisquer outros, e a CER ponderada baseada em pinyin é calculada sobre o conteúdo combinado — tanto verbal quanto não verbal.
O sentido prático dessa métrica está na controlabilidade. Como a parte não verbal agora é mensurável separadamente, é possível movê-la deliberadamente na direção desejada sem reescrever o próprio algoritmo de otimização. Esse é um ponto importante: a equipe conscientemente não inventa uma nova arquitetura, mas mostra como extrair mais das ferramentas já existentes por meio da formulação correta do problema.
Como isso foi testado
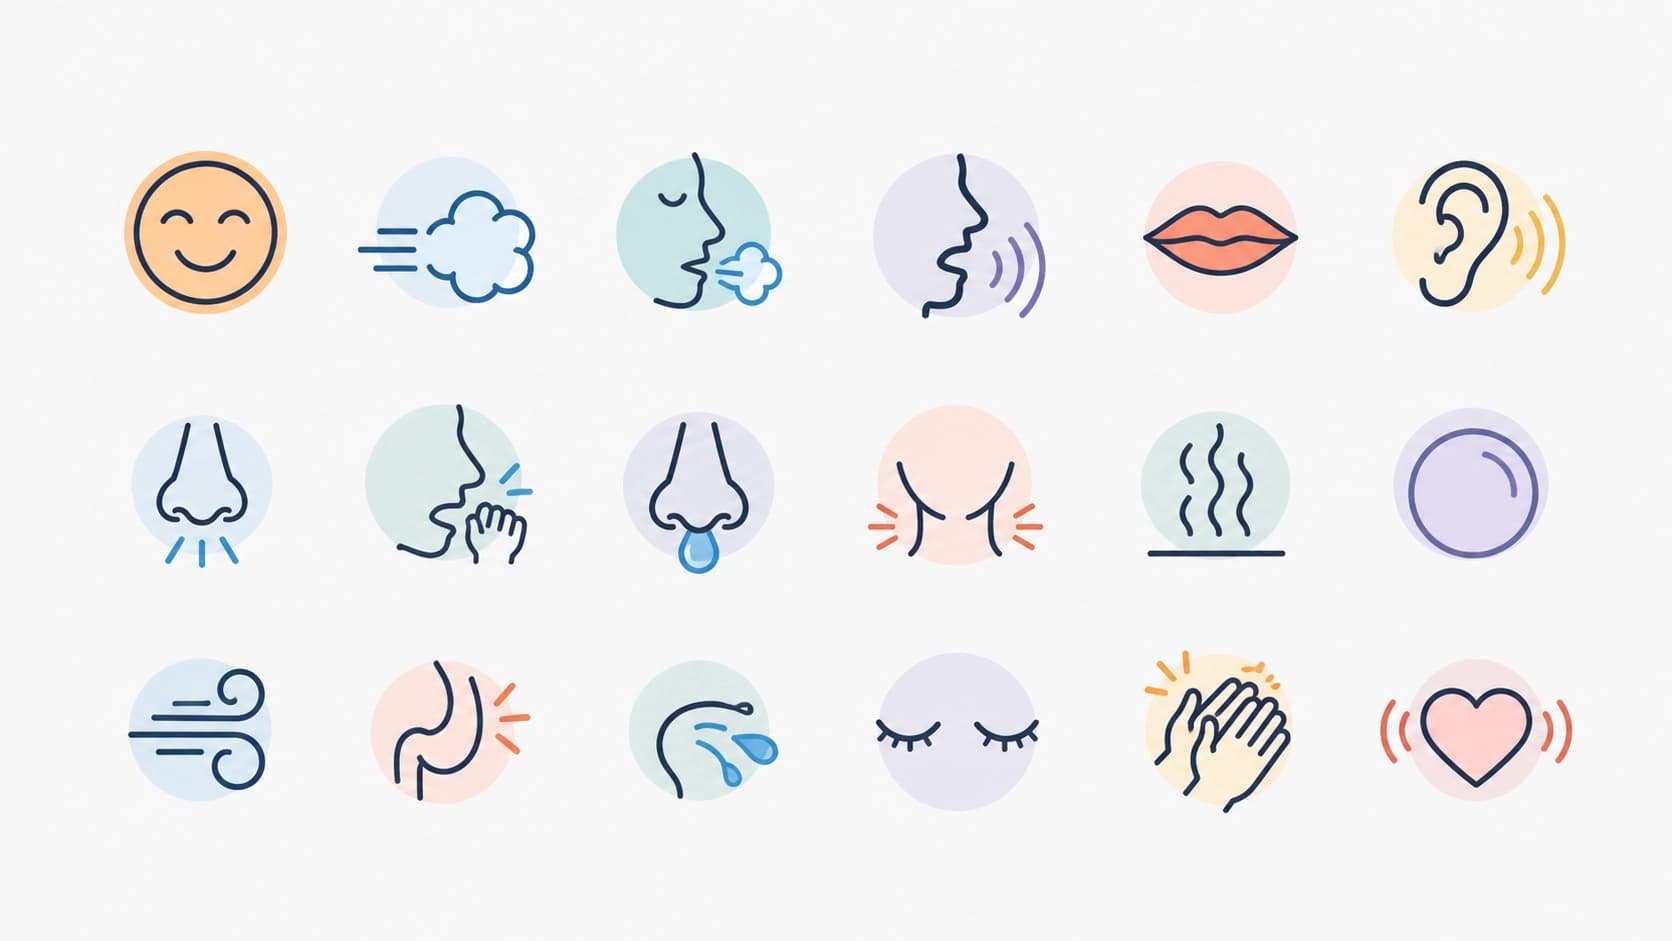
Os experimentos foram realizados no conjunto de dados Emilia-NV, bem como numa versão ampliada do NV-Bench — um conjunto que cobre 18 tipos diferentes de vocalizações não verbais. Essa variedade é importante: risada, tosse e suspiro não são o mesmo fenômeno, e um método que funciona para um tipo pode muito bem desmoronar em outro.
A avaliação foi feita em três canais ao mesmo tempo: métricas objetivas, julgamento com o auxílio de um grande modelo de linguagem e avaliação humana. A convergência das três linhas de evidência é um argumento forte, porque são justamente as divergências entre métricas automáticas e a percepção humana que costumam destruir estudos desse tipo.
O que os resultados mostraram
A principal conclusão: a configuração importa, mas não qualquer uma. Diferentes variantes de design afetam de maneiras distintas duas coisas ao mesmo tempo — com que frequência e com que naturalidade o modelo realiza as vocalizações, e com que precisão ele preserva o conteúdo lexical. É o clássico compromisso: um ajuste agressivo demais voltado à expressividade começa a prejudicar a inteligibilidade.
Ao mesmo tempo, os pesquisadores conseguiram encontrar uma configuração eficaz com base no DPO padrão — sem sobreposições exóticas. Soa como um resultado modesto, mas na prática é mais valioso do que um resultado vistoso: significa que o método é reproduzível e não exige recursos raros.
O que disso decorre para a prática
O trabalho se apresenta como um conjunto de recomendações práticas para o pós-treinamento NV-aware voltado à síntese expressiva. Algumas conclusões que decorrem logicamente dele:
- A métrica determina o comportamento. Enquanto as inserções não verbais não forem destacadas como uma entidade mensurável à parte, o modelo não terá como ser sistematicamente melhorado nessa direção.
- O sinal importa mais que o algoritmo. A principal variabilidade está em de onde vêm as preferências e em como os pares são construídos, e não na escolha do otimizador.
- Tipos diferentes de NV são tarefas diferentes. Riso e suspiro seguem regras distintas, e uma avaliação por um indicador médio provavelmente esconde alguma coisa.
- A verificação tripla é obrigatória. A concordância entre avaliações objetivas, de LLM e humanas é a condição mínima para confiar no resultado.
Numa visão mais ampla, essa história é sobre uma mudança de perspectiva na síntese de fala. Antes, qualidade significava "palavras pronunciadas corretamente". Agora, cada vez mais se trata de saber se o sistema consegue se comportar como uma pessoa: calar-se no momento certo, soltar uma risada onde o interlocutor riria. E para esse comportamento, como mostra o estudo, muito mais útil do que um novo algoritmo é uma métrica honesta e um sinal de preferência bem construído.


