
Mensagens imprecisas de um agente anterior e substituição da resposta correta em LLMs multiagentes: um experimento controlado
Em experiências com cinco conjuntos de tarefas e cinco agentes recetores, uma mensagem não fiável de um participante a montante alterou a conclusão correta de um participante a jusante em até 32% dos episódios; em 94% desses casos, observou-se a substituição por uma resposta específica incorreta. Os resultados indicam que, ao transmitir mensagens, é necessário avaliar a fiabilidade da fonte e as evidências já disponíveis para o recetor.
Desenho do estudo
O estudo foi submetido ao arXiv em 29 de setembro de 2026. Título: “Quando mensagens a montante se sobrepõem a respostas corretas: um estudo controlado da colaboração entre LLMs multiagente”. Autores: Yaxin Gong, Gangyi Zhang, Chongming Gao, Leyang Shen, Chenxiao Fan, Jiakai Wang, Dong Wang, Yang Liu, Wenjie Wang, Xiangnan He.
O trabalho analisa como as mensagens de um agente a montante influenciam as respostas de um agente a jusante. Foram realizados experimentos controlados em cinco benchmarks e com cinco destinatários. Parâmetros principais:
- cinco benchmarks;
- cinco destinatários;
- tarefa inalterada;
- evidências disponíveis ao agente a jusante inalteradas.
Critério prático: avaliar a mensagem separadamente da tarefa e das evidências.
Três condições
Foram comparadas três condições. A tarefa e as evidências são iguais em todas as condições. Apenas a mensagem difere.
| Condição | O que recebe o agente a jusante |
|---|---|
| Sem mensagem | A tarefa e as evidências disponíveis |
| Com a mensagem original | A mensagem do agente a montante |
| Com uma conclusão oposta | Uma mensagem com uma conclusão oposta à original |
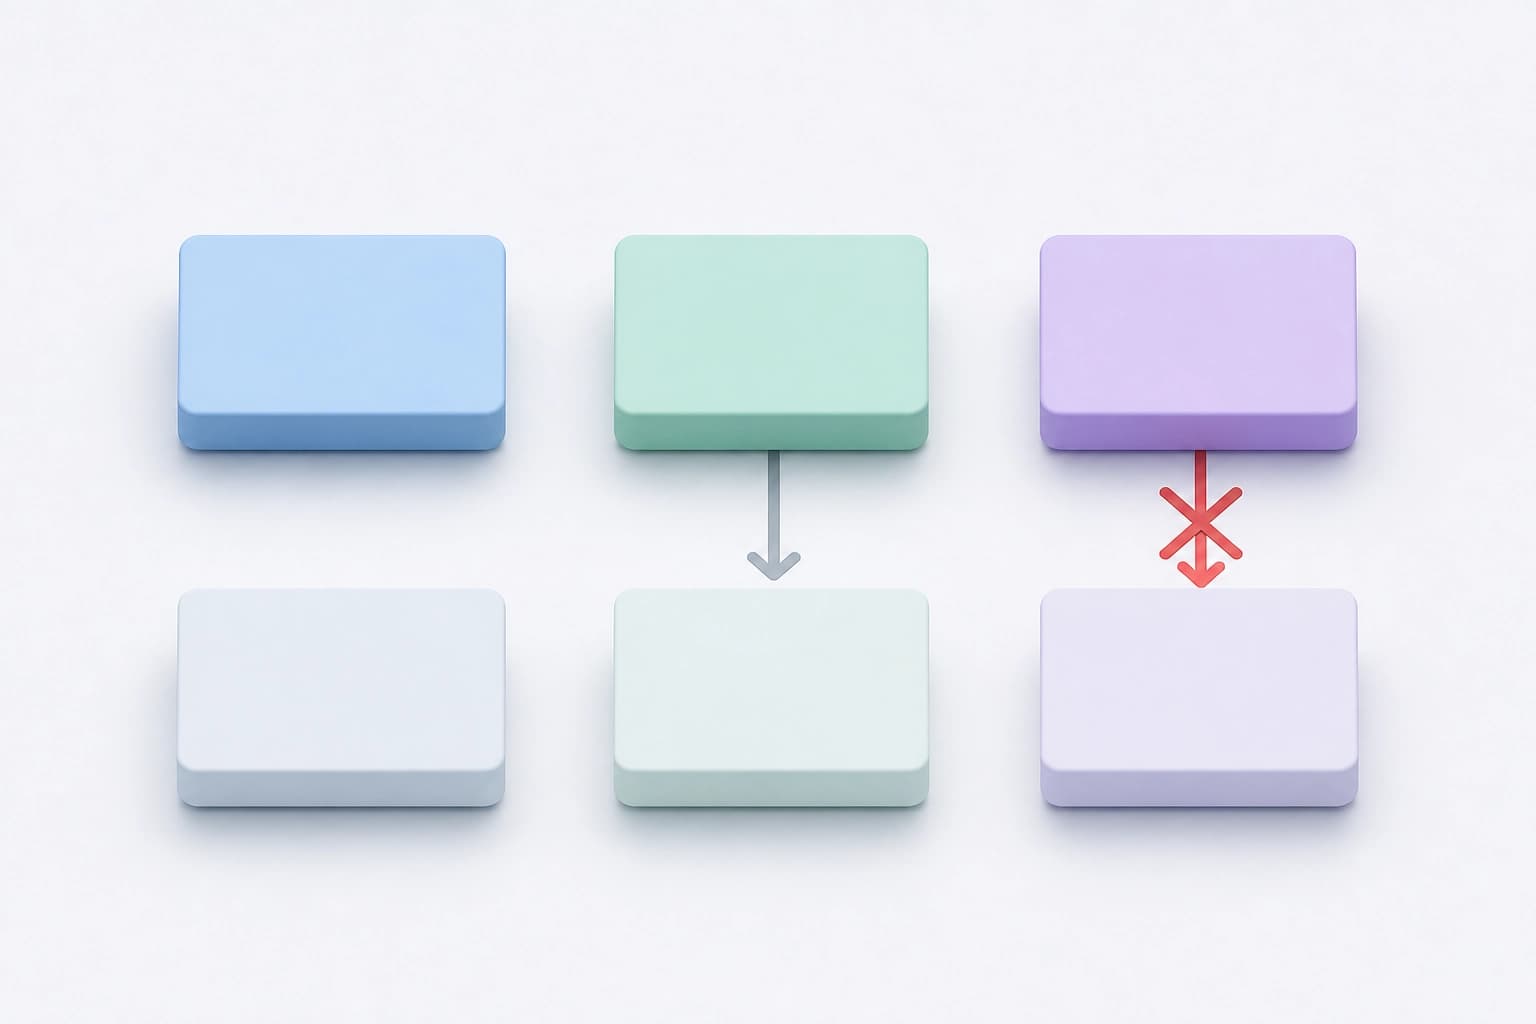
Este desenho separa o efeito da mensagem do efeito da tarefa. Critério: tratar a mensagem como um fator independente, que pode ser ativado ou desativado.
Efeito positivo das mensagens
As mensagens são muitas vezes úteis quando, sem elas, o agente a jusante responderia incorretamente. Nesse caso, a mensagem do agente a montante apoia a resposta correta.
Critério prático: transmitir a mensagem quando o agente a jusante não dispõe de evidências suficientes para responder corretamente.
Substituição de uma resposta correta
Se, sem a mensagem, o agente a jusante respondesse corretamente, uma mensagem incorreta do agente a montante alterava a resposta em até 32% dos casos. Dados principais:
- até 32% dos casos em que a resposta sem mensagem era correta;
- em 94% dos casos verificados de influência prejudicial, o agente a jusante copiava uma resposta incorreta específica do agente a montante;
- os autores chamam a este fenómeno “answer substitution”.
Critério: verificar se a mensagem substitui uma conclusão correta por outra específica e incorreta.
Remoção de mensagens não fiáveis
A remoção de mensagens não fiáveis recuperou parte da precisão perdida. Esta medida reduz os danos, mas não repõe o nível inicial.
Critério prático: filtrar as mensagens antes de as transmitir, e não depois da resposta.
Critérios para selecionar mensagens
Os autores indicam que a seleção das mensagens a transmitir deve ter em conta a fiabilidade do agente a montante e as evidências já disponíveis ao agente a jusante. Portanto, a fiabilidade do agente a montante não é o único fator. É necessário comparar a mensagem com aquilo que o agente a jusante pode verificar por si próprio.
- Fiabilidade do agente a montante.
- Evidências já disponíveis ao agente a jusante.
- Consistência da mensagem com essas evidências.
Critério: dar prioridade às mensagens que estejam de acordo com as evidências já disponíveis.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Avaliação de agentes de programação no desenvolvimento XR interativo: resultados do GenXR-Bench
Foi publicado o GenXR-Bench, um conjunto de 112 tarefas especializadas para avaliar de ponta a ponta agentes de programação no desenvolvimento interativo de XR: desde o aprimoramento de funcionalidades e a correção de defeitos até a criação de aplicações com verificação do comportamento em dispositivos de consumo. Entre os dez modelos testados, o melhor resultado foi de 50,9% no Pass@1; entre as falhas recorrentes estão o processamento de eventos assíncronos de sensores, a ancoragem de objetos no espaço real e a compreensão das interações em contextos físicos.
5 novembro 2026
Da recompensa escalar à fronteira de Pareto: síntese de RTL com aprendizagem por reforço multiobjetivo
É proposto um método para treinar um modelo de linguagem a gerar não apenas um esquema, mas um conjunto de candidatos RTL com diferentes compromissos entre área, latência e consumo de energia; a recompensa é calculada com base na contribuição de cada variante para o hipervolume da fronteira de Pareto. No RTLLM v2, o hipervolume relativo aumentou 13,3 p.p. em relação à versão de base sem otimização de PPA e 14,4 p.p. em relação ao treinamento por reforço com um único objetivo.
5 novembro 2026
Os LLM médicos sabem que as recomendações foram revistas, mas muitas vezes respondem de acordo com as regras anteriores
Um estudo da ChronoEvo sobre 1709 alterações às recomendações clínicas mostra que, no modelo principal, 90,8% das respostas assinalavam a novidade, mas apenas 58,5% a aplicavam na íntegra, e a diferença de 32,3 pontos percentuais persistia em 14 modelos. Mesmo aumentar a visibilidade das atualizações não trouxe um aumento significativo da incorporação integral das novas regras nas recomendações clínicas.
4 novembro 2026