Por que um esboço global não funciona para páginas
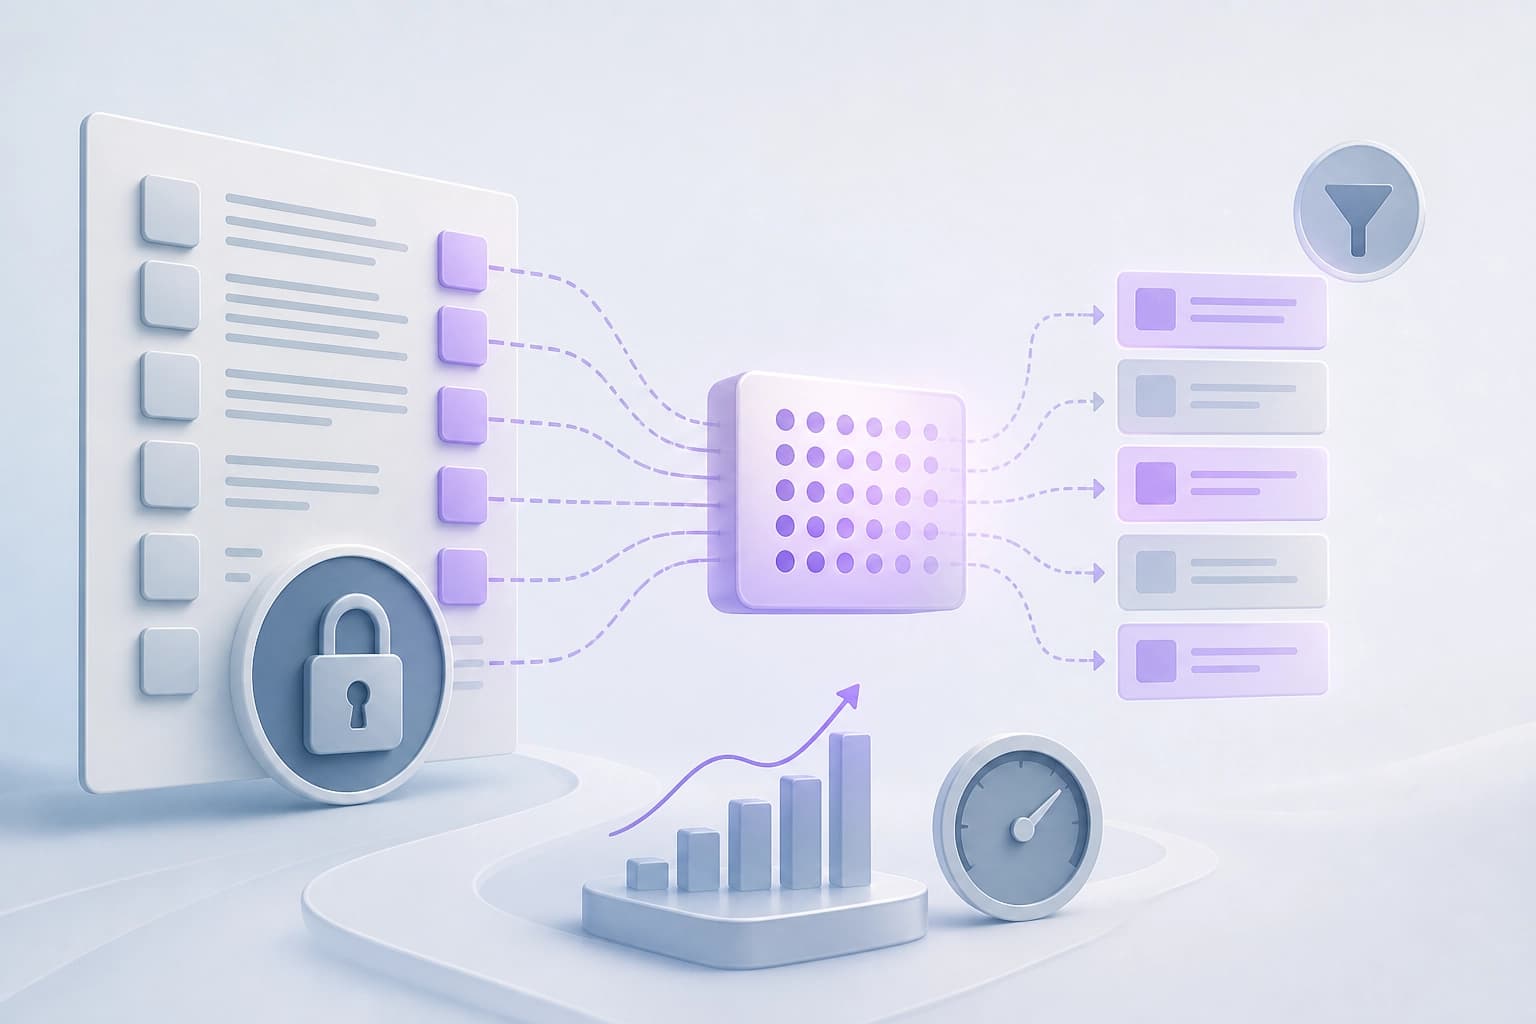
A manutenção de grandes modelos de linguagem em contexto longo esbarra no cache key-value (KV). O cache é lido integralmente a cada passo de decodificação. As attention keys são localmente low-rank, embora globalmente high-rank. Um esboço low-rank fixo, comum a todas as páginas, é comprovadamente cego às direções das páginas.
Com o mesmo tamanho de summary, a base própria da página ranqueia as páginas e preserva os portadores muito melhor. O esboço global não enxerga essas direções. O summary espectral por chave resolve o problema.
Resumo espectral por página
O LOCKS fornece a cada página seu próprio rank-r spectral summary. O resumo é residente: um décimo do cache com r=8 e um vinte e cinco avos com r=2. O método reconstrói os logits intrapágina. Ele estima a massa de atenção de cada página via log-sum-exp. Em seguida, processa apenas as páginas superiores.
Elementos-chave:
- Nome: Page-Local Compact Key Summaries for Efficient Long-Context Decoding.
- Resumo: rank-r spectral summary para cada página.
- Residência: um décimo do cache com r=8, um vinte e cinco avos com r=2.
- Reconstrução: logits intrapágina.
- Estimativa: massa de atenção da página via log-sum-exp.
- Seleção: apenas as páginas superiores.
Conclusão: o resumo ocupa uma fração do cache, mas preserva as características das páginas. A seleção de páginas ocorre com base nos dados espectrais.
Seleção de blocos sem leitura de chaves
A própria seleção não lê as chaves ou valores dos candidatos. A escolha ocorre apenas com base no resumo espectral. O resumo é escaneado integralmente a cada passo. A leitura de KV por passo cai de 10 a 25 vezes no intervalo de ranks indicado.
A latência de decodificação por token é reduzida pela metade. Com 1M de tokens em uma única H200 NVL, o ganho é de 2.0× com r=8. Essa é uma comparação com atenção densa. A seleção não depende da leitura das chaves dos candidatos.
Qualidade em tarefas longas
O LOCKS preserva a qualidade em vários tipos de tarefas. Em long-document QA (LongBench-v1; Llama-3.1-8B), o resultado permanece dentro de um ponto do cache completo. Em retrieval-dense RULER, o método segue o oráculo LSE exato, que lê cada chave, até os menores orçamentos. Em long-form reasoning (AIME26, MATH-500; Qwen3-4B), a qualidade se mantém por mais tempo em regime de orçamentos pequenos. Seletores e compressores de raciocínio baseados em eviction recuam nesse cenário.
Com orçamento de 2048 tokens, o LOCKS iguala a qualidade agregada do FullKV em contexto de 100K+ (GLM-4-9B-Chat-1M). Ao mesmo tempo, o método processa 2% dos tokens.
| Condição | Resultado |
|---|---|
| Long-document QA (LongBench-v1; Llama-3.1-8B) | dentro de um ponto do cache completo |
| Retrieval-dense RULER | segue o oráculo LSE exato até orçamentos pequenos |
| Long-form reasoning (AIME26, MATH-500; Qwen3-4B) | mantém a qualidade por mais tempo em orçamentos pequenos |
| Orçamento de 2048 tokens, contexto 100K+ (GLM-4-9B-Chat-1M) | iguala o FullKV, processa 2% dos tokens |
Conclusão: nas tarefas listadas, a abordagem preserva a qualidade por mais tempo do que seletores e compressores baseados em eviction.
Implantação e critério de escolha
A abordagem é fornecida como plugin drop-in para o vLLM não modificado. A decodificação em lote funciona em CUDA graphs completos. Não é necessária modificação do vLLM.
Critério de escolha: contexto longo, orçamento de tokens limitado, necessidade de reduzir a leitura de KV e a latência de decodificação. Se a tarefa exige seleção de blocos sem leitura das chaves dos candidatos, a abordagem é adequada.