O que muda com o LocalProp
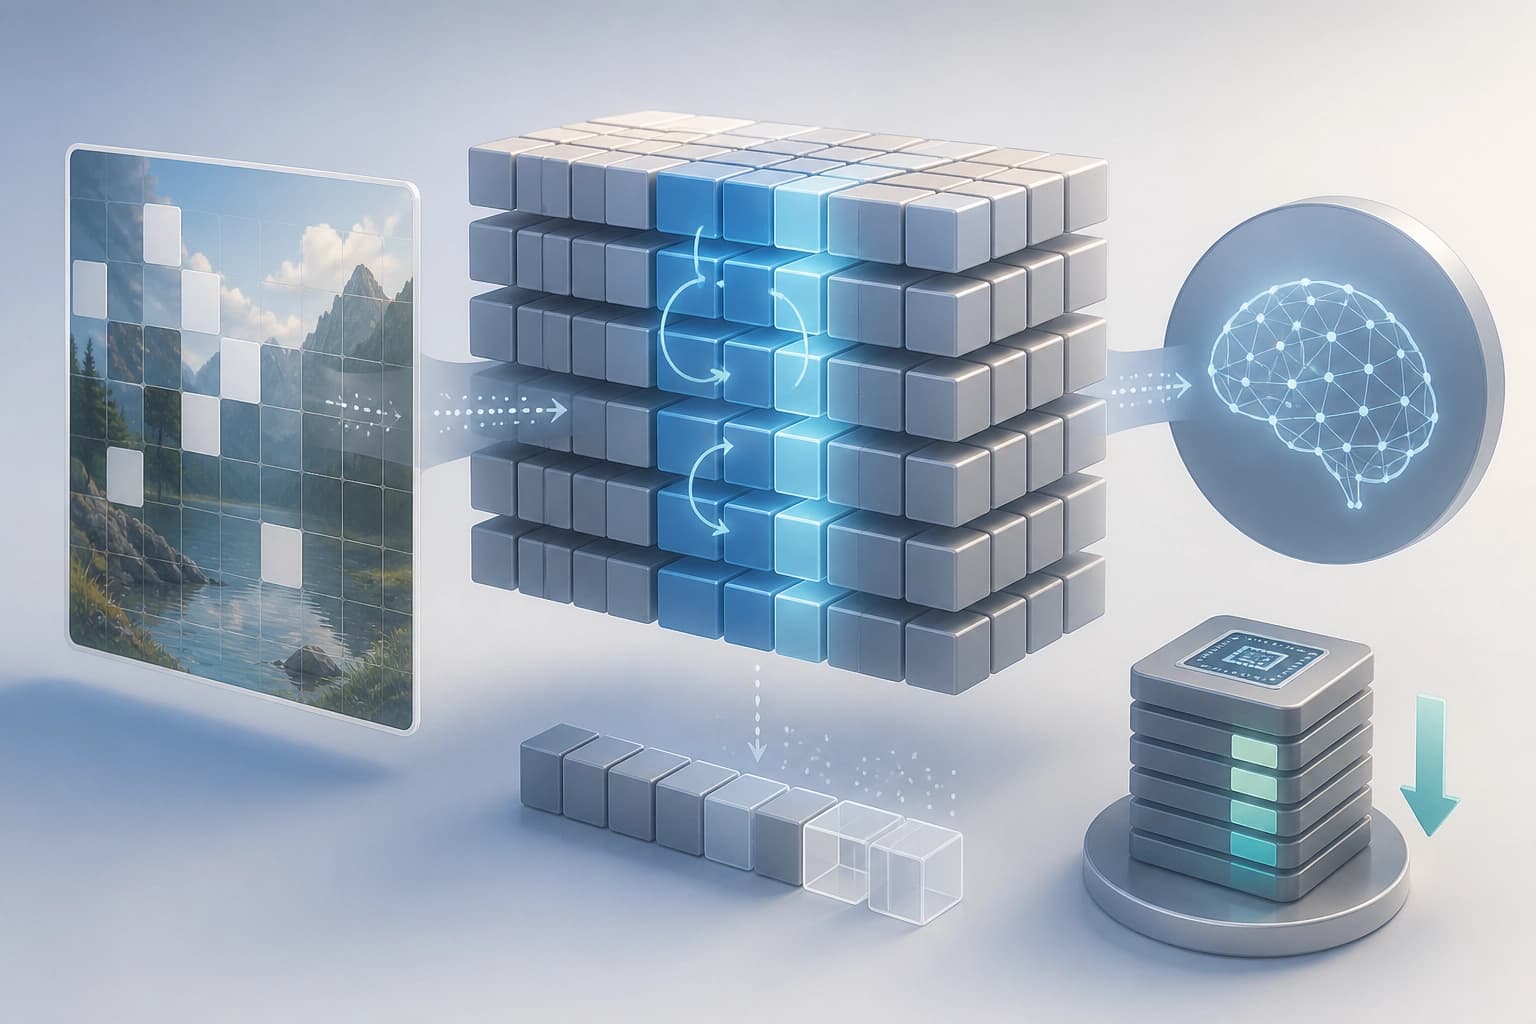
LocalProp é um procedimento de treino que atualiza localmente os pesos do modelo. Os autores contrapõem-no à retropropagação do gradiente através de todo o modelo. A passagem completa não corresponde a um treino biologicamente plausível. Também é ineficiente em termos de memória. A aprendizagem no cérebro é fortemente localizada.
| Critério | Retropropagação do gradiente completa | LocalProp |
|---|---|---|
| Atualização dos pesos | Percorre todo o modelo | Local |
| Plausibilidade biológica | Não corresponde | Baseia-se na aprendizagem localizada no cérebro |
| Memória | Ineficiente | Utiliza apenas uma parte do pico de memória da GPU |
| Controlo | Não existe um parâmetro separado | Número de blocos otimizados em conjunto |
Conclusão: o LocalProp substitui a passagem completa por atualizações locais. Isto reduz a carga de memória.
Etapas de treino
O LocalProp segue um esquema de «pré-treino seguido de ajuste fino». As etapas são organizadas em sequência.
- Pré-treino com I-JEPA.
- Atualização local dos pesos.
- Poda.
- Um breve ajuste fino final.
Conclusão: o esquema combina pré-treino, atualizações locais, poda e ajuste final.
O papel da poda
A poda transmite o sinal de treino dos blocos superiores para os inferiores. Esta etapa não se resume à compressão do modelo. Liga os blocos superiores e inferiores durante o treino. Conclusão: a poda no LocalProp funciona como um canal de transmissão de sinal entre blocos.
Compromisso entre precisão e memória
O número de blocos otimizados em conjunto define o comprimento da propagação do gradiente. Os autores definem esse comprimento como um parâmetro prático. O parâmetro controla o compromisso entre a precisão e a utilização de memória.
- O que muda: o comprimento da propagação do gradiente.
- O que controla: o equilíbrio entre precisão e memória.
- Como é utilizado: através do número de blocos otimizados em conjunto.
Conclusão: ajustar o número de blocos permite controlar esse equilíbrio.
Resultados e critério de escolha
Os autores realizaram experiências em vários conjuntos de dados. Entre eles, encontram-se benchmarks de grande escala, incluindo o ImageNet. O LocalProp alcança bons resultados utilizando apenas uma parte do pico de memória da GPU. O texto não indica a percentagem concreta. Critério prático: o LocalProp é adequado quando a passagem inversa completa esgota a memória da GPU. O número de blocos otimizados em conjunto permite ajustar o equilíbrio.