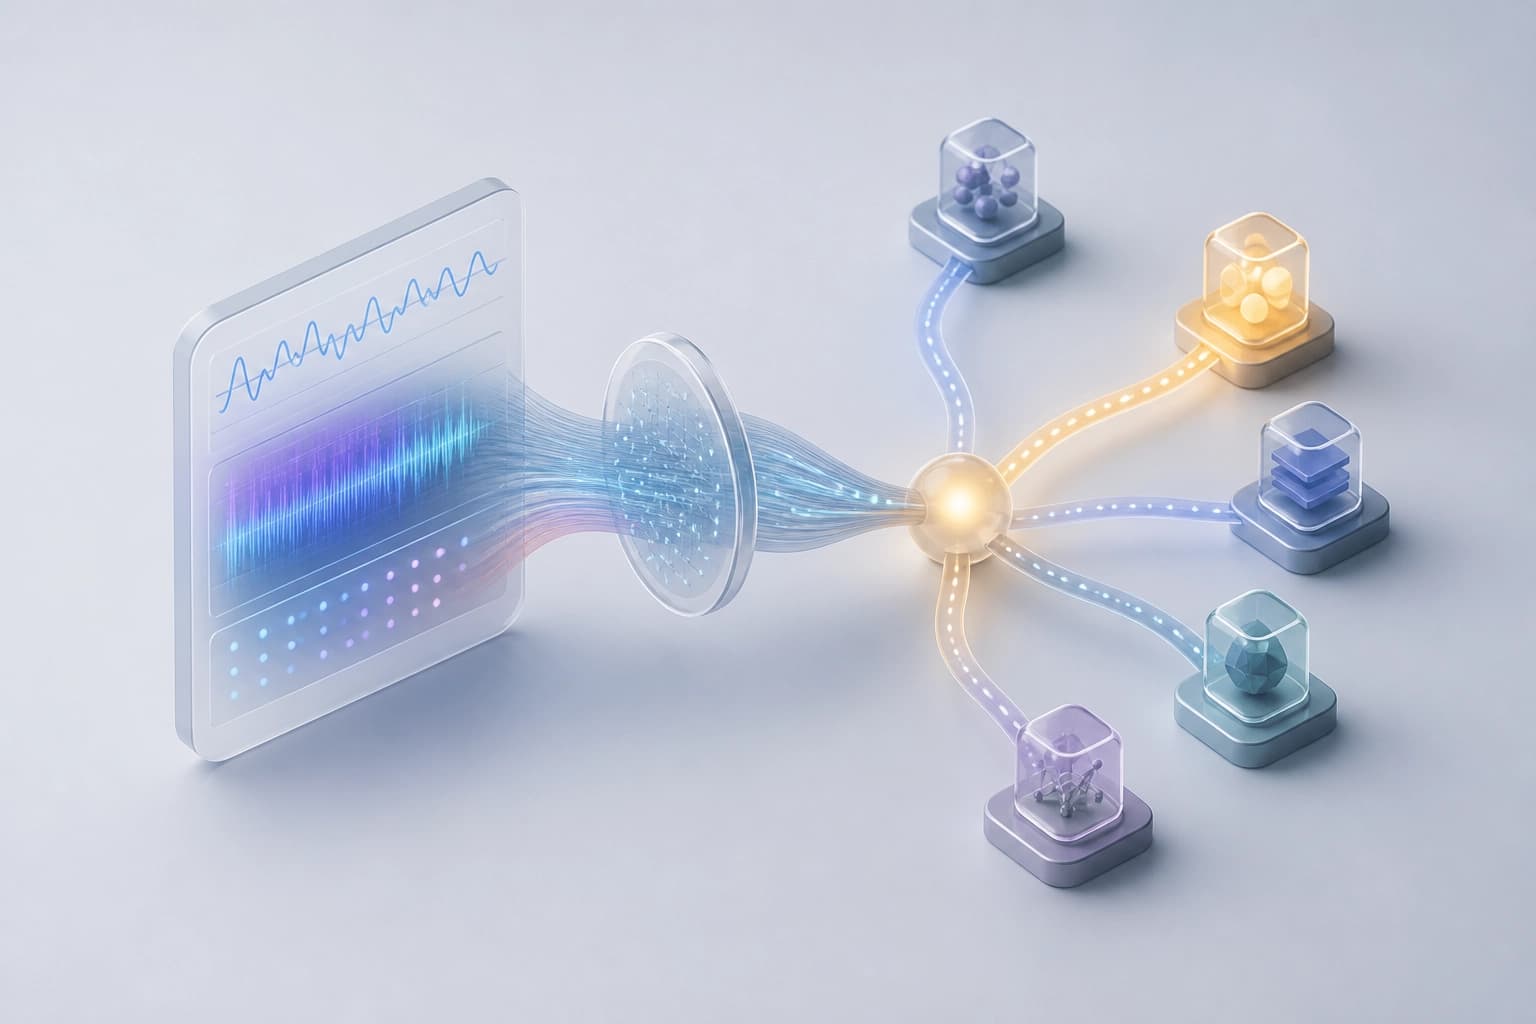
O que o roteador recebe
Em modelos de linguagem MoE, o roteador seleciona especialistas e atribui pesos a eles com base no estado oculto do token. Para isso, utiliza informações contextuais limitadas.
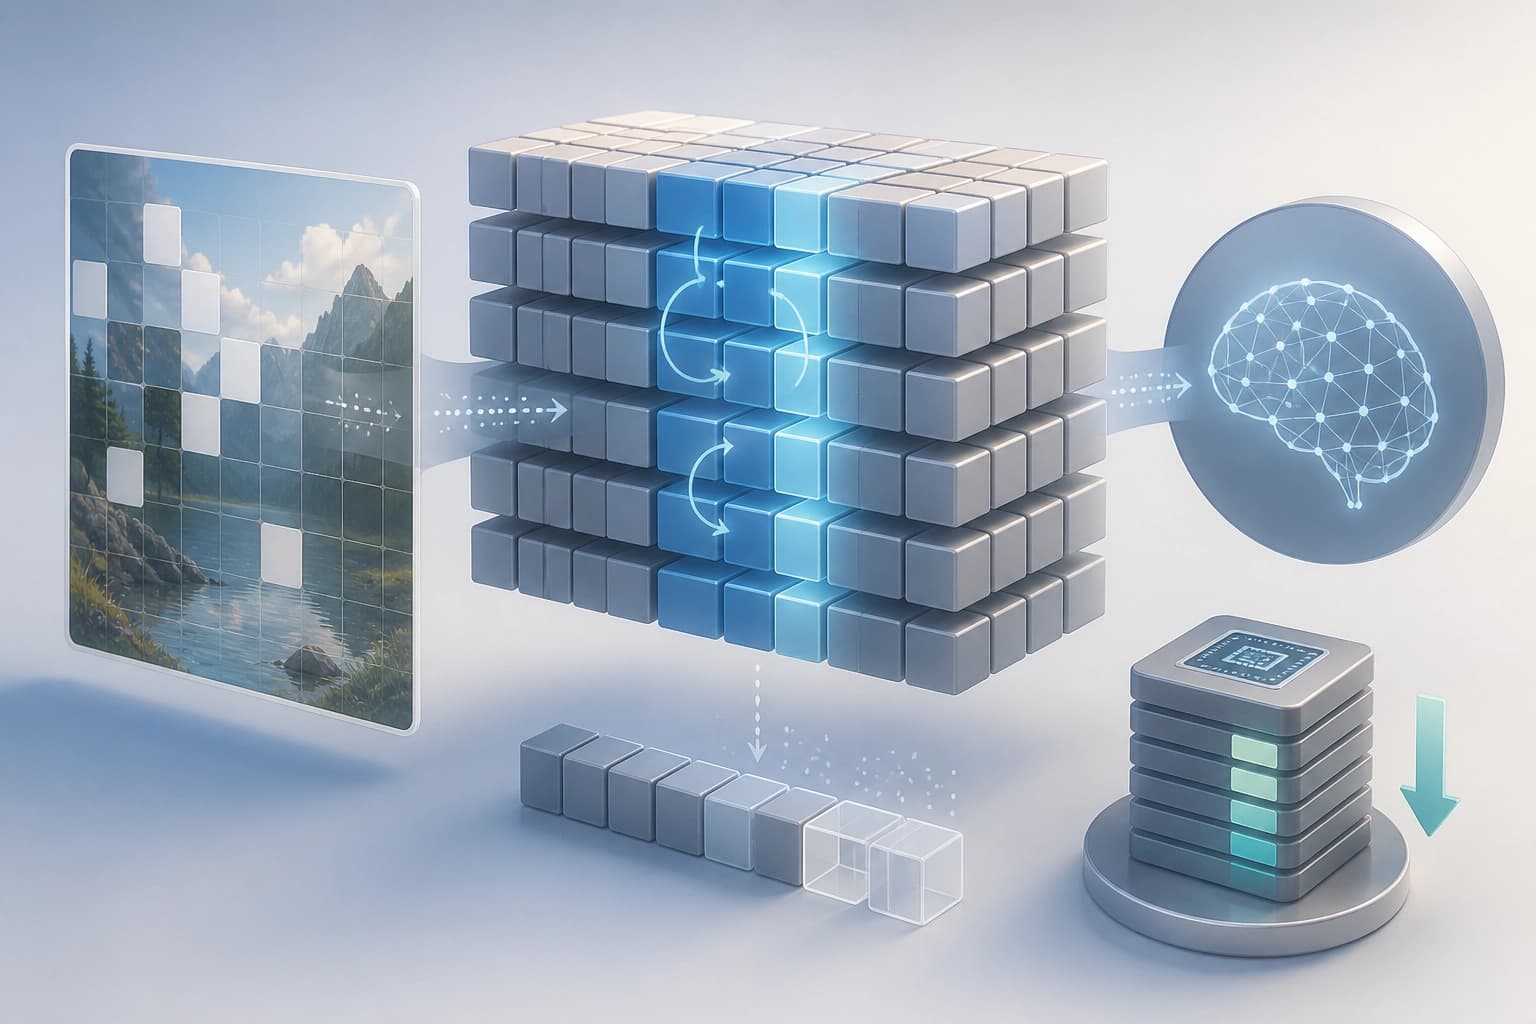
Attention-Aware Routing (AAR) complementa esse sinal com características temporais e espectrais. Elas são extraídas de uma janela deslizante dos pesos de atenção.
- O roteamento convencional baseia-se no estado oculto do token.
- O AAR adiciona características de atenção que resumem o estado contextual separadamente do estado oculto.
Critério prático: ao analisar a seleção de especialistas, é preciso distinguir o sinal do token do resumo contextual adicional.
Como funciona o AAR
O AAR obtém características temporais e espectrais de uma janela deslizante dos pesos de atenção. Assim, o roteador utiliza um sinal contextual separado do estado oculto do token.
Os autores mantêm o transformador base completamente congelado e treinam apenas os parâmetros de roteamento. Isso permite estudar o roteamento como a única variável alterada.
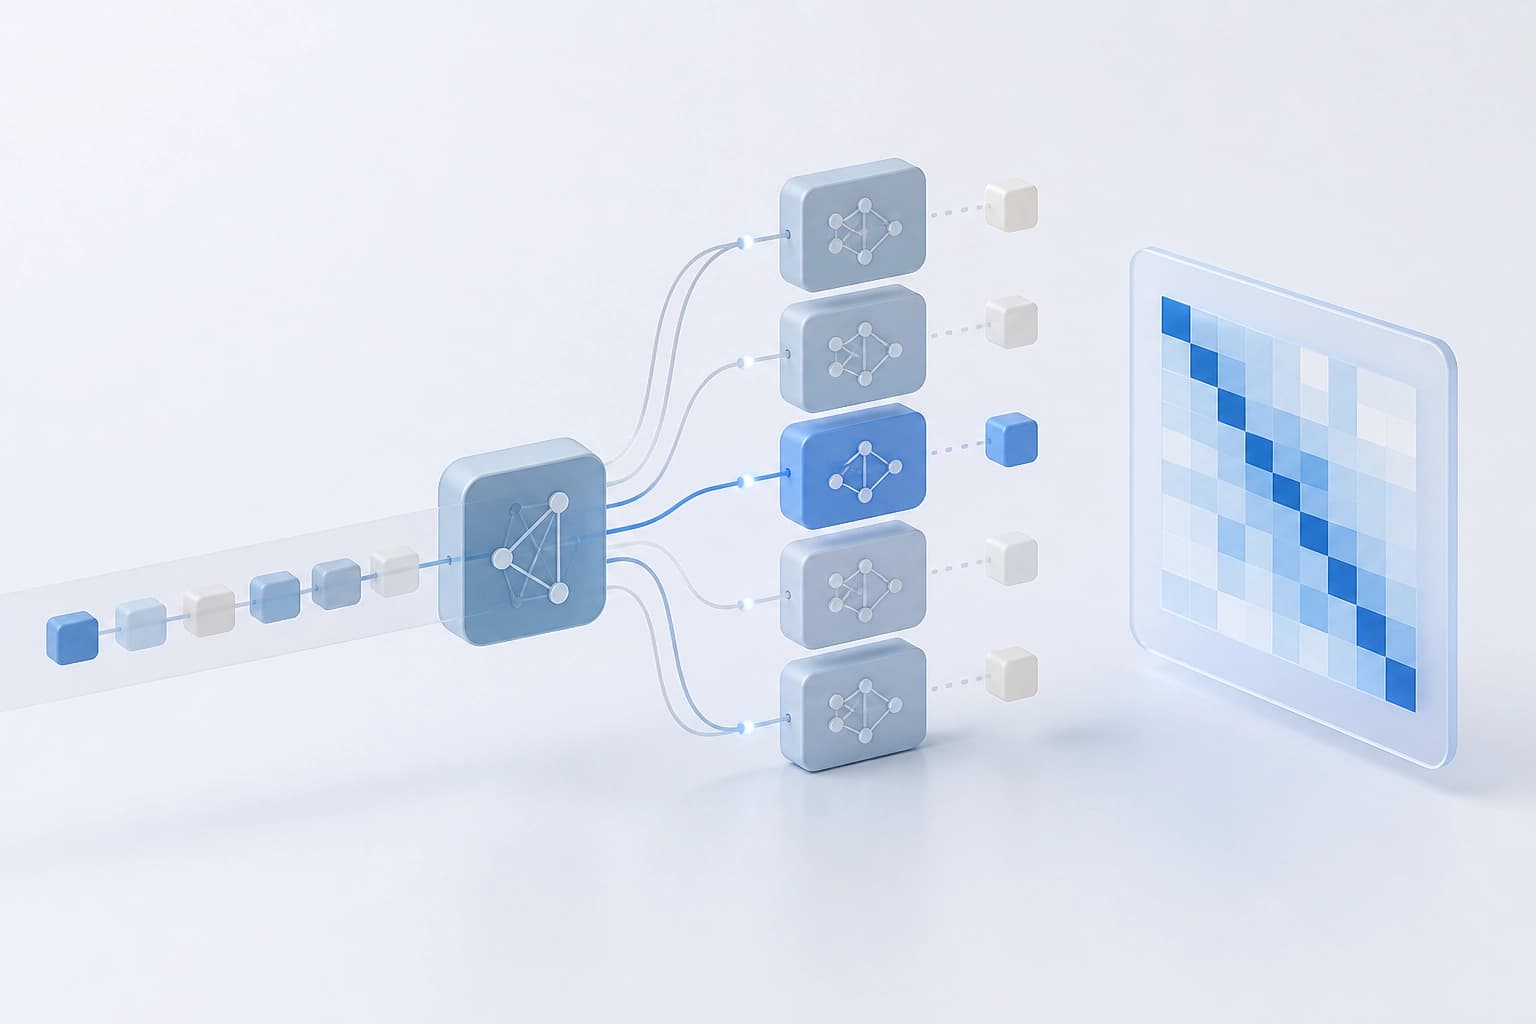
O critério para avaliar o método é separar o efeito do roteamento das alterações nos demais parâmetros do modelo.
Por que o roteamento altera a atenção
O roteamento e a atenção estão ligados pela sequência de camadas. As alterações no roteamento na camada l propagam-se pelo fluxo residual e intensificam os sumidouros de atenção na camada l+1.
Isso altera a atenção sem atualizar diretamente o seu mecanismo. Portanto, a seleção de especialistas pode influenciar o processamento posterior do contexto.
Ao analisar os resultados, é importante considerar essa relação: aqui, a atenção não é apenas um sinal de entrada para o roteador, mas também faz parte da cadeia de consequências do roteamento.
O que os resultados mostraram
No OLMoE, o AAR aumentou o resultado no GSM8K em 3,37 pontos percentuais em relação à variante de base SFT apenas com roteamento.
| Indicador | Resultado do AAR |
|---|---|
| GSM8K | +3,37 pontos percentuais em relação à variante de base |
| Respostas incorretas | Ficaram mais curtas em gerações longas e divergentes |
| Respostas corretas | O comprimento não mudou |
Esses resultados descrevem uma avaliação específica. Eles não mostram que o AAR tem o mesmo efeito em todas as tarefas.
Ao comparar variantes, convém considerar separadamente o resultado na tarefa e o comprimento da geração: esses indicadores variaram de formas diferentes.
Por que importa em quais camadas o AAR é aplicado
O efeito do AAR depende da profundidade. Aplicá-lo indiscriminadamente em diferentes camadas pode reduzir a qualidade da extração factual.
Quando aplicado em camadas mais profundas, as vantagens no raciocínio matemático são mantidas. Isso revela um conflito entre a extração de informações e o raciocínio em diferentes profundidades.
- Para avaliar a extração factual, é importante verificar se a aplicação do AAR em diferentes camadas a prejudica.
- Para o raciocínio matemático, é importante considerar o resultado em camadas mais profundas.
- A aplicação seletiva permite investigar que informações de roteamento a atenção transmite em cada profundidade.
O critério prático é avaliar as camadas separadamente, em vez de considerar o sinal de atenção igualmente útil em toda a profundidade do modelo.