
Diversidade na entrada, não no raciocínio: comparação de métodos de aumento de dados de teste para LLMs
O estudo compara fontes de variabilidade na inferência de LLMs — paráfrases do prompt, alterações na grafia e transformações de imagens — com o mesmo número de chamadas. Em seis benchmarks, preservar o significado proporcionou o maior ganho de precisão, enquanto o ruído ao nível dos caracteres e as perturbações simultâneas de duas modalidades se revelaram menos úteis.
Duas fontes de diversidade: entrada e raciocínio
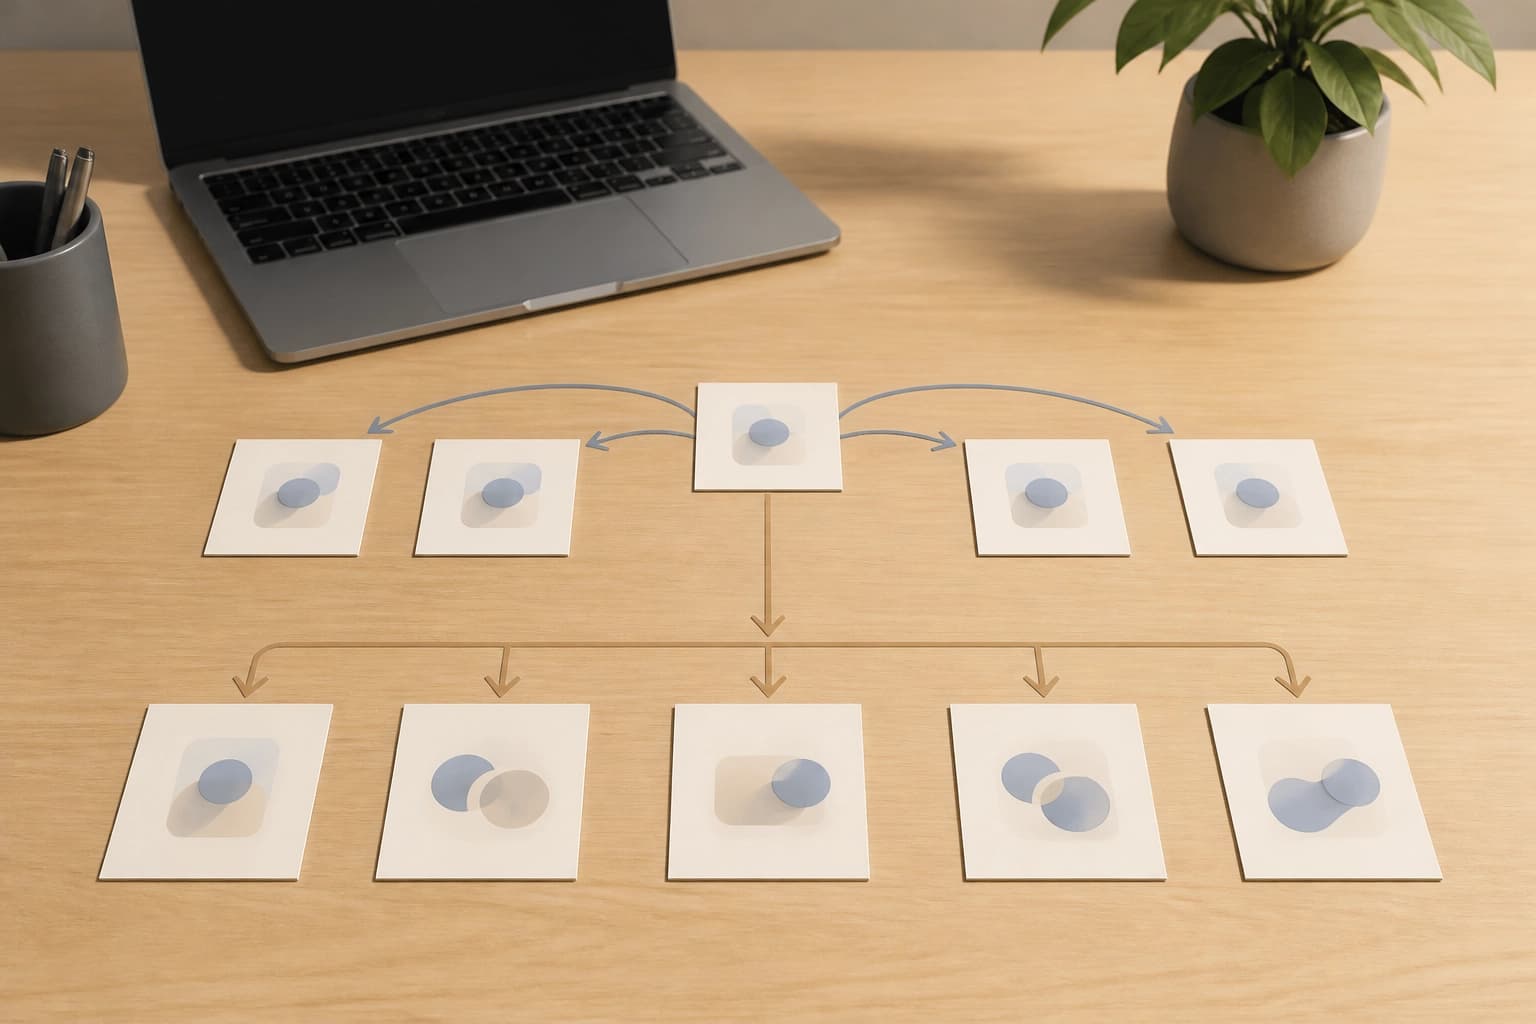
Test-Time Augmentation (TTA) combina previsões de versões transformadas dos dados de entrada. A diversidade é criada ao parafrasear a pergunta, alterar a grafia ou transformar as imagens associadas. A autoconsistência funciona de outra forma: altera apenas o percurso de raciocínio e reutiliza uma entrada fixa.
| Método | Fonte de diversidade |
|---|---|
| TTA | versões transformadas dos dados de entrada |
| Autoconsistência | percurso de raciocínio com entrada fixa |
A TTA testa a robustez a alterações na entrada. A autoconsistência testa a robustez do raciocínio com uma única entrada. A escolha depende da fonte de diversidade necessária para a tarefa.
Porque é que a igualdade no número de chamadas de inferência altera a conclusão
Os autores compararam variantes em seis benchmarks. O número de chamadas de inferência foi igual. Esta condição separa o efeito da fonte de diversidade do efeito de computação adicional.
- seis benchmarks;
- número igual de chamadas;
- comparação de fontes, não de volume.
Os autores relatam que a fonte de diversidade é mais importante do que a sua quantidade. Conclusão para a escolha: vale a pena comparar os métodos com um número igual de chamadas. Caso contrário, o aumento da precisão pode ser atribuído à fonte, e não às chamadas adicionais.
Paráfrase: ganho e pico precoce
Parafrasear a entrada sem alterar o significado proporcionou o maior ganho de precisão. O ganho foi de +1,80 pontos percentuais em relação a uma única chamada. A precisão máxima foi alcançada com o menor número de amostras.
Para modelos de gama média, como Claude Haiku, alterar a formulação da pergunta revelou-se uma utilização mais eficaz de uma chamada de inferência do que alterar o percurso de raciocínio.
Conclusão prática: se a transformação preservar o significado, a paráfrase é a primeira opção para TTA. Proporciona tanto um ganho como um pico precoce.
Ruído ao nível dos caracteres: muitas divergências, pouco benefício
O ruído ao nível dos caracteres provocou mais divergências entre as respostas: 37,8% contra 27,4%. O ganho de precisão foi menor. Uma grande variação nas respostas não significa que a agregação seja benéfica.
As divergências após a distorção do significado são erradas. Essas divergências não fornecem um sinal útil para a agregação.
Conclusão prática: avaliar a precisão, não apenas a proporção de divergências. O ruído ao nível dos caracteres não substitui as transformações que preservam o significado.
Perturbação dupla: quando a combinação fica aquém
A perturbação simultânea de duas modalidades produziu um resultado inferior ao nível de base de uma única chamada. A combinação de transformações não garante uma melhoria.
- perturbação simultânea de duas modalidades;
- resultado inferior ao nível de base de uma única chamada;
- avaliação separada da combinação.
Conclusão prática: só vale a pena combinar modalidades após uma comparação separada. Caso contrário, a TTA pode ficar abaixo do resultado de uma única chamada.
Escolha prática do método
Os critérios de escolha baseiam-se na fonte de diversidade, na preservação do significado e no número igual de chamadas.
| Tarefa | Método |
|---|---|
| Testar a robustez à formulação | TTA com paráfrase |
| Testar a robustez do raciocínio com a mesma entrada | autoconsistência |
| Avaliar a sensibilidade à grafia | TTA com ruído ao nível dos caracteres |
| Combinar modalidades | apenas após uma comparação separada |
Critério prático: escolher a fonte de diversidade de acordo com a tarefa. Para melhorar a precisão com TTA, a paráfrase proporciona o maior efeito medido. Para testar o raciocínio com a mesma entrada, a autoconsistência continua a ser a opção.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Verificação de alucinações em LLMs com uma representação SQL das fontes, sem ajuste fino
Este trabalho avalia se uma LLM consegue recorrer a uma competência simbólica básica — construir uma base de dados SQL a partir de documentos de origem — para fundamentar as respostas nas fontes sem supervisão na deteção de alucinações. No RAGTruth e no DiaHalu, este pipeline neuro-simbólico revela-se mais preciso do que a previsão direta e comparável aos métodos mais avançados, sem exigir afinação específica ao domínio.
9 novembro 2026
MathAdv: o que esconde a precisão final das provas geradas por máquina
Um conjunto de tarefas de diagnóstico em 13 áreas da matemática de nível universitário e de pós-graduação avalia sistemas de demonstração automática em Lean 4 não só pelo resultado final, mas também pelo domínio da matéria, pela qualidade do raciocínio informal e pela robustez perante reformulações das condições. A análise por componente mostra que traduzir um problema para uma forma formal continua a ser o principal obstáculo, e que o sucesso depende muito da área da matemática e da forma como o problema é formulado.
9 novembro 2026
AffordanceWAM: affordances como intermediárias entre a previsão da cena e o controlo do manipulador
O trabalho descreve um modelo generativo que prevê simultaneamente observações RGB futuras, campos escalares, mapas de calor de affordances e comandos contínuos para o robô, usando vídeos humanos para ampliar a diversidade das interações sem anotações de ações nem retargeting. No RoboCasa, no CALVIN ABC→D e em tarefas reais, a abordagem apresenta ganhos consistentes em relação às linhas de base que usam apenas RGB e apenas dados robóticos.
9 novembro 2026