
AffordanceWAM: affordances como intermediárias entre a previsão da cena e o controlo do manipulador
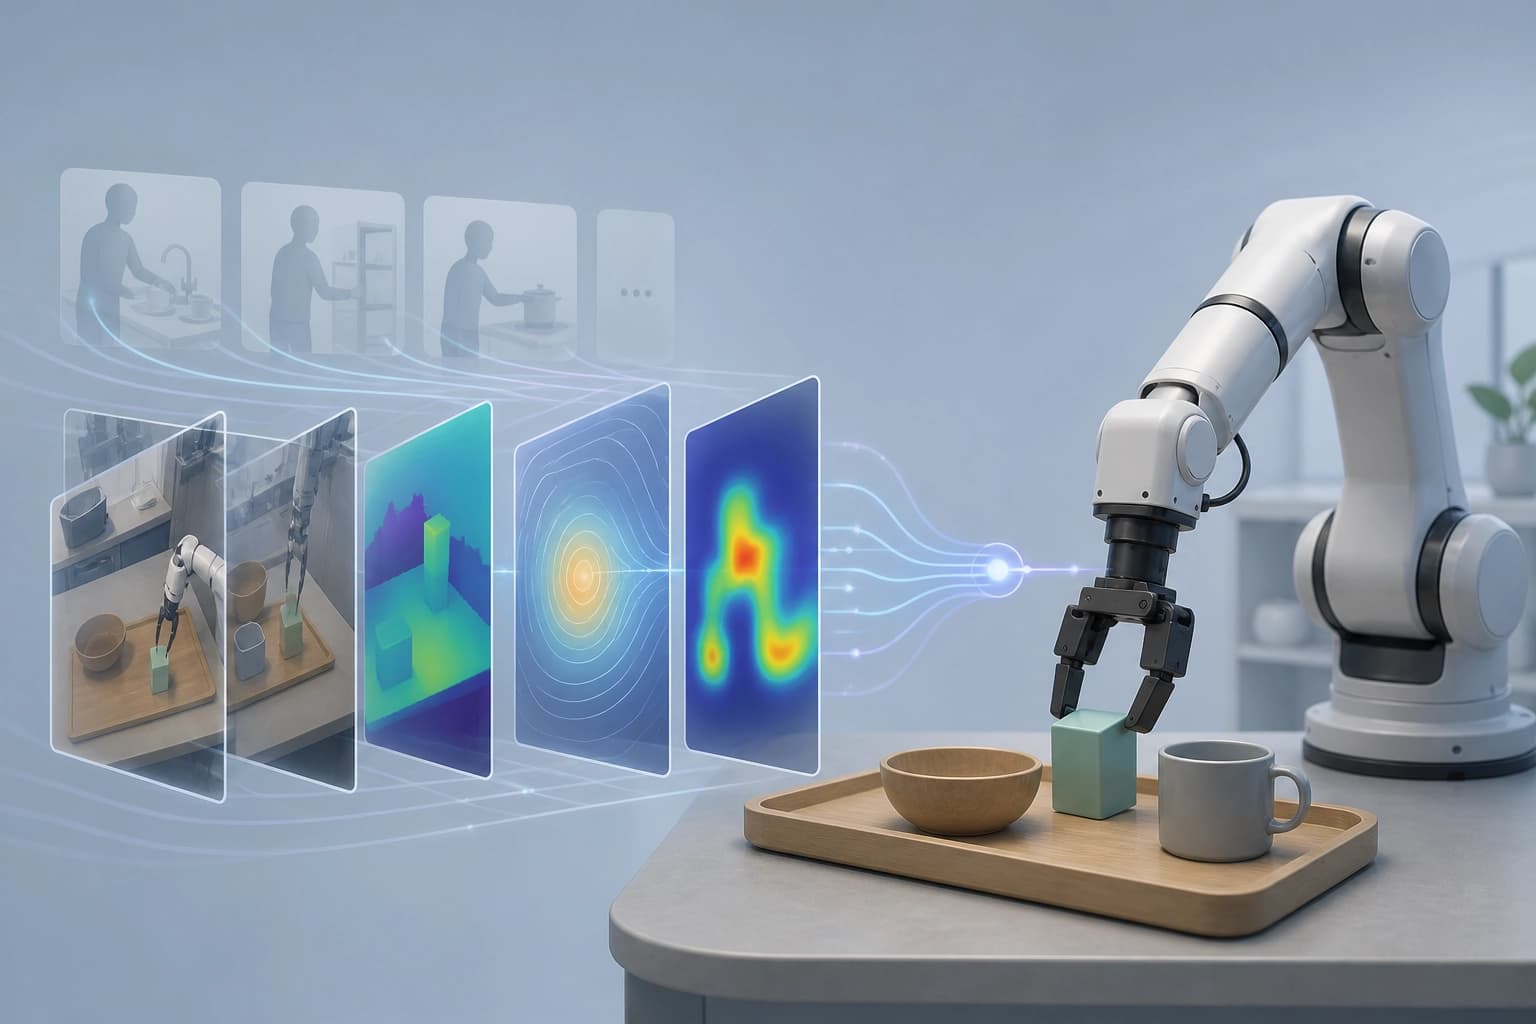
O trabalho descreve um modelo generativo que prevê simultaneamente observações RGB futuras, campos escalares, mapas de calor de affordances e comandos contínuos para o robô, usando vídeos humanos para ampliar a diversidade das interações sem anotações de ações nem retargeting. No RoboCasa, no CALVIN ABC→D e em tarefas reais, a abordagem apresenta ganhos consistentes em relação às linhas de base que usam apenas RGB e apenas dados robóticos.
O que é o modelo
O artigo arXiv:2609.22332 apresenta AffordanceWAM — um World Action Model generativo, consciente de affordances, para manipulação robótica. A primeira versão foi submetida em 16 Sep 2026. A versão mais recente indicada é a v3, revista em 18 Oct 2026. O modelo representa affordances espácio-temporais centradas nos objetos. Utiliza dois formatos:
- Scalar Affordance;
- Affordance Heatmap.
Estas representações estão integradas no futuro World gerado. As affordances ligam a previsão visual aos objetos e às áreas de interação relevantes para a tarefa. Servem de base comum às interações em vídeos de pessoas e robôs. Assim, as affordances tornam-se uma ponte entre a previsão da cena e o controlo do manipulador.
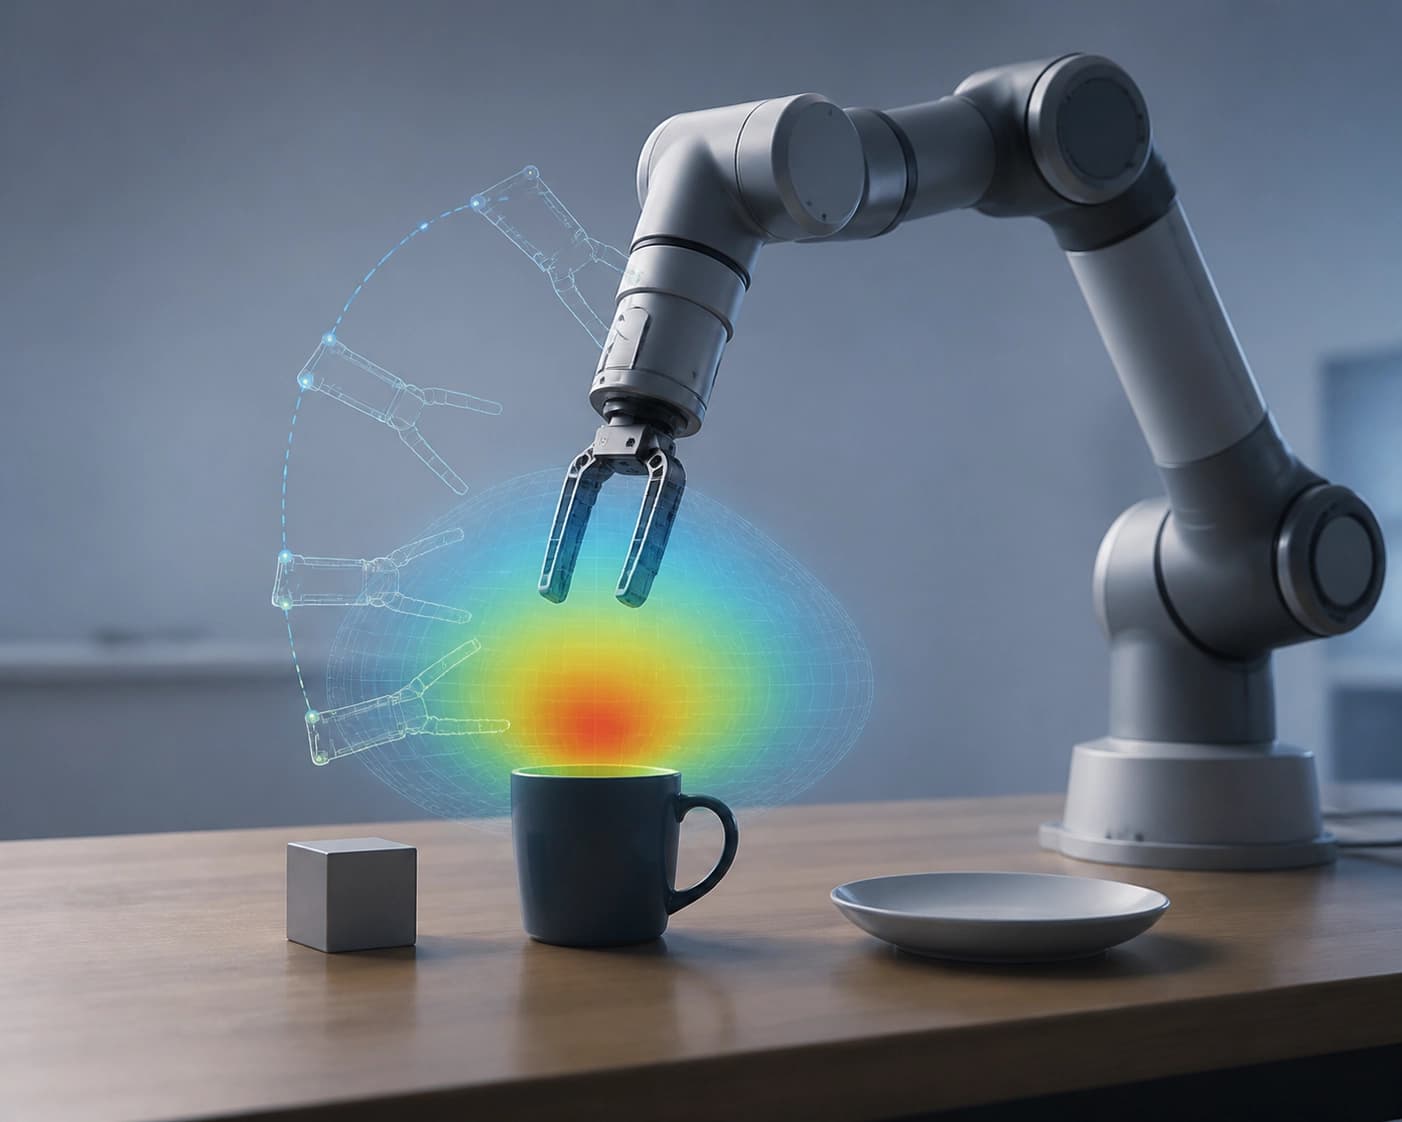
Conclusão: o modelo proporciona um formato explícito para objetos e áreas de ação. Esse formato liga a previsão do futuro ao controlo.
Arquitetura: dois especialistas e um objetivo comum
O AffordanceWAM assenta num Transformer de difusão de vídeo pré-treinado. O modelo utiliza um World Expert e um Action Expert com parâmetros separados. Estes são ligados por Masked Joint Self-Attention.
| Elemento | Função segundo a descrição do artigo |
|---|---|
| World Expert | especialista do mundo com parâmetros separados |
| Action Expert | especialista em ações com parâmetros separados |
| Masked Joint Self-Attention | liga o World Expert e o Action Expert |
| Objetivo comum de flow matching | combina a previsão de RGB, affordances e ações |
O modelo prevê em conjunto observações RGB futuras, campos Scalar Affordance, Affordance Heatmaps e ações robóticas contínuas. Todas estas saídas são combinadas num objetivo comum de flow matching. Os parâmetros separados dos especialistas não impedem o treino conjunto. A ligação entre eles permite a previsão conjunta do mundo e da ação.
Conclusão: a arquitetura separa os parâmetros do mundo e das ações. Ao mesmo tempo, Masked Joint Self-Attention e o objetivo comum mantêm a previsão conjunta.
Treino com vídeos de pessoas e trajetórias de robôs
O treino do AffordanceWAM utiliza vídeos de pessoas para os três fluxos do futuro World. As trajetórias de robôs acrescentam supervisão de ações. A transferência não requer rótulos de ações humanas nem retargeting.
| Fonte de dados | Contributo para o treino |
|---|---|
| Vídeos de pessoas | treinam os três fluxos do futuro World |
| Trajetórias de robôs | acrescentam supervisão de ações |
As affordances servem de base comum às interações em vídeos de pessoas e robôs. Assim, os vídeos de pessoas podem ser utilizados sem rótulos de ações humanas. Os autores descrevem a affordance como uma interface eficaz para a transferência de competências de vision-language-action e de pessoas para robôs.
Conclusão: as affordances proporcionam uma interface comum para vídeos de pessoas e robôs. Isto elimina a necessidade de rótulos de ações humanas e de retargeting.
Experiências: ganhos e dependência dos dados
Os autores avaliaram o AffordanceWAM no RoboCasa, no CALVIN ABC→D e em tarefas de manipulação no mundo real. As experiências mostram ganhos consistentes em relação aos métodos de referência. Os métodos de referência utilizam apenas RGB ou apenas dados de robôs.
No RoboCasa, os resultados melhoram de forma monotónica à medida que aumenta o volume de vídeos de pessoas anotados com affordances. Isto acontece mantendo fixo o volume de supervisão de robôs. Este efeito indica o contributo das affordances para o treino.
| Condição | Resultado segundo o artigo |
|---|---|
| Método de referência apenas com RGB | ganhos consistentes do AffordanceWAM |
| Método de referência apenas com dados de robôs | ganhos consistentes do AffordanceWAM |
| Mais vídeos de pessoas com affordances, mantendo fixa a supervisão de robôs | melhoria monotónica no RoboCasa |
Um critério prático de escolha é o volume de vídeos de pessoas com anotações de affordances. Mantendo fixa a supervisão de robôs, o aumento desse volume proporciona uma melhoria monotónica no RoboCasa.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
MathAdv: o que esconde a precisão final das provas geradas por máquina
Um conjunto de tarefas de diagnóstico em 13 áreas da matemática de nível universitário e de pós-graduação avalia sistemas de demonstração automática em Lean 4 não só pelo resultado final, mas também pelo domínio da matéria, pela qualidade do raciocínio informal e pela robustez perante reformulações das condições. A análise por componente mostra que traduzir um problema para uma forma formal continua a ser o principal obstáculo, e que o sucesso depende muito da área da matemática e da forma como o problema é formulado.
9 novembro 2026
Edição de apresentações como operações controláveis: framework EditPPT e benchmark DeckEdit-Bench
Os autores analisam a edição de slides em termos de objetos específicos, ações permitidas e verificação de que o conteúdo não relacionado permaneceu intacto, em vez de geração livre de código. Para avaliar a qualidade, foi criado o DeckEdit-Bench (183 tarefas em 28 apresentações feitas por pessoas), e o sistema multiagente EditPPT, baseado em cinco modelos-base, apresenta uma taxa de sucesso de 66,7–74,9% das tarefas, com preservação acima de 97%.
8 novembro 2026
Geometria não euclidiana de fatores: o mapa FactoMap para separar representações
É proposta uma forma de descrever o espaço dos fatores por meio de regiões, identificações definidas pelo gerador e escalas locais, permitindo distinguir casos topologicamente próximos, mas com geometrias diferentes. O método FactoMap aprende protótipos interpretáveis numa grelha estruturada e, em experimentos, demonstra uma preservação mais robusta da continuidade e da separação dos fatores.
8 novembro 2026