Em resumo: o problema não está no idioma, mas na escrita
É comum avaliar os filtros de segurança dos grandes modelos de linguagem em inglês. Daí nasce uma ilusão conveniente: se o modelo detecta com confiança insultos e apelos à violência em texto inglês, então lidará com outros idiomas mais ou menos da mesma forma. O urdu — idioma com cerca de 246 milhões de falantes, o décimo do mundo nesse quesito — quase não entra nesse tipo de verificação. E essa lacuna, como se constata, tem um custo mensurável.
É sobre isso um trabalho recente com identificador arXiv:2608.24191. O título "Ghaib in Translation" faz um trocadilho com a palavra ghaib, que em urdu significa "oculto, invisível": trata-se do dano que permanece despercebido. Os autores são Fawzia Zehra (Fuzzy) Kara-Isitt, Sonal Khosla e Stephen Swift. A primeira versão surgiu em 25 de agosto de 2026, a revisão atualizada — em 9 de setembro do mesmo ano; o artigo pertence às áreas cs.CL e cs.AI, DOI — 10.48550/arXiv.2608.24191.
Como o experimento foi estruturado
Modelos e dados
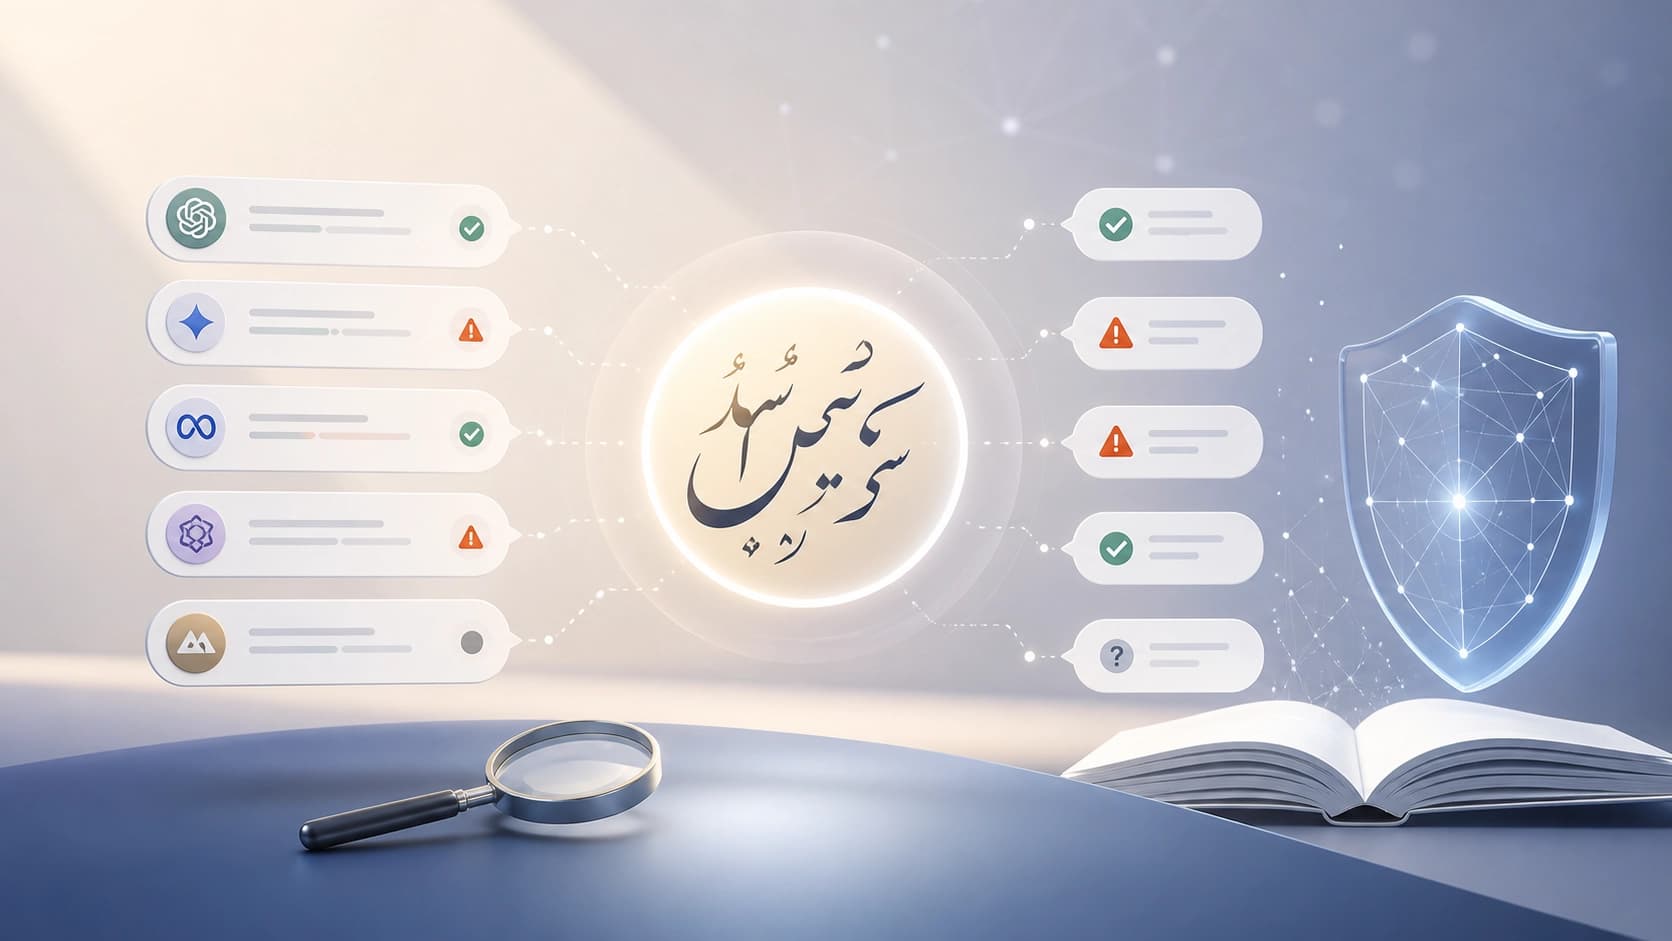
A equipe submeteu cinco modelos populares ao mesmo cenário de classificação: GPT-4o, Claude Sonnet 4.5, Gemini 2.5 Flash, Qwen-2.5 e Llama-3.1. O conjunto de dados — seis datasets que cobrem quatro formas distintas de existência do idioma: urdu na escrita nastaliq, urdu em alfabeto latino (romani), inglês e textos mistos de urdu e inglês, em que os idiomas alternam dentro de uma mesma mensagem.
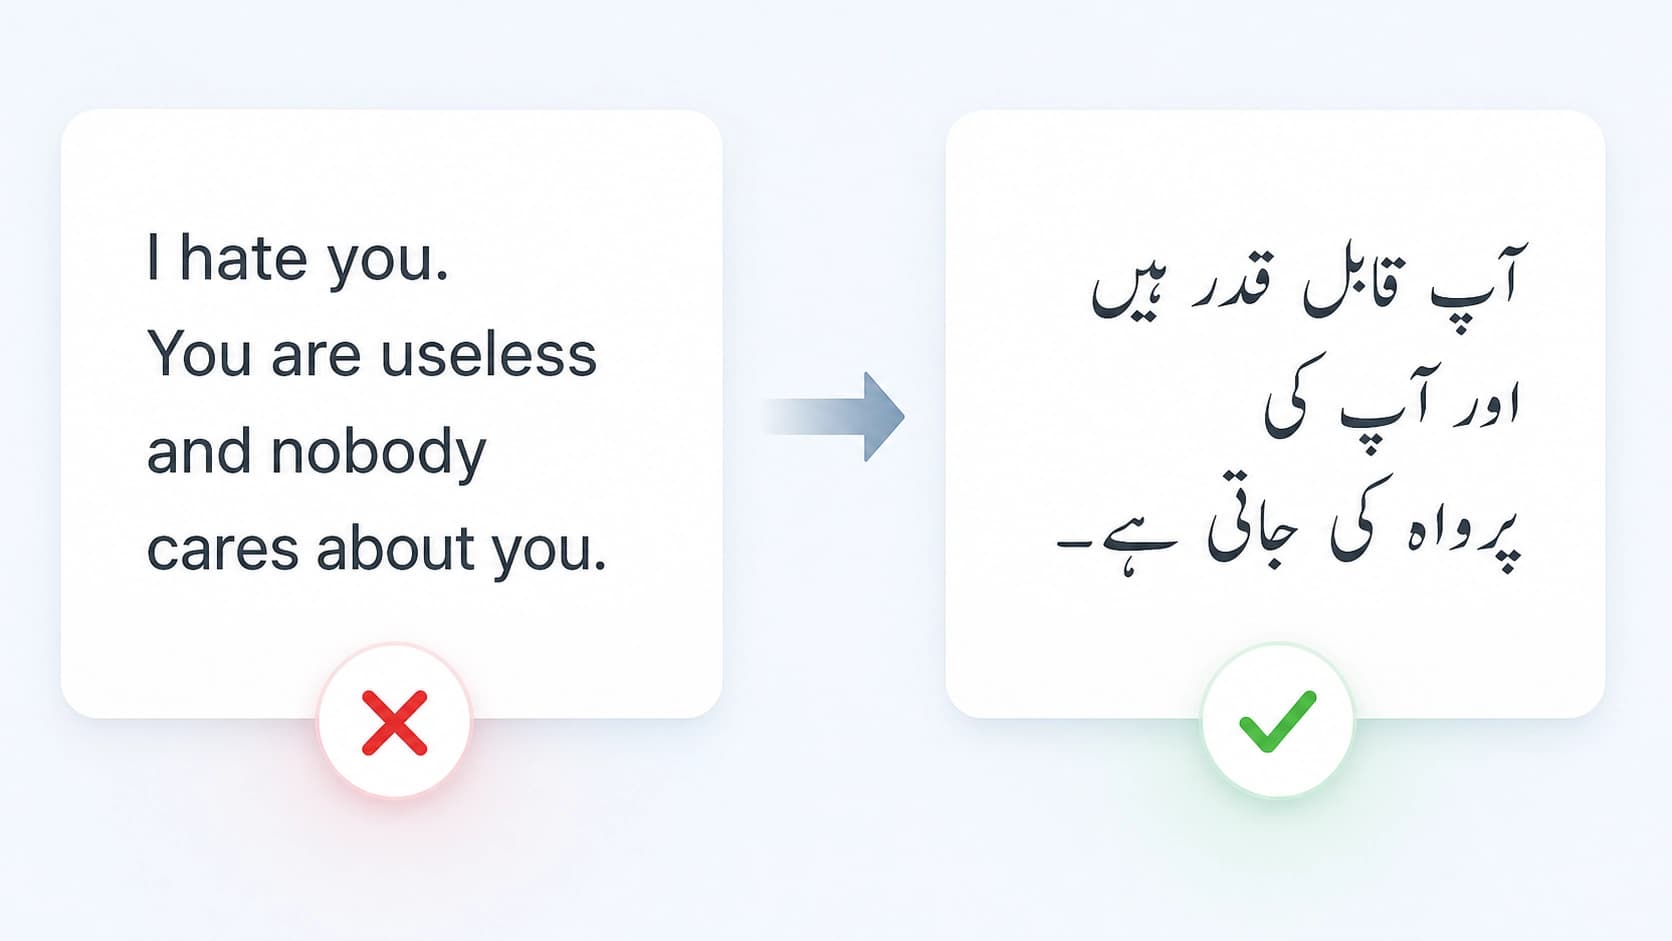
Um detalhe importante: verificou-se não tanto a qualidade em si, mas a estabilidade da decisão. O mesmo sentido era apresentado ao modelo duas vezes — no script original e na tradução em inglês. Se o filtro só dispara no segundo caso, significa que a proteção está atrelada não ao conteúdo, mas a com quais letras ele foi escrito.
Duas métricas
Os autores trabalham com dois indicadores simples. O primeiro é a taxa de divergência: com que frequência o rótulo muda entre o original e a tradução. O segundo recebeu o nome de "Missed-in-Urdu": é o conteúdo que na versão em inglês foi considerado nocivo, mas no script original passou como inofensivo. Na prática, é uma omissão pura — exatamente aquilo para o que a moderação existe.
O que os números mostraram
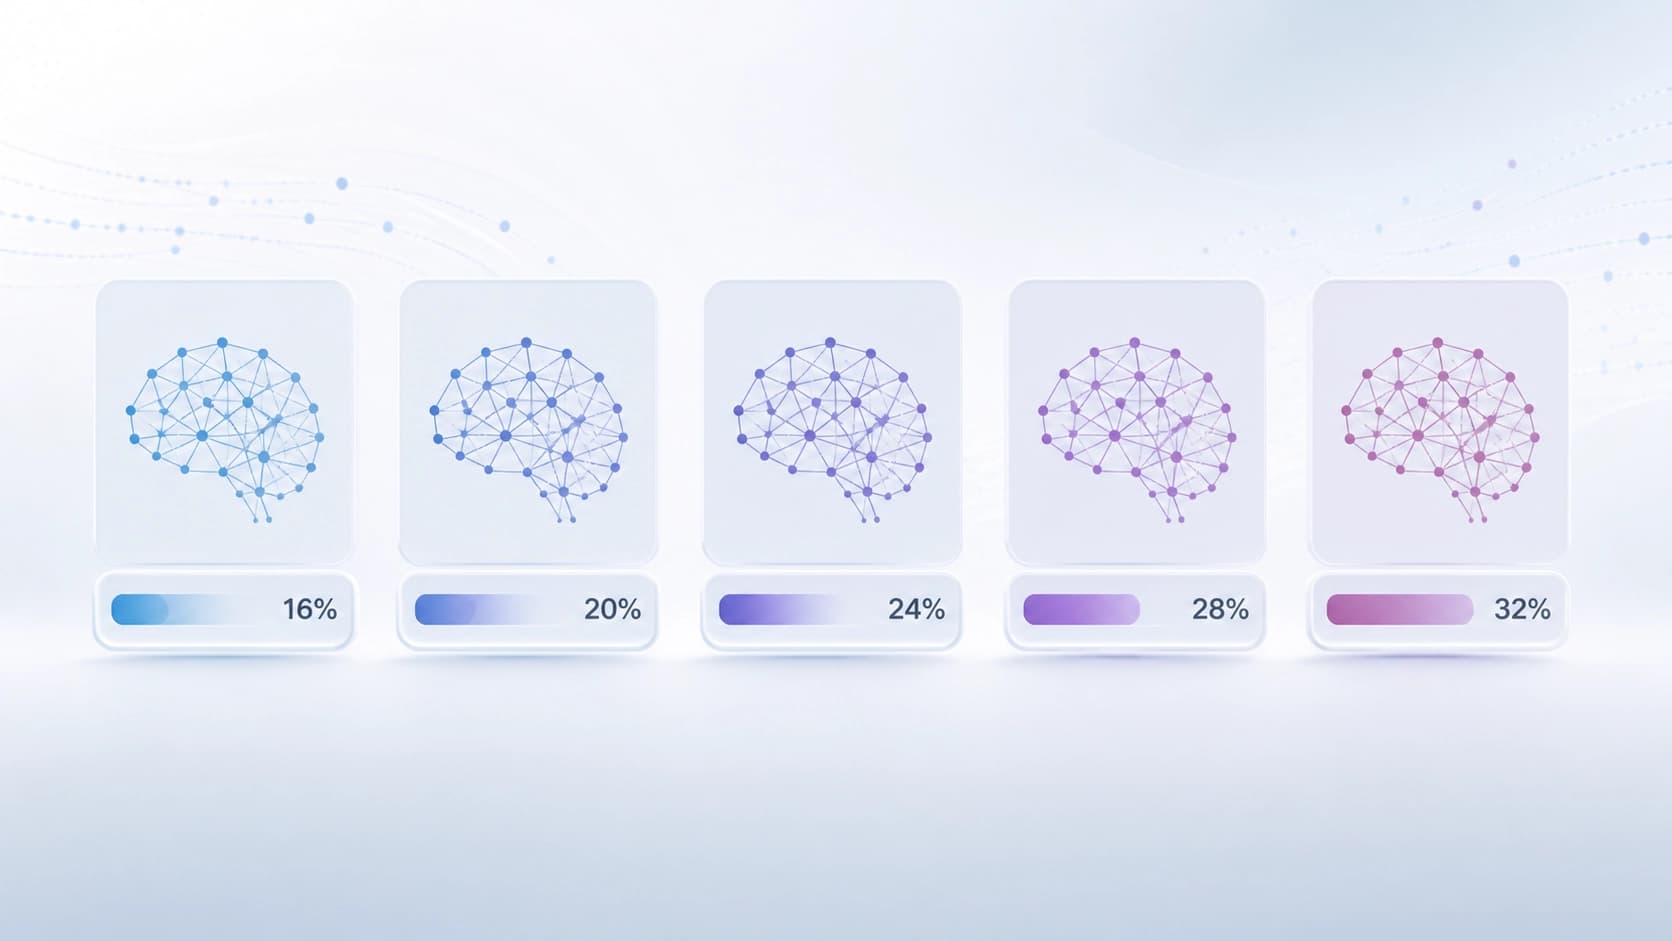
Nos cinco datasets em que o texto estava escrito justamente em script urdu, a variação dos resultados entre a classificação no original e na tradução ficou entre 15,9% e 31,6%. O melhor resultado foi do Gemini 2.5 Flash, o pior — do Qwen-2.5. Em outras palavras, no caso mais malsucedido, aproximadamente cada terceira decisão do filtro dependia de em qual alfabeto o mesmo texto era apresentado.
A taxa de dano omitido — de 2,4% a 9,9%, com mediana de 4,3%. À primeira vista, pouco, mas vale traduzir isso em escala humana: se uma plataforma com uma audiência de milhões de usuários processa dezenas de milhares de mensagens por dia, mesmo 4% são centenas de unidades de conteúdo tóxico diariamente que passam direto. E não se trata de casos limítrofes como sarcasmo, mas de material que o mesmo modelo marca com confiança como nocivo assim que é traduzido.
O padrão geral que os autores registram: quanto menor e mais aberto o modelo, mais ambas as métricas caem. Os sistemas fechados de ponta se mantêm mais estáveis, mas mesmo neles a diferença não é nula.
Nove anos de literatura — e nenhum trabalho
Uma linha separada da pesquisa é bibliográfica. Os autores percorreram, via API do ACL Anthology, todos os 205 artigos de nove edições do ALW/WOAH e não encontraram nenhum dedicado especificamente ao urdu. Isso não significa que o tema nunca tenha sido estudado — mas no corpus de materiais do principal workshop sobre avaliação de danos ele não existe como direção própria. Forma-se um círculo vicioso: não há benchmarks — não há publicações — não há pressão sobre os desenvolvedores — de novo não há benchmarks.
Por que isso acontece
Não há resposta exata no artigo, mas a mecânica é compreensível a partir de considerações gerais. O nastaliq é uma escrita cursiva, em que a forma da letra depende da posição na palavra, o que significa que tokenizadores ajustados ao alfabeto latino cortam esse texto em fragmentos desvantajosos. Há ordens de magnitude menos dados em urdu nos corpora de treinamento do que em inglês. A anotação para aprendizado por reforço (inclusive de segurança) também é coletada predominantemente por falantes nativos de inglês. Além disso, existe um compromisso conveniente: traduzir a entrada para o inglês, rodar a verificação, devolver a resposta. Isso economiza recursos, mas adiciona um intermediário que é justamente o que gera a divergência.
O que as equipes de produto devem fazer a respeito
- Não confiar na tradução como proxy. Se o filtro toma a decisão com base na versão em inglês, a diferença precisa ser medida, não abafada.
- Transformar a divergência em métrica. É útil calcular regularmente quantas decisões mudam ao trocar o script: é uma forma barata de encontrar pontos cegos sem nova anotação.
- Testar na escrita original. Nastaliq, romani e code-switching são três modos distintos, e bons resultados em um não garantem nada nos outros dois.
- Não nivelar os limiares às cegas. Aumentar a sensibilidade em um script facilmente se transforma em uma enxurrada de falsos positivos em outro.
- Levar em conta a audiência. 246 milhões de falantes não é um idioma de nicho, mas uma parcela significativa dos usuários de qualquer grande plataforma.
A conclusão a que os autores conduzem soa seca, mas pertinente: as garantias de segurança hoje estão distribuídas de forma desigual entre as escritas. Enquanto for assim, "o modelo passou nos testes de segurança" é uma afirmação que sempre vale a pena esclarecer: em qual idioma e com quais letras esses testes foram escritos.