
Controlo executivo de agentes LLM: transferir a avaliação do progresso e o poder de parar para fora do gerador poupa um terço dos tokens
O preprint descreve um modo em que, depois de atingir o objetivo, o agente de linguagem continua a fazer ajustes e verificações de pouca utilidade, explicando-o por um ciclo de autorreforço no qual a geração, a avaliação do progresso e a decisão de parar não estão separadas. A camada adicional de controlo global que tem em conta a incerteza mantém a taxa de sucesso em cerca de 96,6% e, ao mesmo tempo, reduz o consumo médio de tokens em 36,4%, embora as conclusões tenham sido obtidas até agora em simulações mecanísticas.
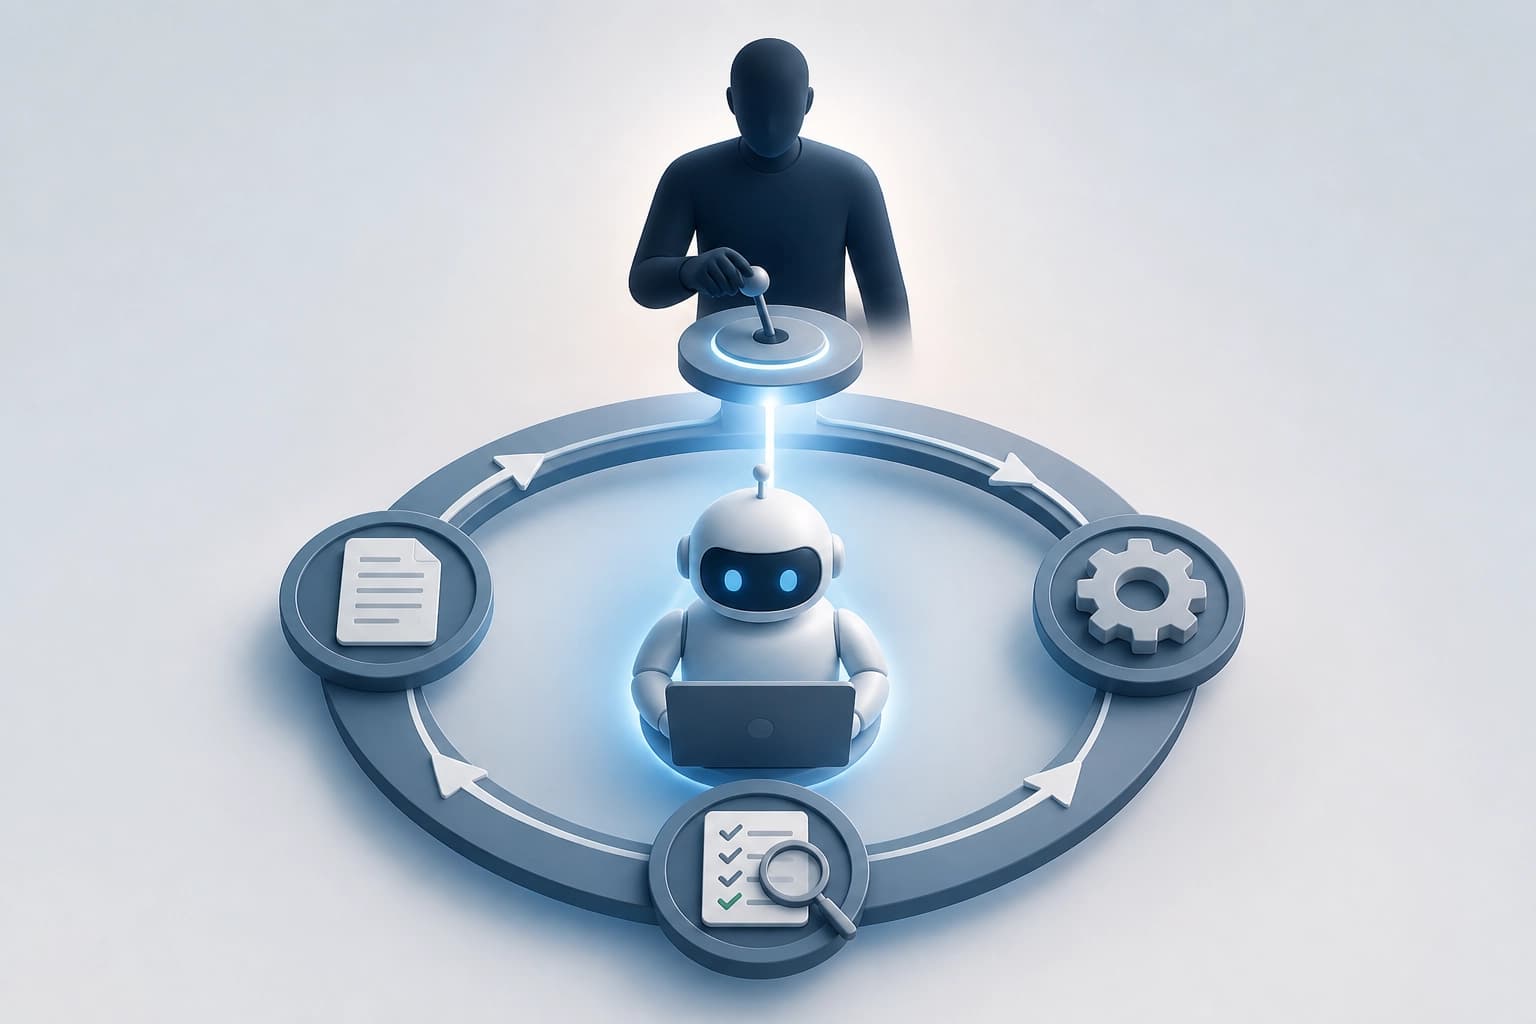
O que é LLM Parkinsonism
O termo LLM Parkinsonism é usado como uma metáfora não clínica e restrita. Descreve a continuação persistente de ações quando o seu valor para a tarefa diminui.
Características deste comportamento:
- o agente continua a agir depois de atingir o objetivo inicial;
- realiza melhorias de baixo valor;
- inicia verificações repetidas;
- corrige a complexidade que ele próprio criou.
Conclusão: a metáfora aponta para uma falha de controlo, não para uma analogia clínica.
Porque é que o autocontrolo num único circuito agrava o problema
Os autores associam o problema não só à previsão autorregressiva do próximo token. A causa também está na concentração de quatro funções num único circuito.
- geração de propostas;
- interpretação do âmbito da tarefa;
- avaliação do progresso;
- autoridade para parar.
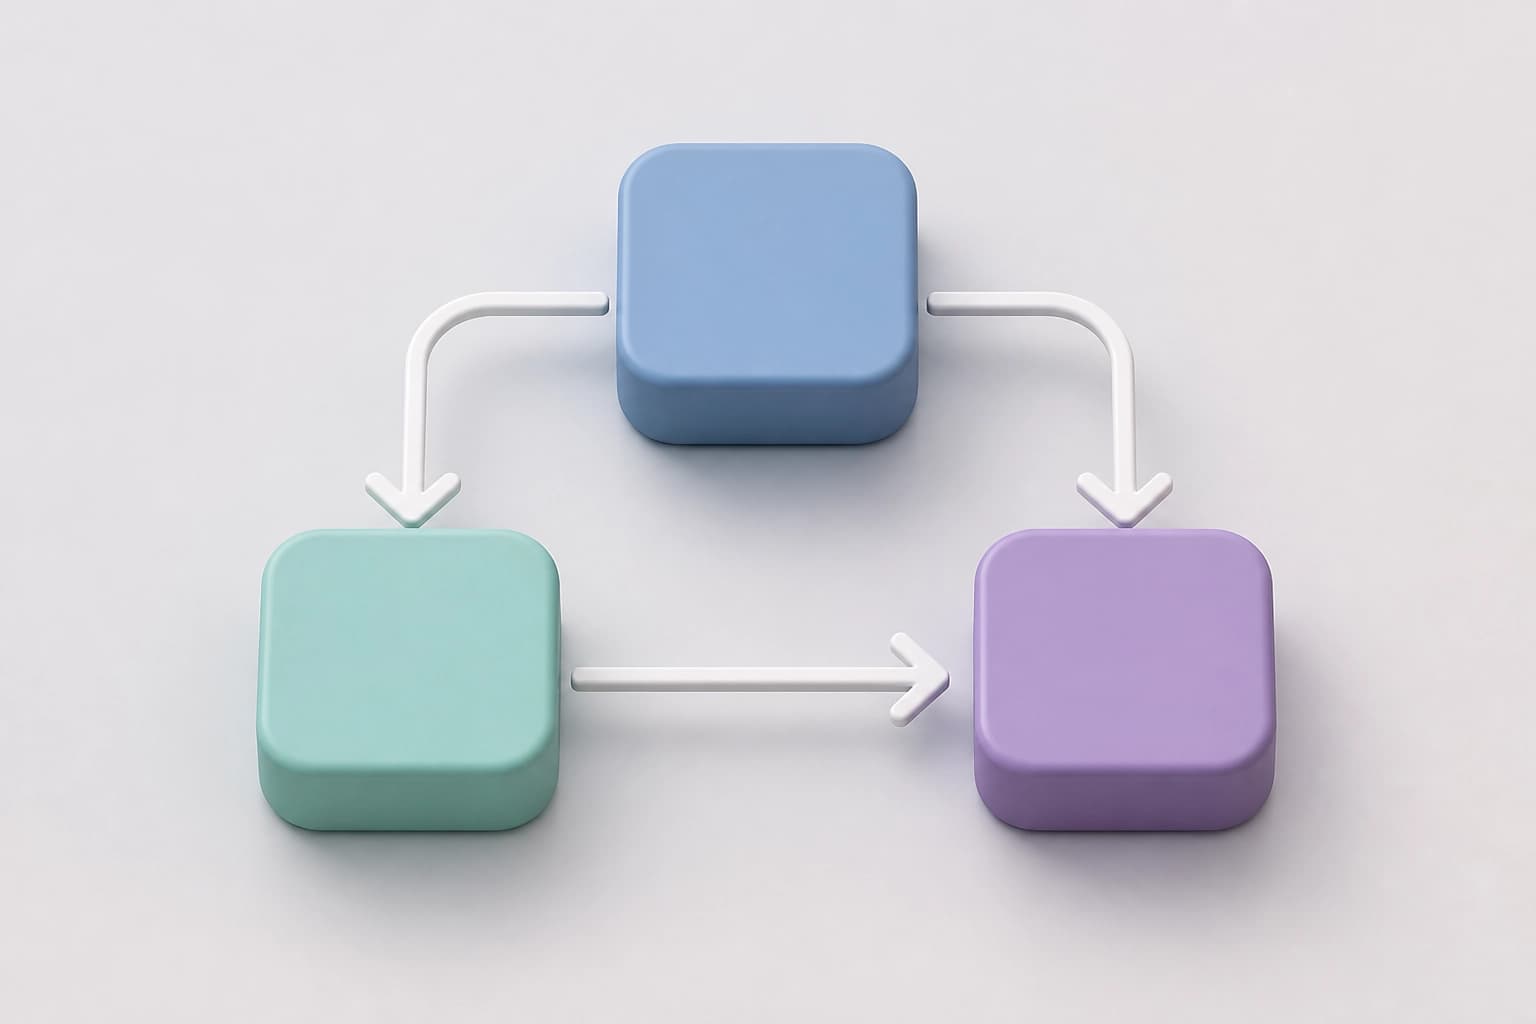
Este circuito funciona com autorreforço. A avaliação, a geração e a paragem influenciam-se mutuamente.
Conclusão: para quebrar o autorreforço, é preciso colocar algumas funções fora do gerador.
Global Executive Control: o que é colocado fora do gerador
Global Executive Control (GEC) v0.2 é uma arquitetura de controlo que tem em conta a incerteza. Separa a geração de ações do controlo ao nível do projeto.
São colocados fora do gerador:
- âmbito da tarefa;
- evidências;
- consumo de recursos;
- paragem.
O controlo ao nível do projeto tem autoridade para parar e avaliar o progresso. O gerador é responsável pelas ações.
Conclusão: o critério prático é que a avaliação do progresso e a paragem devem estar fora do circuito de geração.
O que mostram as medições
O benchmark incluiu 24 000 episódios com candidatos comparáveis e um limite total de 40 000 tokens. Foram comparadas três variantes.
| Variante de controlo | Sucesso perante o objetivo rigoroso |
|---|---|
| Base com o primeiro candidato | 67,42% |
| Controlo local com conjunto de candidatos | 96,53% |
| GEC | 96,57% |
O acesso a várias opções de ação explica a maior parte do aumento do sucesso. A GEC manteve a taxa de sucesso e reduziu a utilização média de tokens.
- utilização média de tokens: de 19 782 para 12 574 (36,4%);
- número médio limitado de tokens até à conclusão, com um limite de 40 000 tokens: de 16 136 para 13 114 (18,7%).
A GEC eliminou a deriva medida antes da conclusão da tarefa e reduziu drasticamente a complexidade excessiva. A sensibilidade aos custos indiretos do controlo manteve-se favorável mesmo com a adição de até 500 tokens sintéticos de controlo por ciclo.
Conclusão: o principal aumento do sucesso deve-se ao conjunto de candidatos; a GEC acrescenta poupança de tokens e controlo da complexidade.
Critérios práticos para escolher um controlo
Vale a pena verificar cinco condições:
- a avaliação externa do progresso está separada do gerador;
- a autoridade para parar está fora do circuito de geração;
- estão disponíveis várias opções de ação;
- o consumo de recursos é tido em conta;
- a incerteza é tida em conta.
Conclusão: se estas funções permanecerem dentro do gerador, persiste o risco de melhorias de baixo valor e de utilização desnecessária de tokens.
Limitações e o que verificar a seguir
Os resultados foram obtidos em simulações mecanísticas. Os autores consideram que sustentam o controlo explícito do âmbito da tarefa, das evidências, do consumo de recursos e da paragem.
Limitações:
- continua a ser necessário testar em modelos reais;
- as simulações mecanísticas não substituem esses testes.
Conclusão: o princípio arquitetónico parece fundamentado, mas não é possível extrapolar os números para LLM reais sem os testar.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Avaliação de agentes de programação no desenvolvimento XR interativo: resultados do GenXR-Bench
Foi publicado o GenXR-Bench, um conjunto de 112 tarefas especializadas para avaliar de ponta a ponta agentes de programação no desenvolvimento interativo de XR: desde o aprimoramento de funcionalidades e a correção de defeitos até a criação de aplicações com verificação do comportamento em dispositivos de consumo. Entre os dez modelos testados, o melhor resultado foi de 50,9% no Pass@1; entre as falhas recorrentes estão o processamento de eventos assíncronos de sensores, a ancoragem de objetos no espaço real e a compreensão das interações em contextos físicos.
5 novembro 2026
Da recompensa escalar à fronteira de Pareto: síntese de RTL com aprendizagem por reforço multiobjetivo
É proposto um método para treinar um modelo de linguagem a gerar não apenas um esquema, mas um conjunto de candidatos RTL com diferentes compromissos entre área, latência e consumo de energia; a recompensa é calculada com base na contribuição de cada variante para o hipervolume da fronteira de Pareto. No RTLLM v2, o hipervolume relativo aumentou 13,3 p.p. em relação à versão de base sem otimização de PPA e 14,4 p.p. em relação ao treinamento por reforço com um único objetivo.
5 novembro 2026
Os LLM médicos sabem que as recomendações foram revistas, mas muitas vezes respondem de acordo com as regras anteriores
Um estudo da ChronoEvo sobre 1709 alterações às recomendações clínicas mostra que, no modelo principal, 90,8% das respostas assinalavam a novidade, mas apenas 58,5% a aplicavam na íntegra, e a diferença de 32,3 pontos percentuais persistia em 14 modelos. Mesmo aumentar a visibilidade das atualizações não trouxe um aumento significativo da incorporação integral das novas regras nas recomendações clínicas.
4 novembro 2026