
Sistema de pesquisa profunda agêntica em medicina: ICD-Deepresearch prevê futuros códigos CID
Uma nova abordagem combina modelos fundamentais baseados em prontuários eletrônicos de saúde (EHR) e modelos de linguagem com busca médica para prever antecipadamente os códigos de diagnóstico da próxima consulta. Nos conjuntos de dados MIMIC-III e MIMIC-IV, o sistema superou os comparadores locais, e os médicos avaliaram suas evidências como notavelmente mais úteis do que os resultados da busca autônoma do GPT-5.
Quando um médico se prepara para uma consulta, é útil compreender antecipadamente com o que, muito provavelmente, o paciente chegará. É exatamente essa tarefa que os sistemas de previsão de diagnósticos resolvem: com base no histórico de atendimentos anteriores, eles preveem os códigos CID que podem aparecer no prontuário na próxima visita. Uma das abordagens mais recentes é a busca profunda baseada em agentes, onde diferentes modelos trabalham em um pipeline de pesquisa unificado.
Qual é a tarefa?
Trata-se de previsão prospectiva multirrótulo. O sistema não classifica uma nota já existente: o registro futuro ainda não foi criado, portanto o modelo deve se basear apenas no histórico longitudinal do paciente. Além disso, pode haver vários códigos corretos, e eles podem se referir tanto a condições crônicas quanto a novas.
As soluções clássicas aqui geralmente se dividem em dois tipos. Modelos fundamentais estruturados, treinados em prontuários eletrônicos, capturam bem a recorrência de atendimentos e a dinâmica temporal das doenças. Modelos de linguagem, por outro lado, são fortes na construção de hipóteses flexíveis, próximas do raciocínio clínico. Mas, separadamente, eles perdem parte da informação.
No preprint no arXiv (2608.17075), é descrito o sistema ICD-Deepresearch, que tenta combinar ambas as abordagens. É um workflow de agentes: modelos preditivos trabalham em conjunto com busca médica e dicionários de códigos, e a resposta final é formada considerando conexões clínicas externas. A busca profunda aqui não é a exibição de links, mas uma investigação em múltiplas etapas: o próprio sistema decide quais fontes verificar e como relacioná-las ao histórico do paciente.
Como a previsão é estruturada
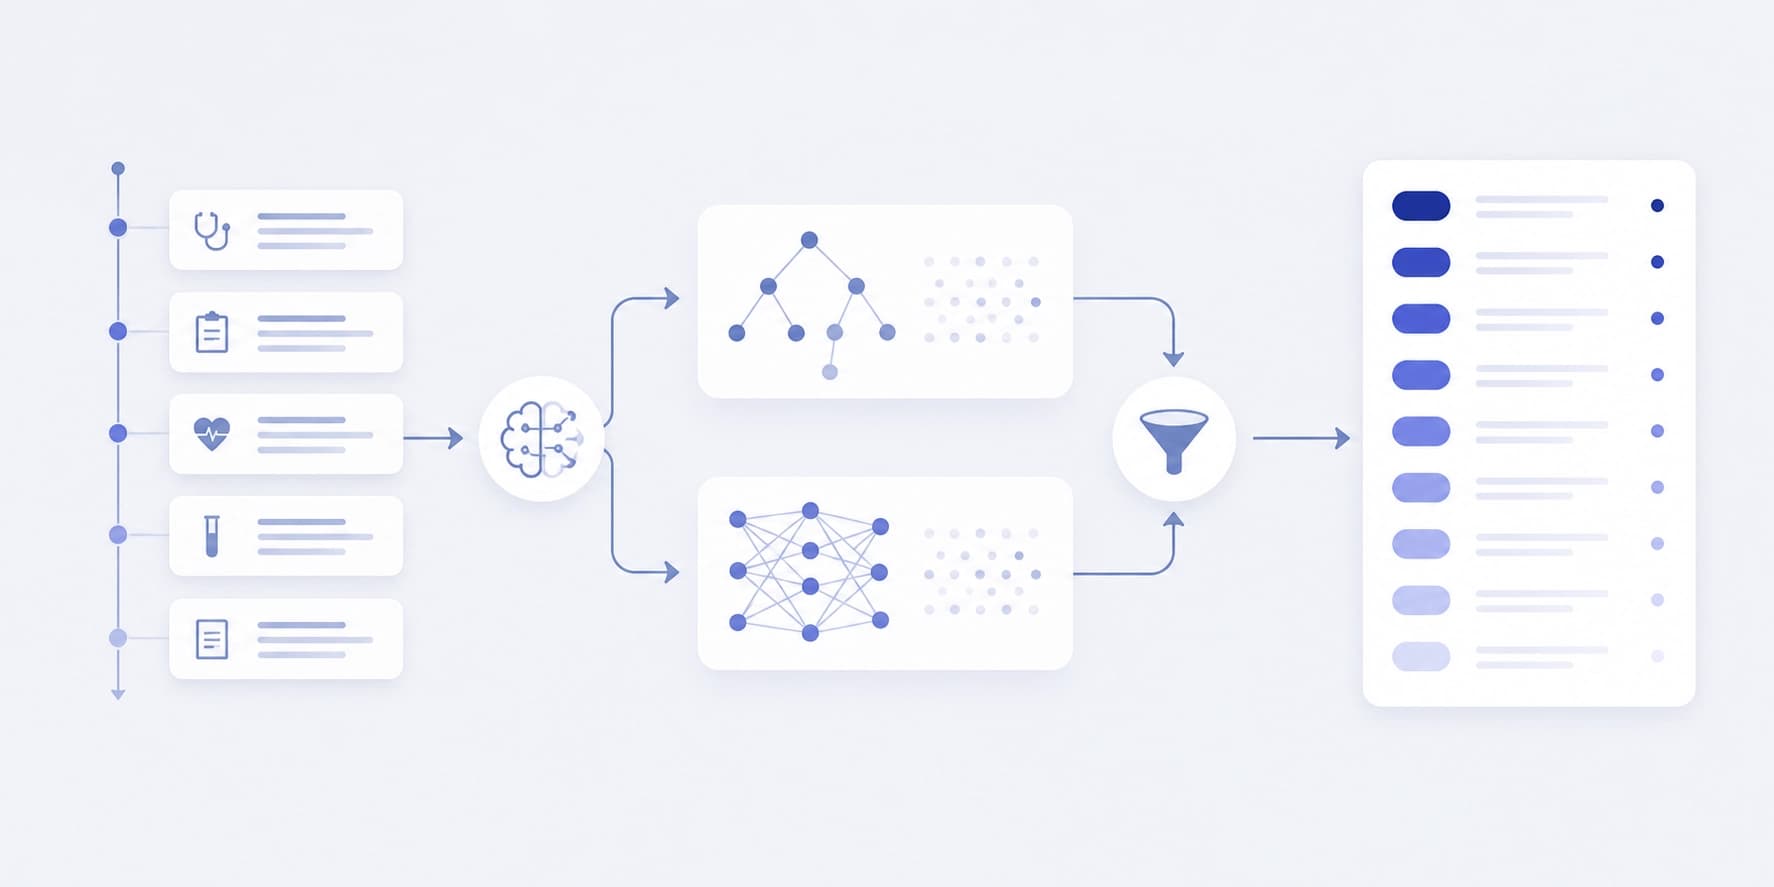
Nenhuma fonte de dados contém o "conjunto futuro" de códigos, portanto o sistema opera antecipadamente dentro de um orçamento top-K. Ele avalia possíveis transições do estado atual do paciente para diagnósticos futuros, usando três fontes de sinal: o próprio histórico médico, associações clínicas externas e a semântica precisa dos códigos CID.
Geração de candidatos
O primeiro circuito executa o modelo SparseEHR. Ele forma um prior de EHR — uma distribuição de probabilidade sobre os códigos, baseada em visitas anteriores. Esse prior se torna o ponto de partida para duas rodadas limitadas de research expansion: o sistema busca direcionadamente conexões clínicas adicionais em fontes externas, sem transformar a busca em uma varredura infinita.
Em paralelo, opera um caminho independente — a previsão direta com GPT-5. Ele fornece seu próprio conjunto de candidatos, que não depende do modelo sparse. Com isso, os dois métodos compensam os pontos fracos um do outro: um se apoia em estatística formalizada, o outro na compreensão linguística dos sintomas.
Seleção final
Os candidatos coletados passam por validação: o sistema remove duplicatas, verifica a conformidade com o dicionário CID e ranqueia conjuntamente ambas as fontes. Um módulo separado então elabora justificativas textuais, explicando por que determinado código entrou na lista. É importante que esse módulo não influencie as próprias previsões — ele apenas torna o resultado mais transparente para o médico.
O que os experimentos mostraram
A eficácia foi avaliada nos dados de terapia intensiva MIMIC-III e MIMIC-IV. Como pode haver vários códigos corretos, as métricas foram calculadas em média por paciente: isso é mais próximo da prática clínica real do que a contagem exata usual sobre todas as previsões.
- No MIMIC-III, a precisão foi de 24,60%, e o recall, de 35,09%.
- No MIMIC-IV — 25,14% e 48,32%, respectivamente.
O recall no MIMIC-IV é visivelmente maior: o sistema encontra com mais frequência os códigos realmente necessários, mesmo que não evite os desnecessários.
Separadamente, médicos avaliaram a utilidade dos documentos que o sistema recupera para confirmar a previsão. Aqui, o resultado do ICD-Deepresearch supera notavelmente as ferramentas autônomas: 51% e 68% dos documentos foram considerados úteis, contra 22% e 39% da busca web autônoma baseada em GPT-5 e 32% e 41% do Medical Deep Research.
Por que isso é importante
A principal conclusão do estudo é que não é a competição, mas a colaboração entre modelos que é produtiva. O ICD-Deepresearch mostra que a estatística médica estruturada e a busca agentiva por linguagem podem trabalhar na mesma cadeia: o dicionário CID define o enquadramento, fontes externas adicionam contexto, e as justificativas ajudam o médico a verificar o raciocínio.
Para a prática, isso significa uma previsão de diagnósticos mais precoce e explicável. O sistema não substitui a decisão clínica, mas reduz o risco de perder uma condição importante na consulta. E, assim, no futuro, essas ferramentas podem se tornar parte do assistente digital do médico — do planejamento de recursos aos processos de seguros.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Diagnóstico passo a passo de agentes GUI na análise de dashboards: benchmark DashAct
Apresentamos o DashAct — um benchmark com 348 trajetórias verificadas por humanos, que divide o trabalho de agentes GUI com painéis interativos em três etapas e quatro condições visuais. Os resultados revelam problemas persistentes na previsão de ações e na associação a alvos visuais, bem como a dependência das respostas dos agentes do suporte contextual e espacial.
11 novembro 2026
WILSON: integração de ampliações e lâminas de pacientes para análise anatomopatológica e elaboração de laudos
O preprint apresenta o WILSON — um modelo de visão e linguagem que codifica imagens de lâminas inteiras e séries de preparações de um mesmo paciente em diferentes ampliações, em vez de apenas uma lâmina «melhor». Sem ajuste fino para a tarefa, supera modelos especializados e maiores para lâminas em várias métricas, com uma carga computacional substancialmente menor, e as suas descrições diagnósticas receberam avaliações mais elevadas dos patologistas.
11 novembro 2026
Invariantes polinomiais canónicos no diagnóstico de falhas em simuladores de RL: onde são realmente úteis
O estudo avalia se a incorporação de leis físicas em modelos de dinâmica treináveis se justifica: os invariantes extraídos das trajetórias e reduzidos à forma canónica por meio de bases de Gröbner proporcionam ganhos modestos nas previsões, mas são eficazes no diagnóstico — permitem localizar a restrição violada e identificar o parâmetro específico incorreto.
10 novembro 2026