
Figure testou o Helix 2.5 em 30 casas: o robô concluiu totalmente 237 das 420 tarefas
O robô dobrava toalhas, fazia as camas e recolhia brinquedos em casas onde nunca tinha estado antes. Os testes mostraram que as competências se transferem para novos espaços, mas as 183 tarefas não concluídas e a avaliação dos resultados pela própria Figure ainda não permitem considerar o sistema pronto para limpar sem supervisão.
O que foi testado
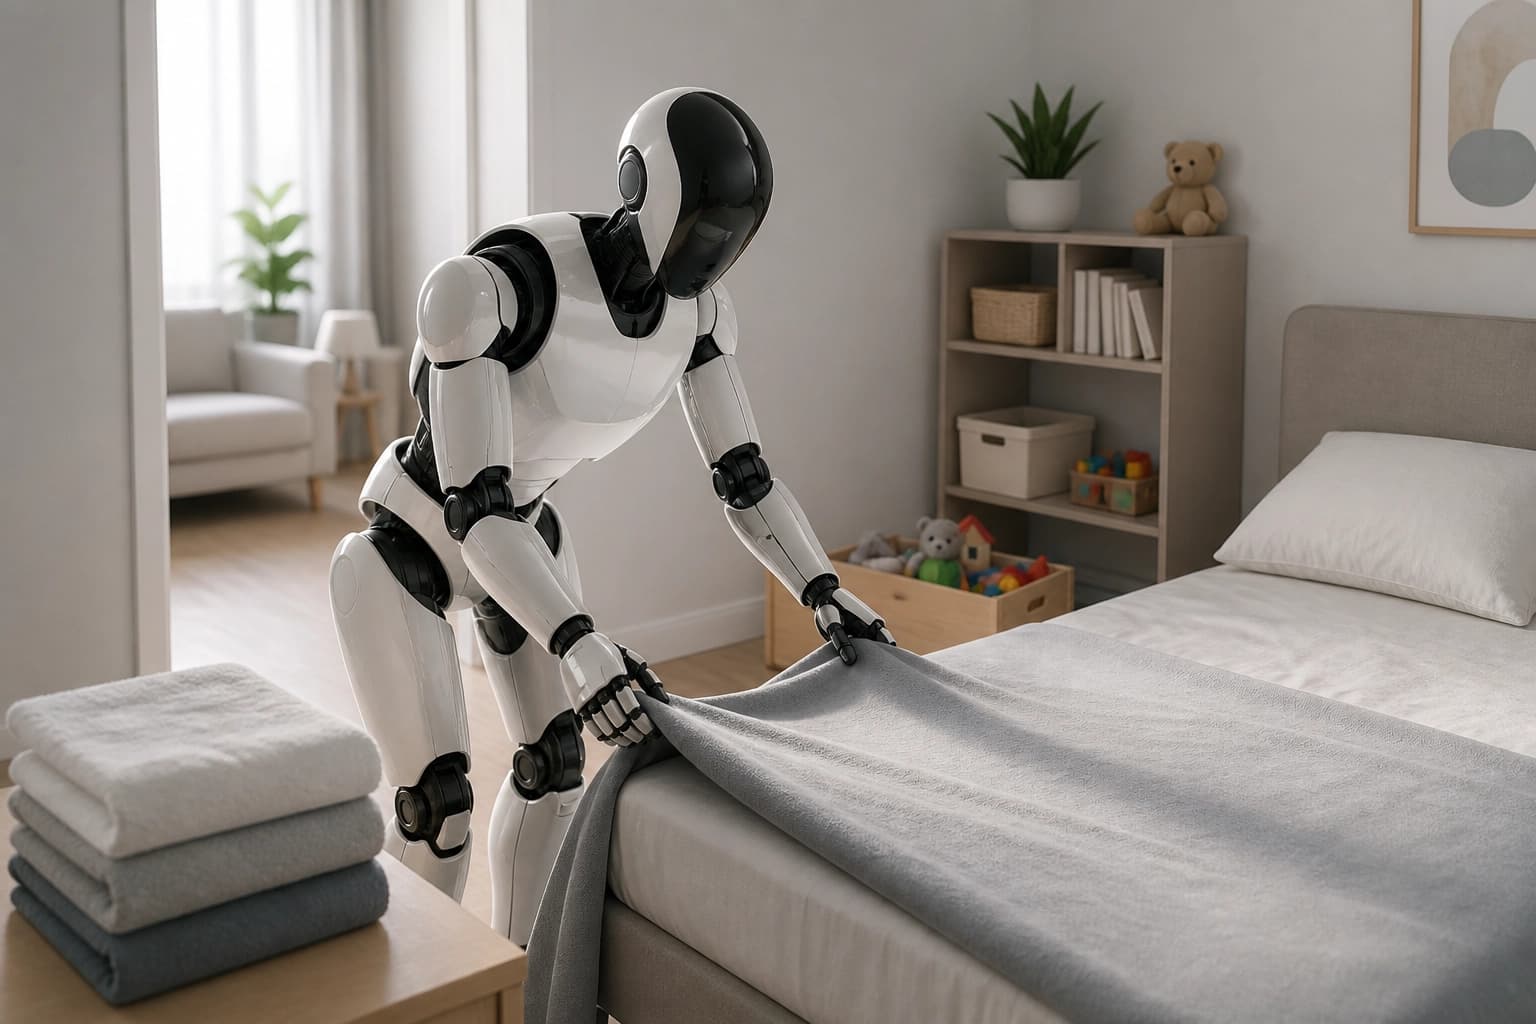
Em 30 casas desconhecidas na região da baía de San Francisco, Helix 2.5 realizou três tarefas: dobrar toalhas, fazer camas e apanhar brinquedos.
A Figure não tinha recolhido dados previamente nessas casas. Em todas as divisões foi utilizada a mesma versão do modelo: não foi treinada adicionalmente no local nem alterada após tentativas anteriores.
A empresa chamou à experiência zero-shot. As casas e os objetos eram novos, mas as tarefas em si não: o modelo tinha sido previamente treinado com gravações feitas noutras divisões.
Como foi contabilizado o sucesso
Os testes incluíram 420 tarefas. Não foram atribuídas pontuações parciais: o robô tinha de concluir a tarefa na totalidade.
- Brinquedos: arrumar os 13–15 objetos todos num cesto.
- Toalhas: dobrar todas as toalhas.
- Cama: colocar duas almofadas na cama, puxar os cantos superiores do edredão e alisá-lo.
Uma intervenção humana por motivos de segurança significava uma tentativa falhada. Por isso, a pontuação final reflete apenas as tarefas concluídas na totalidade sem esse tipo de intervenção.
Quantas tarefas o robô concluiu
Helix 2.5 concluiu na totalidade 237 das 420 tarefas. O melhor desempenho foi a fazer camas; o pior, a apanhar brinquedos.
| Tarefa | Tentativas bem-sucedidas | Taxa de sucesso |
|---|---|---|
| Fazer a cama | 94 em 140 | 67% |
| Dobrar toalhas | 87 em 140 | 62% |
| Apanhar brinquedos | 56 em 140 | 40% |
Para comparação, a Figure treinou um sistema com os mesmos dados especializados, mas partiu de parâmetros aleatórios, sem pré-treino no Index. Esta versão concluiu 35 das 420 tarefas. O gráfico da Figure indica 8%, enquanto o texto que o acompanha indica 9%.
O Index é um conjunto de dados da Figure com gravações de ações humanas. Os dados de cada uma das três tarefas representavam, no máximo, 1,9% desse conjunto.
O que os resultados dizem sobre a preparação para uso doméstico
A avaliação foi realizada pela própria Figure; ainda não houve uma reprodução independente dos resultados. A empresa também não indicou quando será lançada uma versão doméstica nem qual a frequência de falhas aceitável.
O robô não concluiu 183 das 420 tarefas. A Figure considera que, com este número de falhas, ainda é cedo para o deixar fazer a limpeza sem supervisão.
Para uma avaliação prática, não contam apenas os melhores resultados em tarefas específicas. O critério é a conclusão integral das tarefas sem intervenção humana; os testes publicados ainda não comprovam que esteja pronto para fazer a limpeza de forma autónoma.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Verificação de alucinações em LLMs com uma representação SQL das fontes, sem ajuste fino
Este trabalho avalia se uma LLM consegue recorrer a uma competência simbólica básica — construir uma base de dados SQL a partir de documentos de origem — para fundamentar as respostas nas fontes sem supervisão na deteção de alucinações. No RAGTruth e no DiaHalu, este pipeline neuro-simbólico revela-se mais preciso do que a previsão direta e comparável aos métodos mais avançados, sem exigir afinação específica ao domínio.
9 novembro 2026
MathAdv: o que esconde a precisão final das provas geradas por máquina
Um conjunto de tarefas de diagnóstico em 13 áreas da matemática de nível universitário e de pós-graduação avalia sistemas de demonstração automática em Lean 4 não só pelo resultado final, mas também pelo domínio da matéria, pela qualidade do raciocínio informal e pela robustez perante reformulações das condições. A análise por componente mostra que traduzir um problema para uma forma formal continua a ser o principal obstáculo, e que o sucesso depende muito da área da matemática e da forma como o problema é formulado.
9 novembro 2026
AffordanceWAM: affordances como intermediárias entre a previsão da cena e o controlo do manipulador
O trabalho descreve um modelo generativo que prevê simultaneamente observações RGB futuras, campos escalares, mapas de calor de affordances e comandos contínuos para o robô, usando vídeos humanos para ampliar a diversidade das interações sem anotações de ações nem retargeting. No RoboCasa, no CALVIN ABC→D e em tarefas reais, a abordagem apresenta ganhos consistentes em relação às linhas de base que usam apenas RGB e apenas dados robóticos.
9 novembro 2026