
Grafos em vez de sorte: como o GxP-Agent torna a programação de dados clínicos com LLM confiável
Analisamos um preprint em que cinco LLMs de ponta não conseguiram preparar um conjunto analítico válido para submissão regulatória, enquanto um sistema multiagente baseado em grafo acíclico direcionado com 15 nós especializados demonstra 100% de correspondência estrutural com o padrão de referência. Essa abordagem transforma a geração monolítica de código em uma sequência de etapas de domínio verificáveis.
Programação clínica: onde os LLMs tropeçam
Preparar dados de ensaios clínicos para submissão regulatória é um processo com requisitos rigorosos. Os protocolos precisam ser transformados em conjuntos de dados analíticos que cumpram as normas do CDISC, e qualquer erro aqui pode custar um atraso ou rejeição da aplicação. Por muito tempo, essa etapa permaneceu um gargalo: requer tanto conhecimento de domínio, precisão em código, quanto compreensão da lógica regulatória.
Quando se trata de gerar tal código com grandes modelos de linguagem, a imagem parece sombria. Em um experimento descrito em um preprint em arXiv, cinco modelos de fronteira foram dadas onze tentativas de tiro único para criar um conjunto de dados de nível de assunto válido - e nenhum foi bem sucedido. Não se trata de pequenas falhas, mas... sobre a inutilização completa do resultado. Os modelos parecem ignorar a própria estrutura do processo: eles tentam montar todo o oleoduto de uma só vez, sem verificações intermediárias ou uma compreensão de quais passos são obrigatórios e que dependem dos anteriores.
GxP-Agent: decomposição através de um gráfico de processo
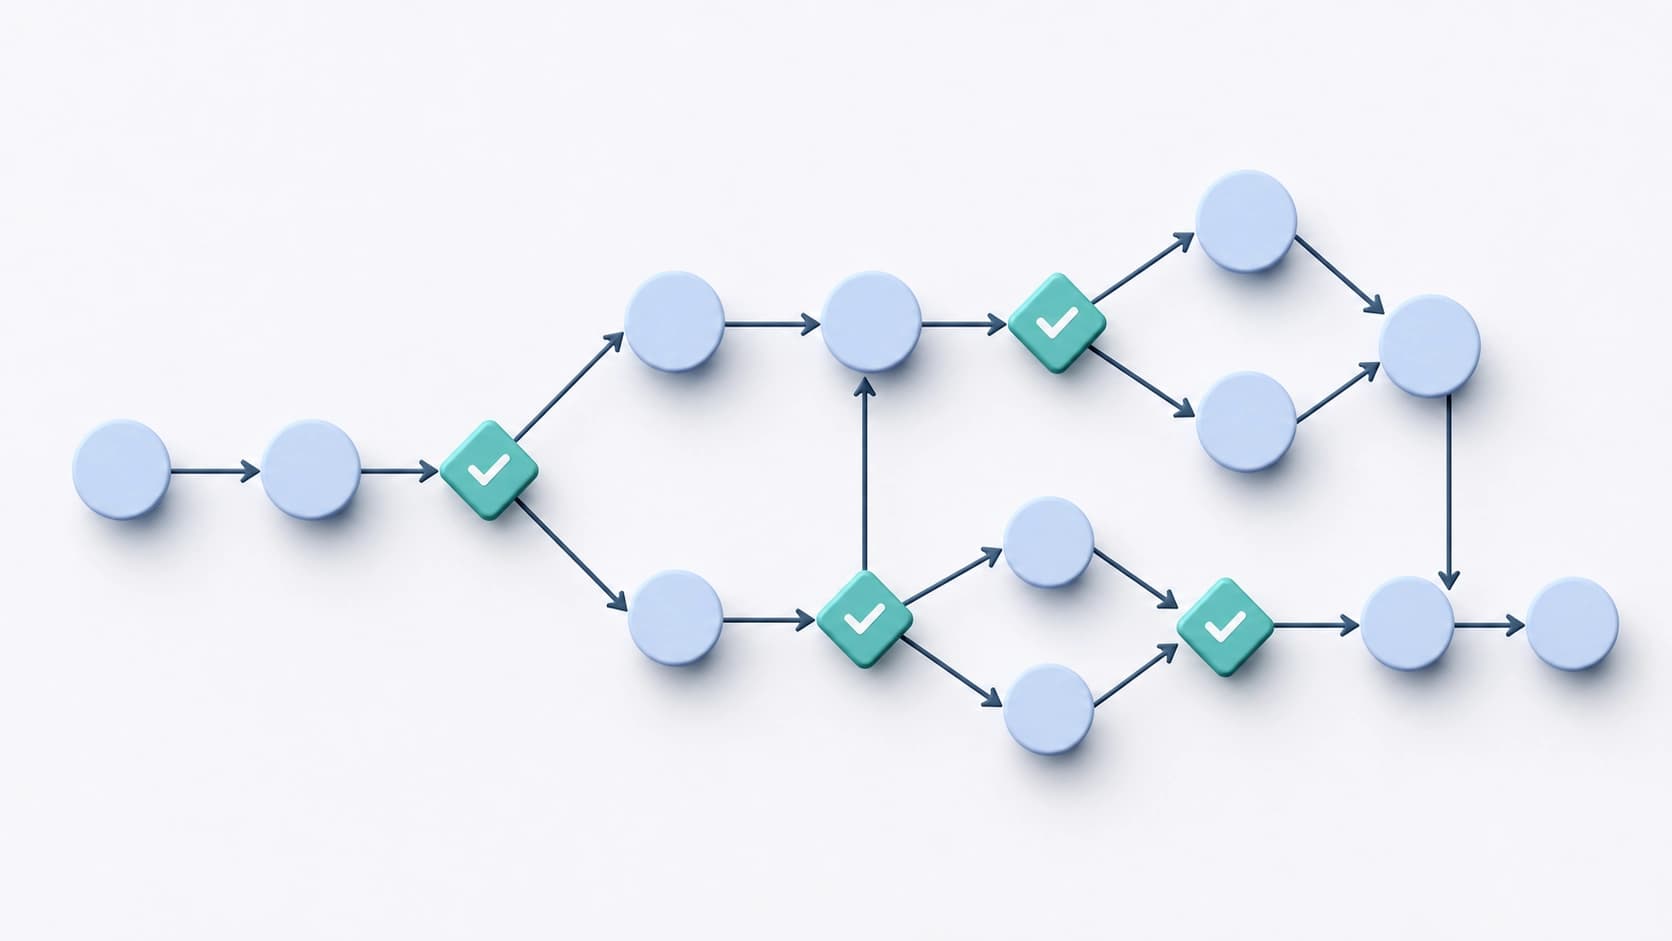
A resposta para esse problema foi o sistema multi-agente GxP-Agent. Sua ideia chave não é confiar na "razão" do modelo sobre como o processo regulatório funciona, mas para codificar esse processo explicitamente. A sequência regulatória das ações é representada como um gráfico acíclico direcionado (DAG). Em vez de geração monolítica de todo o conjunto de dados em uma etapa, a tarefa é dividida em 15 nós específicos de domínio. Cada nó é uma operação separada realizada por um agente trabalhador equipado com um contexto de habilidades do farmacoverso. Entre nós, há portões de validação, e as tentativas condicionais são fornecidas quando necessário.
Esta abordagem altera a própria natureza dos erros. Se o modelo se desviar do resultado esperado em algum nó, isso é detectado imediatamente, e o passo pode ser reiniciado em vez de refazer todo o pipeline. Em essência, o LLM deixa de ser um "gerador de tudo ao mesmo tempo" e torna-se um executor de subtarefas locais bem descritas. A topologia gráfica fornece uma estrutura rígida dentro da qual o modelo pode agir mais livremente.
O que isto parece na prática
Cada nó DAG é responsável por um domínio de dados específico, e o trabalhador não recebe uma tarefa abstrata como "build ADSL", mas uma tarefa estreita com entradas claras, saídas e critérios de validação. Se o resultado falhar na validação, uma repetição condicional é ativada — o agente recebe feedback e corrige o código. Isto assemelha-se a um loop "gerar — verificar — corrigir", mas incorporado na estrutura do grafo em vez de executado arbitrariamente.
Números no CDISC- Bench: de zero a cem
Para avaliar a efetividade da abordagem, os autores desenvolveram um benchmark baseado em execução chamado CDISC-Bench. É construído sobre a real submissão piloto da FDA — CDISCPilot01, que inclui 254 sujeitos e 49 variáveis ADSL de verdade terrestre. Tal benchmark verifica não apenas a sintaxe ou semântica do código, mas o resultado real de sua execução.
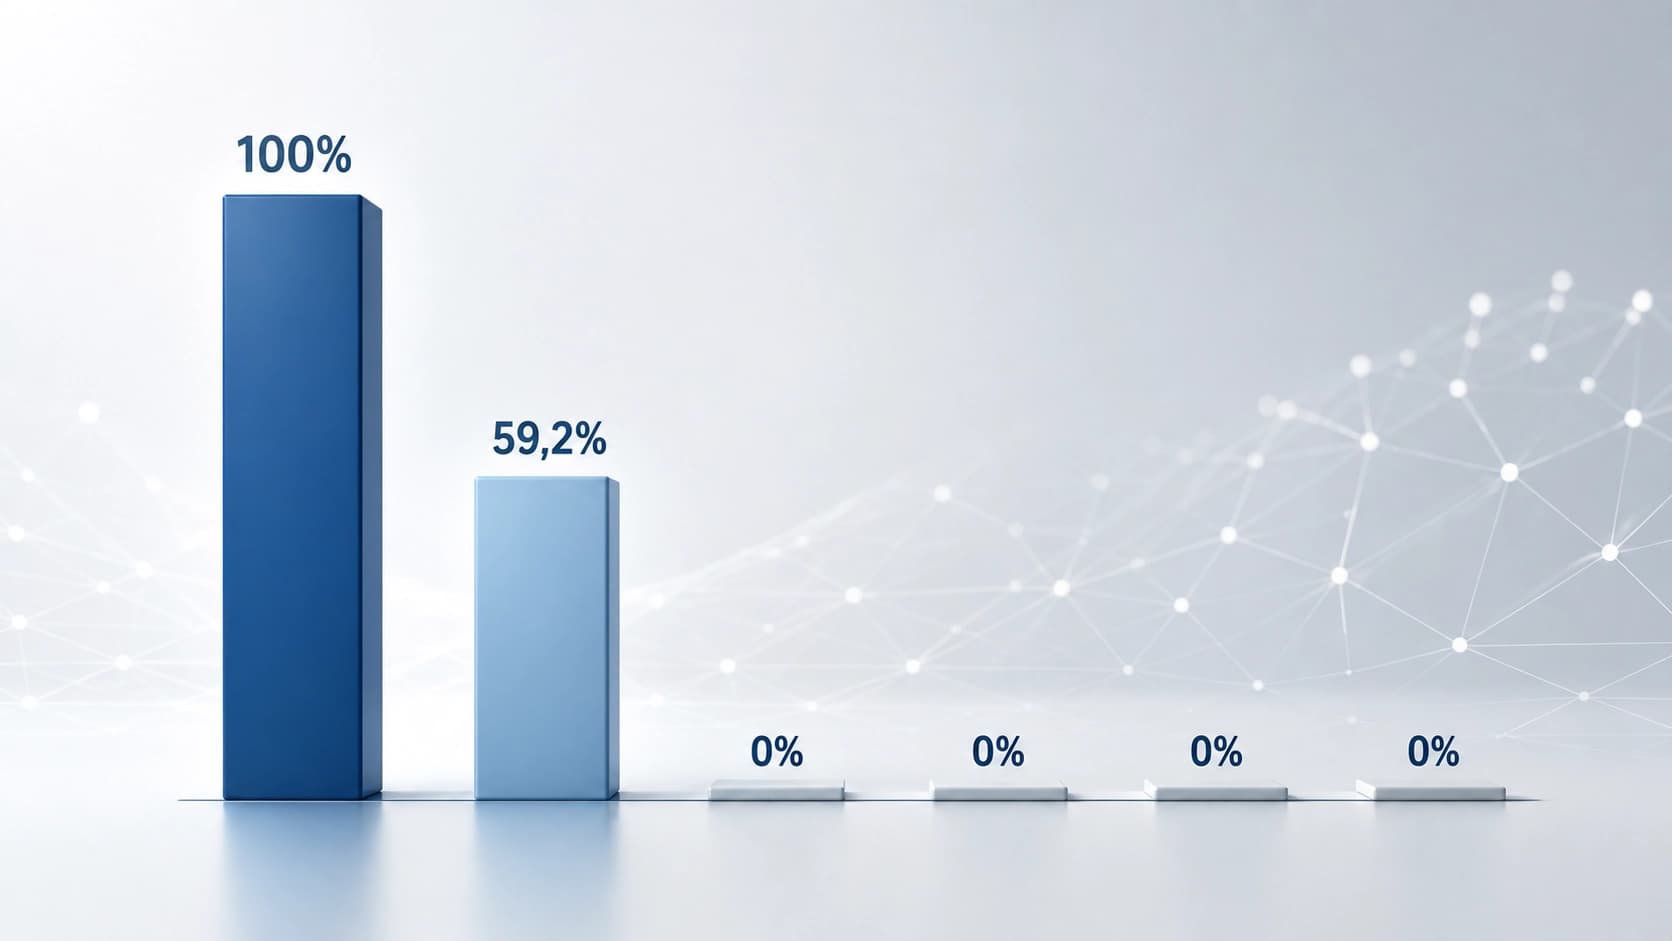
Aqui, GxP-Agent mostrou resultados impressionantes: com o modelo Claude Sonnet 4.6, obteve 100% de correspondência estrutural — todas as 49 variáveis e todos os 254 registros foram corretos em três corridas independentes. Para comparação, a melhor linha de base aumentada para recuperação parou em 59,2%, e todas as outras abordagens — agente único e multi- agente plano — obtiveram zero por cento. Em outras palavras, qualquer arquitetura sem topologia gráfica é simplesmente incapaz de lidar com tarefa.
Modelos mais fracos também beneficiam
Um efeito colateral interessante: a topologia DAG reduz os requisitos para o próprio modelo. Quando o GPT-4.1 foi utilizado como trabalhador no mesmo gráfico, a média de correspondência estrutural foi de 59,2% — o mesmo nível da linha de base aumentada pela recuperação em um modelo forte. Sem a estrutura do gráfico, GPT-4.1 apresentou resultado zero. Isso confirma que o papel decisivo é desempenhado não pelo poder de um modelo individual, mas pela forma como o processo é organizado.
Versatilidade da abordagem e conclusões
Os autores não se limitaram a um único domínio. O mesmo princípio foi aplicado ao conjunto de dados ADAE (eventos adversos) que utiliza um DAG ramificado de 9 nós, 55 variáveis e 1191 registros. Uma correspondência estrutural de 100% foi alcançada na primeira tentativa. Isso sugere que o método generaliza além do ADSL e é adequado para outros tipos de dados clínicos.
A principal saída do trabalho: a confiabilidade na programação clínica é alcançada não por meio do "raciocínio inteligente" das LLMs, mas por meio da codificação do conhecimento de domínio sobre o processo na forma de topologia gráfica. O modelo continua a ser um componente importante, mas não o único, do sistema. É o gráfico que define as restrições e a ordem, enquanto o modelo de linguagem o preenche com código concreto. Essa simbiose permite obter resultados compatíveis com o GxP que podem ser invocados em submissões regulatórias.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Invariantes polinomiais canónicos no diagnóstico de falhas em simuladores de RL: onde são realmente úteis
O estudo avalia se a incorporação de leis físicas em modelos de dinâmica treináveis se justifica: os invariantes extraídos das trajetórias e reduzidos à forma canónica por meio de bases de Gröbner proporcionam ganhos modestos nas previsões, mas são eficazes no diagnóstico — permitem localizar a restrição violada e identificar o parâmetro específico incorreto.
10 novembro 2026
AURA-Eval: como verificar se o agente de LLM reconheceu o risco e mudou o próximo passo
O framework avalia o comportamento de agentes LLM não pelo veredito final, mas pela reação ao risco em pontos-chave: as trajetórias de chamadas a ferramentas são interrompidas, após o que o modelo deve continuar o raciocínio e a ação, enquanto um painel de juízes LLM analisa a detecção de riscos, a natureza e a segurança da ação. Em 1.249 tarefas reunidas a partir de 157 trajetórias do R-Judge, as ações inseguras tornam-se mais frequentes entre 20 modelos quando não há um caminho seguro, e a remoção da supervisão antes da execução transforma 52,3% dos casos inicialmente seguros em casos inseguros.
10 novembro 2026
Memória do reservatório de Chern–Simons: dinâmica autónoma de conectividade e transporte de densidade
O artigo analisa como um reservatório preserva o histórico dos sinais de entrada simultaneamente na distribuição de densidade e nos graus de liberdade geométricos. A comparação de quatro mecanismos mostra que a corrente cria uma componente de conectividade separada, que altera a resposta subsequente da densidade, e que considerar todas as características medidas proporciona um pequeno ganho na descodificação da ordem dos impulsos.
10 novembro 2026