
Recompensa verificável e seu ponto cego
O aprendizado por reforço baseado em recompensas verificáveis tornou-se uma receita habitual para modelos de linguagem: há uma tarefa com resposta inequivocamente verificável — matemática, código, perguntas com resposta curta — e há um sinal de "resolveu / não resolveu". O esquema funciona, mas tem uma fraqueza conhecida. A recompensa final avalia o resultado como um todo, não o caminho até ele. O modelo pode receber pontuação por uma conclusão correta construída sobre premissas inventadas e, da mesma forma, perder pontos por um raciocínio correto com uma formulação final malsucedida.
É exatamente aqui que mora o risco de alucinações. Se a recompensa depende apenas da correspondência final, a política não tem incentivo para ser cuidadosa ao longo do caminho — basta adivinhar a resposta. Uma das formas de corrigir isso é adicionar controle factual no nível do processo: verificar afirmações intermediárias, não apenas o resultado final.
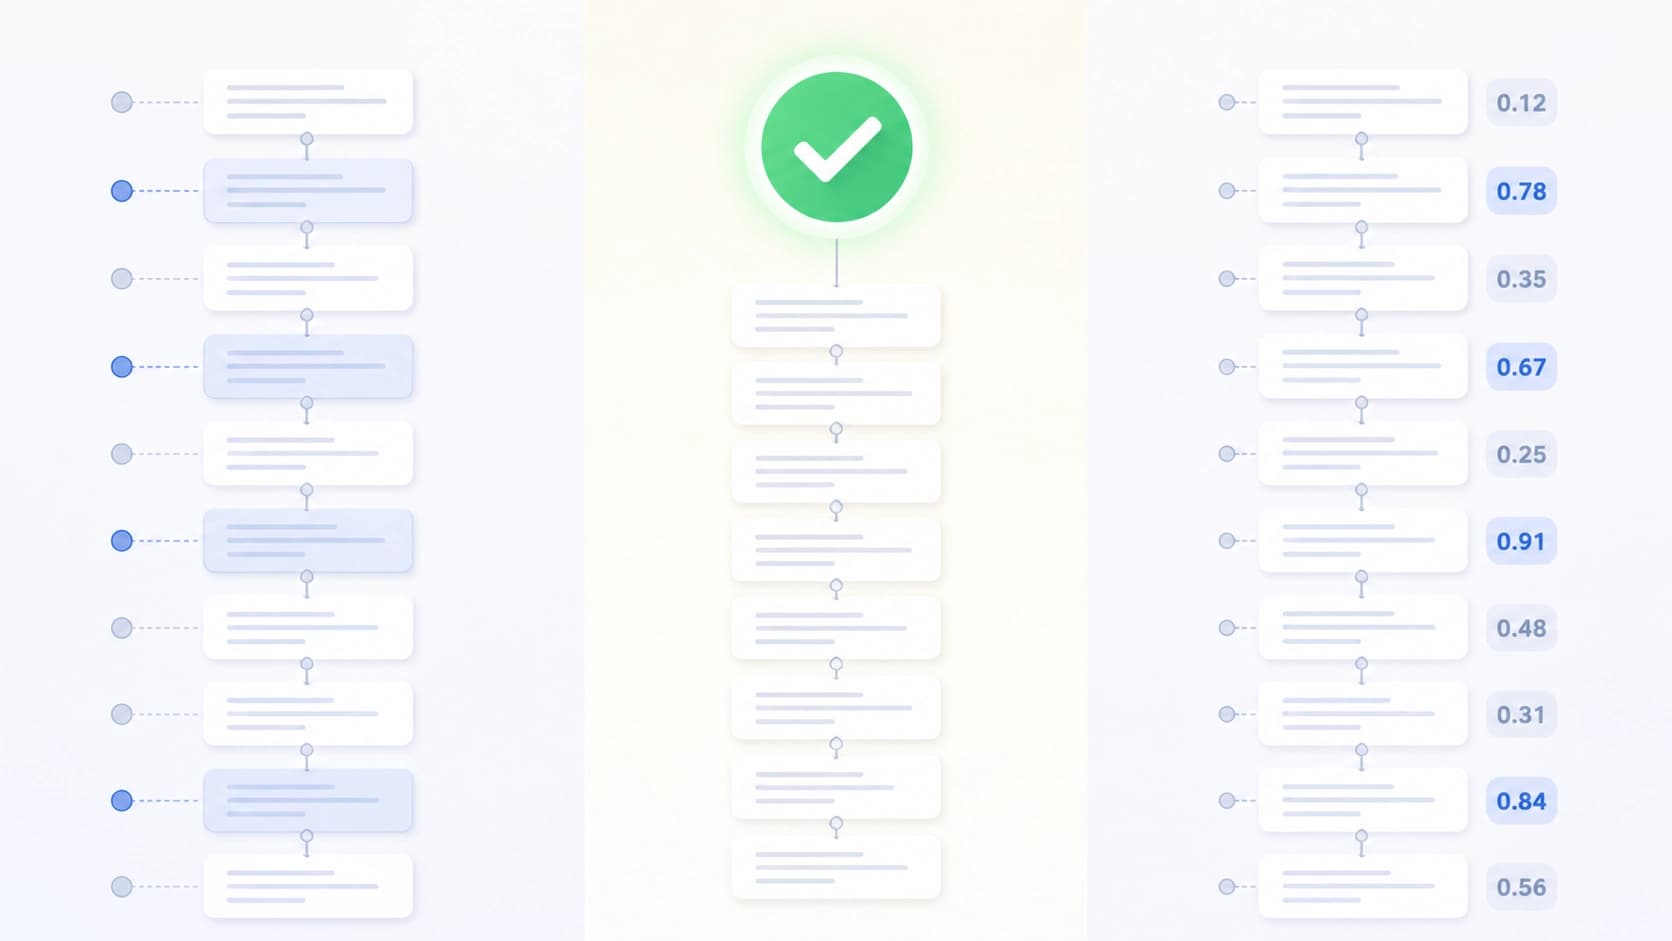
Mas a abordagem em nível de processo revela um problema próprio. As verificações de fatos são coletadas e calculadas de forma agregada: o sinal chega em bloco para todo o fragmento, e a confiabilidade das próprias verificações não é avaliada por ninguém. Como resultado, surge uma lacuna entre o que foi realmente verificado e o que foi realmente atualizado na política.
Duas ambiguidades em vez de um problema
Os autores do trabalho arXiv:2608.24350 (Qiming Xie, Wenjie Zheng, Xiangqing Shen, Rui Xia) dão a essa lacuna um nome — "atribuição de crédito factual ruidosa" (noisy factual credit assignment) — e a decompõem em dois aspectos independentes.
- Ambiguidade na localização do crédito. Não está claro a qual token ou fragmento exatamente atribuir o mérito ou a culpa. O fato foi verificado no nível da frase, mas a atualização ocorre no nível do token — as granularidades não coincidem, e o sinal se dilui.
- Ambiguidade na confiabilidade do crédito. Não está claro o quanto a própria verificação merece confiança. Alguns juízos factuais são confiáveis e reproduzíveis, outros são frágeis, dependem do contexto ou de uma formulação específica. Sem um peso de confiança, eles entram no treinamento em pé de igualdade.
O segundo aspecto é o mais subestimado. Os esquemas habituais de tratamento de sinais factuais se comportam como se todas as verificações tivessem a mesma qualidade. Na prática, não é assim, e verificações fracas começam a prejudicar a otimização tanto quanto as fortes.
Como o FARCA é estruturado
FARCA significa Fact-Aligned Reliability-Aware Credit Assignment — atribuição de crédito alinhada a fatos e ciente de sua confiabilidade. Não é um novo modelo nem um dataset, mas um framework de otimização de política: ele reestrutura a forma como o controle factual se transforma em sinal de treinamento.
Alinhar as granularidades
O primeiro passo é a localização de crédito em granularidade fina. A ideia é simples na formulação e não trivial na implementação: a granularidade da verificação de fatos precisa ser alinhada à granularidade das atualizações de política. Assim, o sinal factual não chega "como uma média para toda a resposta", mas é vinculado a tokens específicos que realmente respondem por aquela afirmação. Em vez de uma média difusa, a política recebe indicações pontuais.
Avaliar o quanto a verificação merece confiança
O segundo passo são os pesos de confiabilidade. Para calculá-los, os autores introduzem a atribuição contrafactual de evidências (counterfactual evidence attribution): observam o quanto o juízo factual depende do fragmento-chave de evidência. Se remover ou substituir essa evidência e o veredito mudar — significa que a verificação realmente se apoia nela, e esse sinal merece mais confiança. Se o veredito permanece o mesmo independentemente da evidência, o juízo provavelmente não é sobre o que pensamos — e seu peso cai.
Os pesos obtidos então modulam as recompensas factuais e as vantagens locais da política. O sentido prático: sinais potencialmente não confiáveis recebem menos voz na atualização, em vez de serem totalmente bloqueados. É uma filtragem suave em vez de uma eliminação rígida — a política não perde informação, mas deixa de segui-la cegamente.
O que os experimentos mostram
Os autores testaram a abordagem em diferentes modelos e vários benchmarks que avaliam o raciocínio factual. O resultado declarado é um aumento notável da factualidade mantendo as capacidades gerais de raciocínio. A última parte aqui é tão importante quanto a primeira: melhorias em factualidade frequentemente são compradas ao custo da degradação de outras habilidades, quando o modelo se torna mais cauteloso e ao mesmo tempo mais fraco. Aqui, segundo os dados dos autores, isso não acontece.
Vale destacar separadamente que o método permanece no paradigma de RL com recompensas verificáveis — ele não exige abandonar o pipeline existente nem substituí-lo por algo fundamentalmente diferente. Ele se integra como uma camada entre a verificação de fatos e a atualização da política.
O que se conclui disso
A ideia principal do trabalho é mais ampla do que uma arquitetura. A discussão sobre a factualidade dos modelos geralmente segue a lógica de "verificar ou não verificar". Mas quando as verificações já existem, a questão-chave se desloca: como exatamente seu resultado se transforma em aprendizado. Um erro nessa junção não parece um erro, parece um ruído comum de treinamento — e por isso facilmente passa despercebido.
Reconhecer que as fontes não são igualmente confiáveis parece quase trivial ao nível do bom senso. Mas nos esquemas de aprendizado por reforço isso ainda é raro: os sinais se acumulam num caldeirão comum, e a diferença entre uma evidência confiável e um palpite aleatório se apaga. FARCA é uma tentativa de trazer essa diferença de volta à fórmula. O quanto a abordagem se mostrará transferível para além de tarefas com resposta verificável, onde o fato não pode ser tão facilmente confirmado ou refutado, é uma questão em aberto — e também a direção mais interessante para trabalhos futuros.


