Problema: o modelo é testado onde não é mais preciso procurar
Uma lâmina histológica é uma imagem de gigapixels. Para dar um diagnóstico, o patologista primeiro examina a amostra em pequeno aumento, destaca as áreas suspeitas, depois as observa de perto, compara o quadro em diferentes escalas e só então formula a conclusão. Uma parte substancial desse trabalho não é gasta em observar, mas em procurar: onde, afinal, vale a pena olhar.
A maioria dos benchmarks existentes para IA em patologia retira essa parte do trabalho do modelo. Na entrada é fornecido ou um patch previamente recortado, ou características já extraídas da lâmina — ou seja, alguém já decidiu de antemão o que é importante ali. O modelo recebe evidências prontas e demonstra habilidade de raciocinar sobre elas. Mas quão bem ele obtém evidências por conta própria — isso permanece quase sem ser testado.
É justamente para essa lacuna que aponta o trabalho EviPathBench. Seus autores são Dankai Liao, Tianyi Zhang, Yufeng Wu, Xinyue Zhang, Qiaochu Xue, Zeyu Liu, Dachun Zhao, Linghan Cai e Yueming Jin; o preprint apareceu no arXiv em 21 de julho de 2026 e, em 25 de agosto, já chegava à quarta versão (arXiv:2607.19261, cs.CV / cs.AI). Essa frequência de revisões por si só sugere: os autores consideram o tema vivo e controverso.
Como o benchmark está estruturado
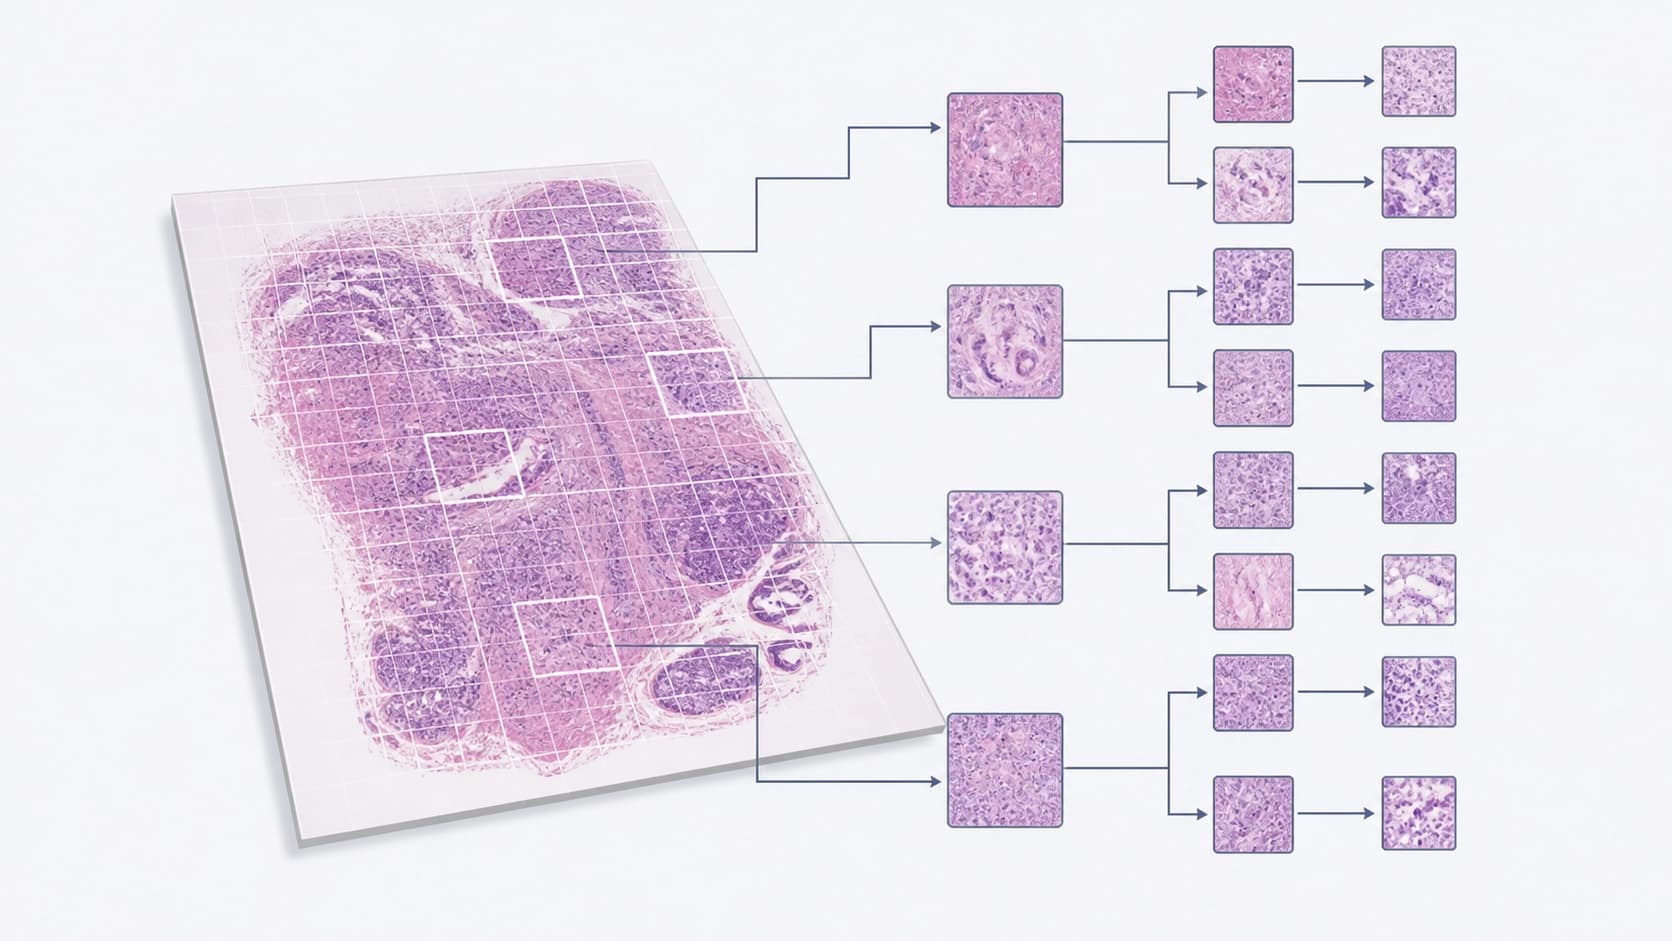
O EviPathBench não é construído como um conjunto de perguntas separadas com alternativas de resposta, mas como uma árvore diagnóstica. Regiões aninhadas umas nas outras em diferentes ampliações estão ligadas a achados específicos de cada escala e, no fim, a um diagnóstico no nível de laudo patológico. Exige-se do modelo não apenas emitir o rótulo "câncer", mas percorrer uma cadeia: encontrar a região, descrever o achado nessa ampliação, subir um nível, conciliar os dados entre escalas e reuni-los em uma conclusão geral.
Quatro capacidades verificáveis
Os autores decompuseram a habilidade de trabalhar com a lâmina em componentes e avaliam cada uma separadamente:
- Correspondência entre imagem e texto — interpretação da evidência, quando o modelo relaciona o que vê com a descrição.
- Consulta textual à imagem (retrieval) — verificação: a partir da formulação, é preciso localizar na lâmina o fragmento correspondente.
- Localização da região diagnóstica — a própria coleta de evidências: onde exatamente procurar.
- Raciocínio em múltiplos níveis — integração dos achados obtidos em diferentes ampliações em um quadro único.
Essa divisão é valiosa por si só: ela mostra que "compreender a lâmina" não é uma única capacidade, mas várias, e que elas podem divergir muito entre si.
Dados e anotação
A base foi composta por 1.822 WSIs do TCGA e 17.135 caminhos diagnósticos, anotados por dez patologistas certificados. Separadamente, utiliza-se uma coorte privada de 190 lâminas de câncer de mama com anotações detalhadas — ela serve para testar justamente a exploração autônoma de toda a amostra, sem dicas sobre onde está a zona de interesse.
Resultados: raciocinar dá certo, procurar não
Na avaliação participaram 19 modelos "visão-linguagem" — universais, médicos e especializados em patologia — mais um modelo textual de referência, necessário como ponto de partida.
O quadro ficou contrastante. Os melhores modelos abertos ultrapassam 93% de acurácia no raciocínio em múltiplos níveis e mais de 50% em ambas as tarefas de correspondência cross-modal. À primeira vista, tudo bem.
Mas com a localização da região diagnóstica — é um problema. O melhor resultado em text-guided mean IoU não chega nem a 0,09. Isso é pior do que uma heurística simples, que coloca um retângulo no centro da lâmina, sem analisar absolutamente nada. Em outras palavras, o modelo treinado para olhar o tecido procura pior do que um programa que não olha para lugar nenhum.
A escala quebra a busca
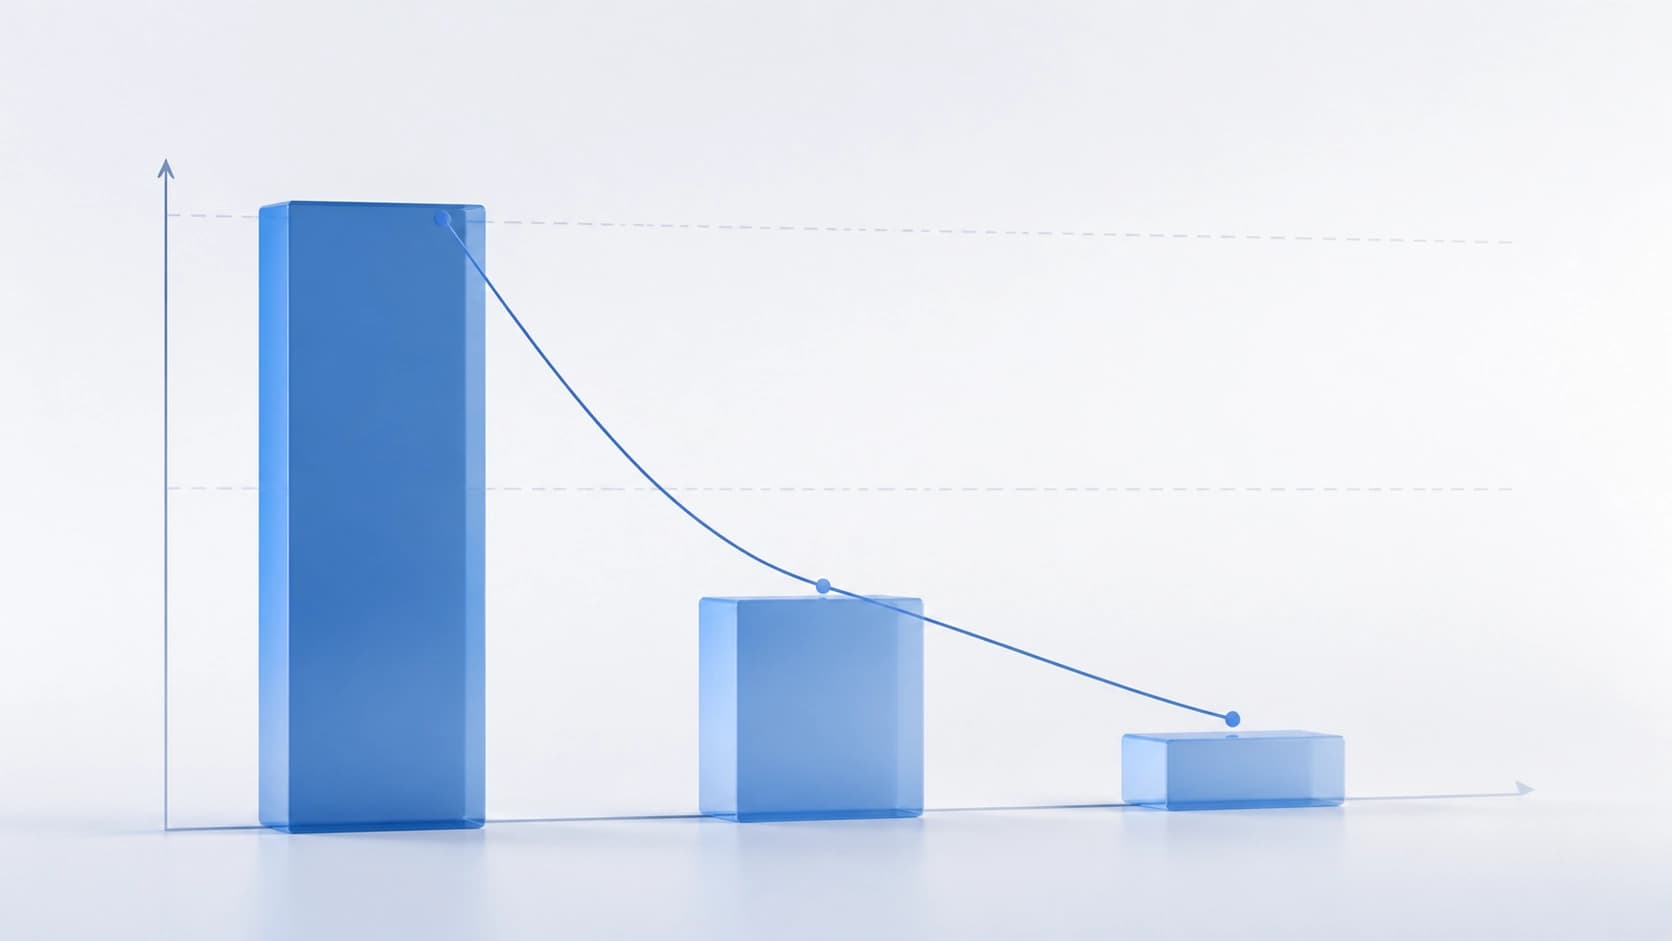
Uma linha separada do experimento é a exploração autônoma da lâmina. Aqui a hit rate absoluta despenca conforme o aumento cresce: 0,522 no pequeno, 0,185 no médio e 0,020 no grande. A lógica da queda é clara: no pequeno aumento, o modelo vê a arquitetura geral do tecido e facilmente acerta "em alguma zona correta", mas quanto maior o zoom, mais estreito o campo de visão e mais caro cada erro no passo anterior. Os deslizes se acumulam e, na ampliação máxima, o modelo quase certamente olha para o lugar errado.
O que se conclui disso
A principal conclusão do trabalho formula-se de modo simples: entre a habilidade de raciocinar sobre evidências preparadas e a habilidade de obter essas evidências há um abismo profundo. A primeira os modelos modernos já fazem razoavelmente bem; a segunda, quase não conseguem.
Para a prática, isso significa que a navegação pela lâmina ainda não pode ser deixada a cargo do modelo "por conta própria" esperando um resultado clinicamente significativo. Por outro lado, o próprio benchmark oferece um framework comum: com ele é possível medir ambas as capacidades e verificar se uma melhoria específica — aprendizado por reforço, memória entre passos de zoom, busca hierárquica — ajuda a avançar na parte que falha.
Vale também ter em mente as ressalvas. A coorte privada é limitada ao câncer de mama, e a maior parte dos dados são materiais retrospectivos do TCGA, ou seja, a variabilidade clínica real não está totalmente representada ali. As métricas de localização são sensíveis à forma como exatamente foram anotados os limites das regiões, e as quatro versões do preprint em um mês indicam que os números ainda podem ser refinados.