
OnzeLabs do zero: registro, configuração e primeiros passos em texto para fala
Passo a passo, passamos por criar uma conta, escolher um plano e escolher uma voz da biblioteca. Em seguida, mostramos como gerar vozes, ajustar a expressão emocional e usar recursos como clonagem de voz e dublagem para projetos.
Registo e login
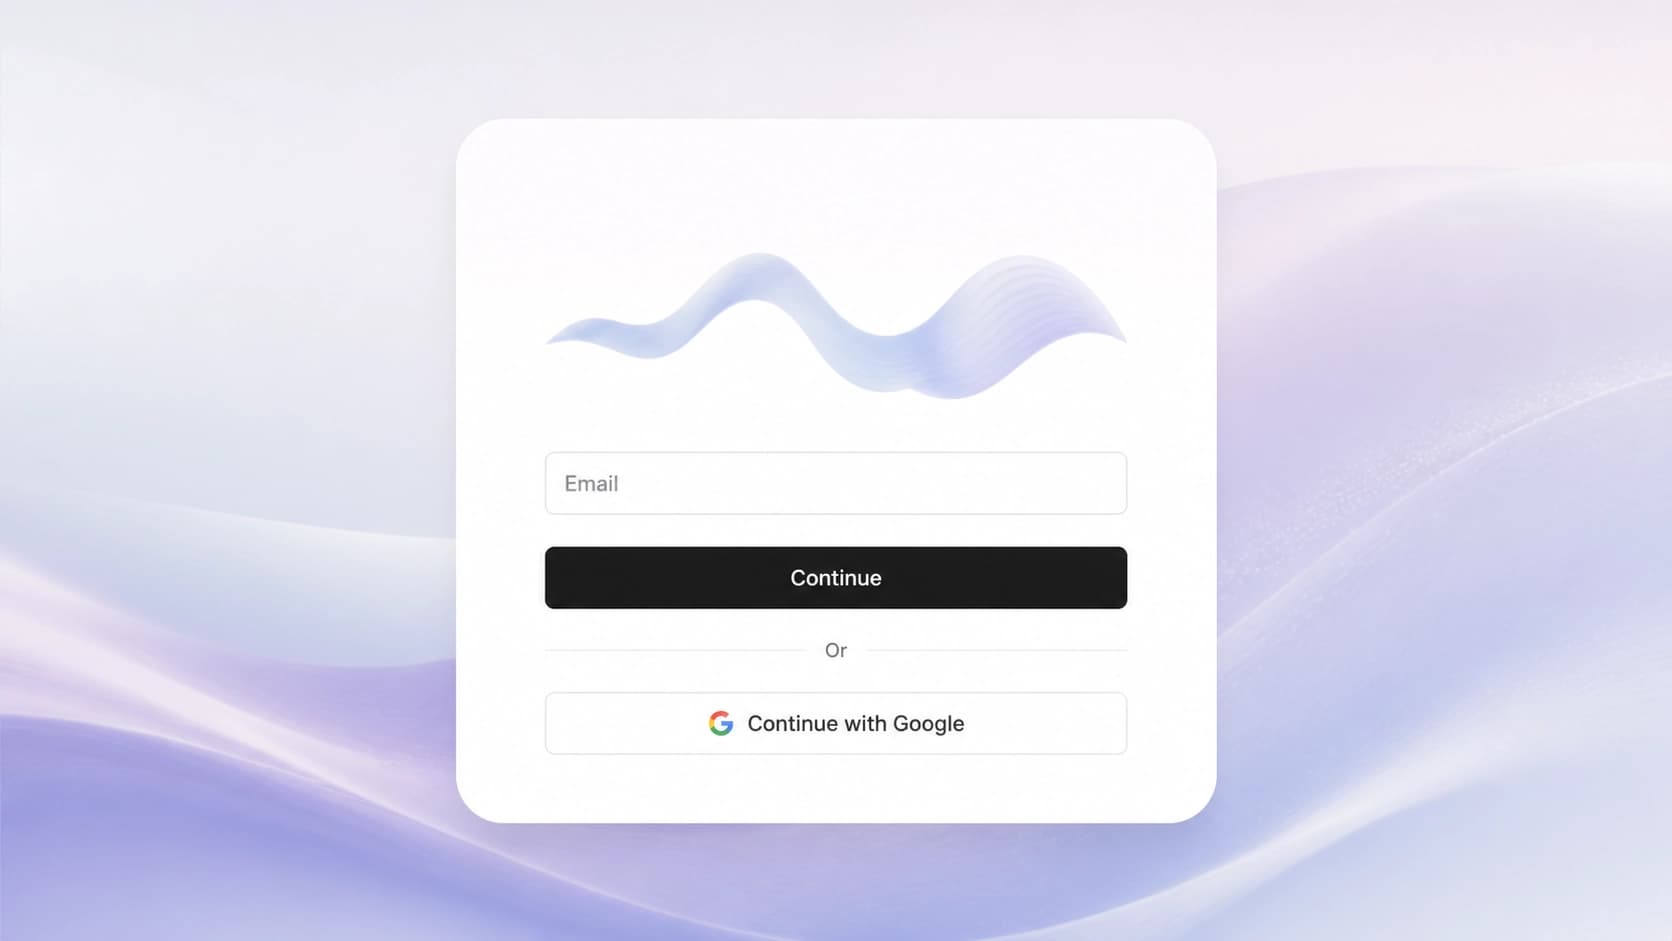
Para começar a trabalhar com ElevenLabs, abra o site oficial do serviço e clique em "Tente de graça" ou "Inscreva-se" na página inicial. A maneira mais fácil de se registrar é através do Google OAuth — então você não terá que lembrar de outra senha. Se preferir o método clássico, digite seu endereço de e-mail e crie uma senha; o sistema enviará um e-mail com um link de confirmação para sua caixa de entrada. Siga esse link — e só então sua conta é considerada ativa.
Depois de confirmar, chegará ao seu painel pessoal. Você pode explorar imediatamente as seções principais: geração de voz, projetos, dublagem e outros recursos integrados. Nesta fase, você não precisa configurar nada — o serviço oferecerá uma breve turnê introdutória por conta própria.
Escolher um plano de preços e configuração inicial
Depois de entrar, vale a pena decidir um plano. ElevenLabs tem um plano gratuito que é adequado para narrações de teste, bem como assinaturas pagas a partir de Starter e indo para a Enterprise. No plano livre, o limite mensal de caracteres e o acesso a alguns recursos são geralmente restritos, de modo que para o trabalho regular é melhor passar para uma camada paga adequada.
Em seguida, vá para a Voice Library — uma biblioteca de vozes prontas criadas pela comunidade e pela própria empresa. Lá você pode escolher uma voz por sexo, idade , sotaque, ou estilo de falar. Preste atenção aos filtros: eles ajudam a estreitar a busca se você estiver procurando, por exemplo, uma voz masculina calma para instruções ou uma voz feminina energética para um comercial.
Nesta fase, também é útil verificar as configurações de síntese de fala. O parâmetro chave é a estabilidade — a barra de estabilidade. Se você colocá-lo alto, a voz vai soar estável e previsível, mas vai perder alguma flexibilidade emocional. Um baixo valor acrescenta vivacidade e variedade de entonação, mas às vezes leva a mudanças inesperadas timbre. O valor ideal depende da tarefa: os audiolivros geralmente precisam de estabilidade, enquanto os diálogos precisam do oposto.
Criando sua primeira narração
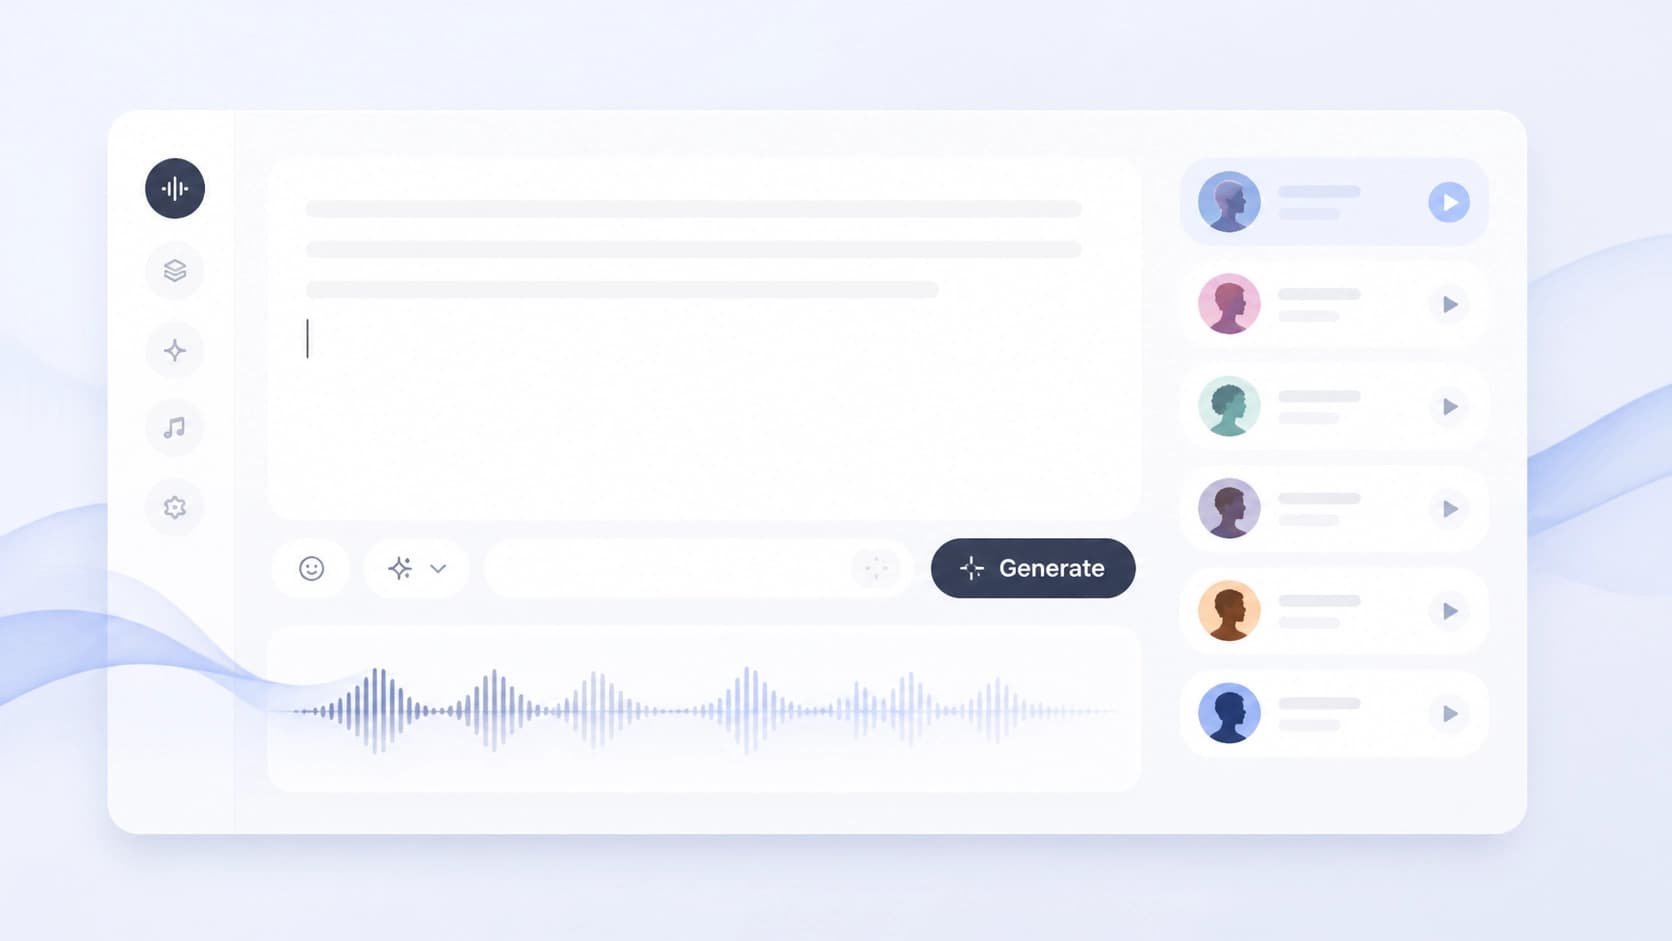
Uma vez que sua conta é configurada e uma voz é selecionada, você pode seguir em frente para a coisa principal — gerando fala do texto. Na ElevenLabs editor, cole seu texto no campo dedicado, escolha uma voz que você gosta na biblioteca e clique em Gerar. Em poucos segundos, o sistema retornará um arquivo de áudio acabado que você pode ouvir diretamente no navegador ou baixar.
Se você quiser ter um personagem único, use a ferramenta de design de voz integrada. Permite configurar as características de voz "do zero": gênero, idade, timbre e até mesmo características de pronúncia. Isso é conveniente para criadores de conteúdo que precisam de uma voz consistente para uma série, podcast ou vídeo blog.
Usuários avançados devem prestar atenção ao Dubbing Studio. Este recurso é projetado para projetos multilingues: traduz e vozes vídeos para outras línguas, tentando preservar a entonação original e tom emocional. O serviço também tem Audio Native — um plugin para sites que reproduz automaticamente uma versão de áudio de artigos de texto.
Dicas práticas para um começo confiante
Os principiantes têm muitas vezes perguntas sobre quotas e qualidade. Para evitar que seu trabalho seja interrompido no pior momento possível, fique de olho no contador de caracteres em seu painel pessoal. In ElevenLabs, os limites de nível livre são bastante modestos, então para projetos longos é melhor mudar para um plano pago com antecedência ou espalhar a geração ao longo dos dias.
Não tenha medo de experimentar com diferentes modelos de voz. O mesmo texto pode soar completamente diferente dependendo do modelo e configurações escolhidos. Execute algumas gerações de testes com o mesmo texto e compare os resultados — esta é a maneira mais rápida de entender qual som combina com o seu projeto.
Se algo der errado — a voz soa distorcida, o texto é lido muito rápido ou muito lento — olhe para a Central de Ajuda. Lá você encontrará instruções para corrigir problemas comuns, recomendações para otimizar configurações e respostas a perguntas frequentes. Também é útil estudar exemplos de outros usuários na Voice Library: o trabalho de outras pessoas mostra quais parâmetros definir para alcançar o efeito desejado.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Anotação híbrida de imagens: a automatização acelera o treino de modelos de visão por computador
O artigo descreve como a pré-anotação por algoritmos reduz o trabalho manual e melhora a qualidade dos conjuntos de dados de treino, bem como por que motivo a verificação por amostragem humana continua a ser necessária. São abordadas as limitações do método em condições difíceis de captura e em tipos de objetos raros.
5 novembro 2026
Método GoldiMask para o ajuste fino de modelos de linguagem de difusão: seleção de contexto e ponderação dos alvos
O trabalho apresenta o GoldiMask — uma abordagem de ajuste fino supervisionado para modelos de linguagem com difusão discreta, que seleciona tokens visíveis por meio da maximização aproximada de uma função submodular e atribui pesos aos objetivos restantes com base na sua utilidade para o treino. As experiências com vários modelos e conjuntos de dados demonstram um aumento da precisão média, ganhos em tarefas de raciocínio lógico e programação, bem como menos iterações de descodificação paralela no GSM8K e no MATH-500, com qualidade semelhante.
30 outubro 2026
Transformers adicionou suporte à execução de modelos GGUF quantizados no Apple Silicon
O artigo descreve a integração do formato GGUF do llama.cpp no Transformers: inferência local no Mac, carregamento de modelos através da API da biblioteca e execução de um servidor compatível com a OpenAI. Com o exemplo do Qwen3.5-4B, mostra como a escolha do nível de quantização afeta o tamanho dos pesos e os requisitos de memória.
18 outubro 2026